5 Varianzanalysen
“To find out what happens to a system when you interfere with it you have to interfere with it (not just passively observe it).” — George Box (1966)
In diesem Kapitel lernen Sie die Familie der Varianzanalysen kennen, das klassische Werkzeug zur Auswertung von Experimenten. Im Kapitel zur multiplen Regression haben wir gesehen, dass die einfaktorielle Varianzanalyse nichts anderes ist als eine Regression auf Dummy-Variablen. Hier bauen wir auf dieser Einsicht auf. Wir beginnen mit der Idee der Varianzzerlegung, die dem Verfahren seinen Namen gibt, und damit, wie man nach einem signifikanten F-Test herausfindet, welche Gruppen sich unterscheiden. Dann besprechen wir Fälle, bei denen mehrere Einflussfaktoren gleichzeitig betrachtet werden und mit ihnen die Interaktionen, mit deren Hilfe man auch Moderationseffekte untersuchen kann. Die Kovarianzanalyse (ANCOVA) ergänzt das Modell um eine Kovariate, die Varianzanalyse mit Messwiederholung berücksichtigt, dass dieselben Personen/Pinguine mehrfach gemessen werden. Beides führt uns zu einer Frage, die in der angewandten Forschung ständig auftaucht: Wie wertet man eine Studie aus, in der zwei Gruppen vor und nach einer Intervention gemessen werden, und wie berechnet man dort eine Effektstärke? Zum Schluss des konzeptuellen Teils geht es um die Fallzahlplanung. Wie in den vorigen Kapiteln zeigt die zweite Hälfte, wie Sie all das in R umsetzen.
5.1 Die Idee der Varianzzerlegung
Die Varianzanalyse (analysis of variance, ANOVA) wurde in den 1920er-Jahren von Ronald Fisher (1925) für im wahrsten Sinne des Wortes Feldversuche mit Gemüse auf dem Acker entwickelt. Er musste herausfinden, ob sich die Erträge von Parzellen, die mit verschiedenen Düngern behandelt wurden, unterscheiden? Der Name Varianzanalyse ist auf den ersten Blick verwirrend, denn sie testet Unterschiede zwischen Mittelwerten. Sie tut das aber, indem sie die Varianz der Daten in Anteile zerlegt.
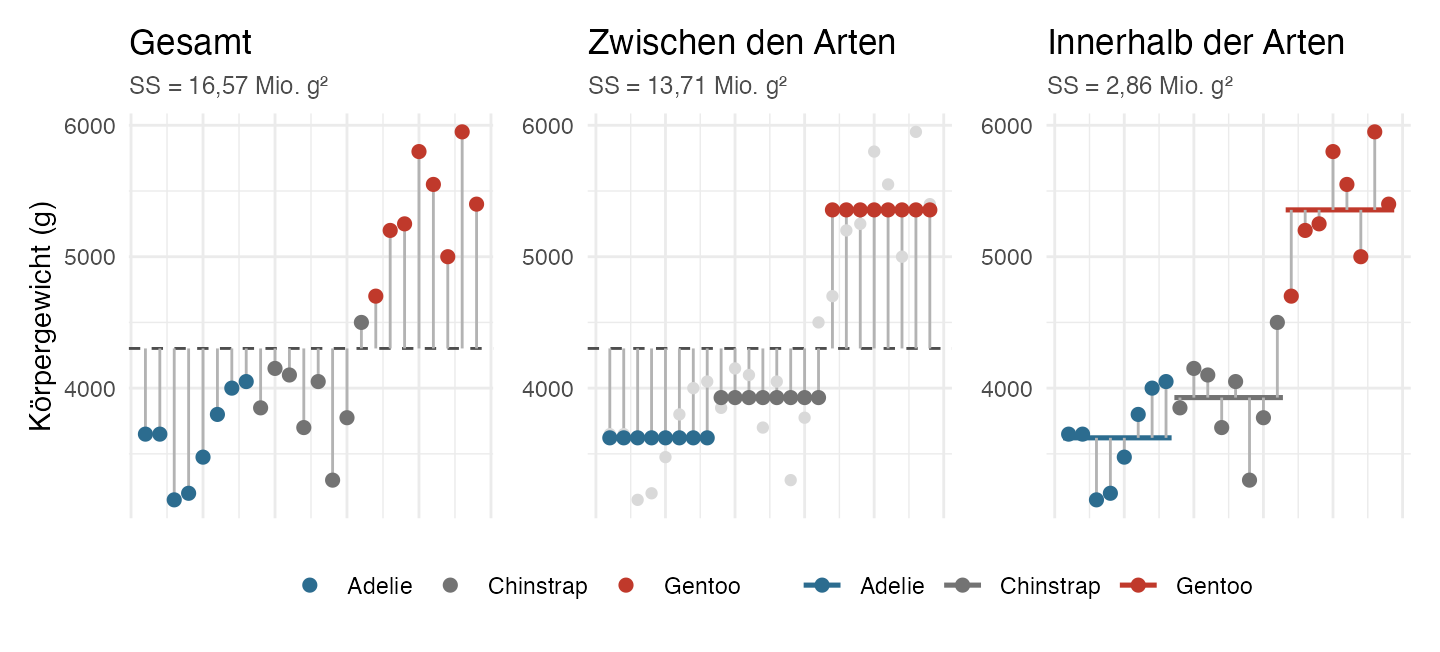
Nehmen wir als Beispiel wieder das Körpergewicht der drei Pinguinarten. Die Werte der einzelnen Tiere weichen mehr oder weniger stark vom Gesamtmittelwert aller Tiere ab (Abbildung 5.1, links). Wenn man die einzelnen Abweichungen der einzelnen Pinguine quadriert und aufsummiert, erhält man einen Wert für die Varianz des Körpergewichts (aka eine Quadratsumme QS). Diese Abweichung lässt sich in zwei Teile aufteilen: die Abweichung des Gruppenmittelwerts vom Gesamtmittelwert, die auf die Art zurückgeht, und die Abweichung des einzelnen Tiers von seinem Gruppenmittelwert, die die Art nicht erklären kann (Abbildung 5.1, rechts). Quadriert und über alle Fälle summiert, gilt für diese Quadratsummen:
\[ \underbrace{\sum_{j}\sum_{i} (y_{ij} - \bar y)^2}_{\text{QS}_\text{gesamt}} = \underbrace{\sum_{j} n_j (\bar y_j - \bar y)^2}_{\text{QS}_\text{zwischen}} + \underbrace{\sum_{j}\sum_{i} (y_{ij} - \bar y_j)^2}_{\text{QS}_\text{innerhalb}} \]
Sie kennen diese Zerlegung aus dem Regressionskapitel: \(\text{QS}_\text{zwischen}\) ist die durch das Modell erklärte Quadratsumme, \(\text{QS}_\text{innerhalb}\) die Residuenquadratsumme.
Teilt man die Quadratsummen durch ihre Freiheitsgrade, erhält man mittlere Quadratsummen (mean squares, MS). Ihr Verhältnis ist die Prüfgröße der Varianzanalyse, der F-Wert:
\[ F = \frac{\text{MS}_\text{zwischen}}{\text{MS}_\text{innerhalb}} = \frac{\text{QS}_\text{zwischen} / (k - 1)}{\text{QS}_\text{innerhalb} / (N - k)} \]
Dabei ist \(k\) die Zahl der Gruppen und \(N\) die Gesamtstichprobe. Gilt die Nullhypothese, dass alle Gruppenmittelwerte gleich sind, sollten beide Quadratsummen gleich groß sein, und \(F\) liegt um 1. Je größer die Unterschiede zwischen den Gruppen im Verhältnis zur Streuung innerhalb der Gruppen, desto größer wird \(F\).
Effektstärken. Der Anteil der erklärten Quadratsumme an der Gesamtquadratsumme heißt \(\eta^2\) (Eta-Quadrat) und ist in der einfaktoriellen ANOVA nichts anderes als das \(R^2\) der entsprechenden Regression. Wie das \(R^2\) überschätzt \(\eta^2\) den Anteil in der Population leicht; das weniger verzerrte \(\omega^2\) (Omega-Quadrat) korrigiert dafür, ähnlich wie das korrigierte \(R^2\). In mehrfaktoriellen Designs berichtet man meist das partielle \(\eta^2_p = \text{QS}_\text{Effekt} / (\text{QS}_\text{Effekt} + \text{QS}_\text{Fehler})\), das die Varianz der übrigen Faktoren herausrechnet. Weil es damit vom Design abhängt, lässt es sich schlecht zwischen Studien vergleichen; das generalisierte \(\eta^2_G\) wurde entwickelt, um dieses Problem zu lösen (Lakens, 2013).
5.1.1 Nach dem F-Test: Kontraste und Post-hoc-Tests
Ein signifikanter F-Test sagt nur, dass sich irgendwelche Gruppen unterscheiden, nicht aber welche. Dafür gibt es zwei Wege.
Geplante Kontraste. Hat man vor der Datenerhebung spezifische Hypothesen, kann man diese gezielt als Kontraste prüfen, indem man gewichte beschreibt, die diesen Kontrasten entsprechen. Die Hypothese „Gentoo-Pinguine sind schwerer als die beiden anderen Arten“ entspricht etwa den Gewichten \((-\tfrac12, -\tfrac12, 1)\) für Adelie, Chinstrap und Gentoo. Geplante Kontraste sind der eleganteste Weg, genau die Frage zu beantworten, die man hat. Streng genommen braucht man dann nicht einmal den F-Test.
Post-hoc-Tests. Hat man keine spezifischen Hypothesen, muss man alle Paare von Gruppen miteinander vergleichen. Bei \(k\) Gruppen sind das \(k(k-1)/2\) Vergleiche, bei fünf Gruppen also schon zehn. Führt man jeden mit \(\alpha = .05\) durch, steigt die Wahrscheinlichkeit, mindestens einen Fehler erster Art zu begehen, deutlich über 5 %. Post-hoc-Tests korrigieren diese Inflation des Alpha-Fehlers dafür: Der Tukey-Test ist speziell für alle paarweisen Vergleiche gemacht, die Holm-Korrektur ist ein allgemeines und stets besseres Verfahren als die bekannte, aber zu strenge Bonferroni-Korrektur.
5.2 Mehrfaktorielle Varianzanalyse und Interaktionen
In einem Experiment interessiert oft nicht nur ein Faktor. Angenommen, ein Unternehmen testet ein neues Kommunikationstraining und möchte wissen, ob es bei erfahrenen und unerfahrenen Führungskräften gleich gut wirkt. Das Design hat dann zwei Faktoren mit je zwei Stufen (Bedingung: Kontrolle vs. Training; Erfahrung: gering vs. hoch), also vier Zellen. Ein solches 2X2 Design wertet man typischerweise mit einer zweifaktoriellen Varianzanalyse aus. Diese kann drei Effekte prüfen, die jeweils für unterschiedliche Fragn stehen:
- Den Haupteffekt der Bedingung: Unterscheiden sich Training und Kontrolle, gemittelt über beide Erfahrungsstufen?
- Den Haupteffekt der Erfahrung: Unterscheiden sich erfahrene und unerfahrene Führungskräfte, gemittelt über beide Bedingungen?
- Die Interaktion: Hängt der Effekt der Bedingung von der Erfahrung ab?
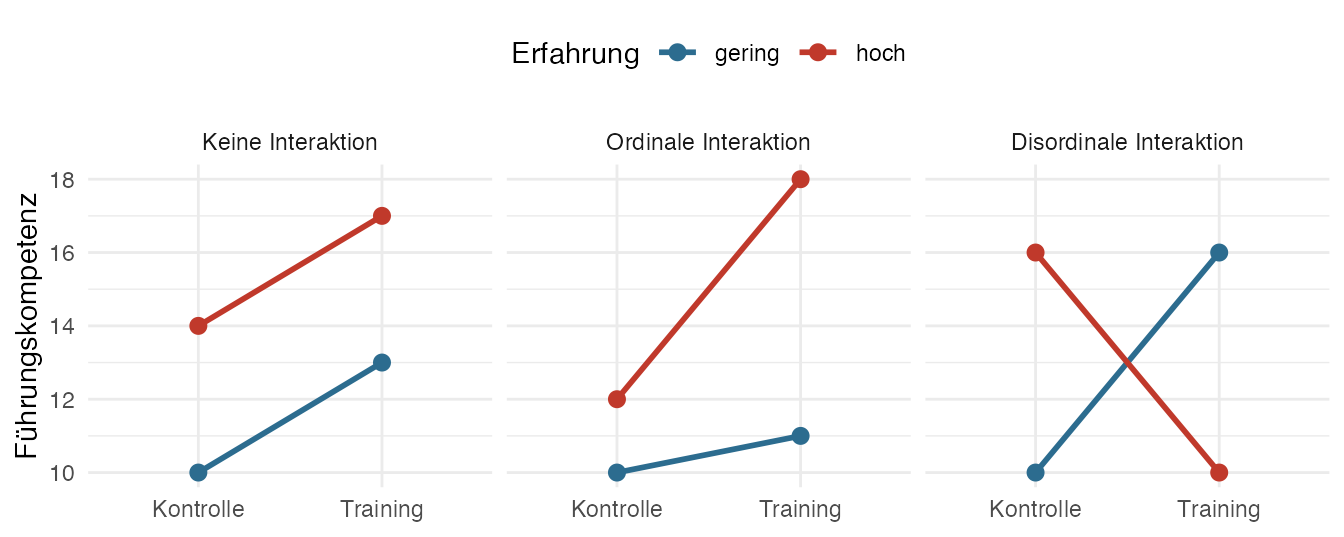
Die Interaktion ist oft die interessanteste der drei Fragen. Abbildung 5.2 zeigt die drei typischen Muster. Verlaufen die Linien parallel, gibt es keine Interaktion: Das Training wirkt bei beiden Gruppen gleich stark. Bei einer ordinalen Interaktion wirkt es in beiden Gruppen in dieselbe Richtung, aber unterschiedlich stark. Bei einer disordinalen (hybriden oder gekreuzten) Interaktion kehrt sich der Effekt der Intervention zwischen den erfahrenen und weniger erfahrenen Mitarbeitern sogar um.
Interaktionen als Produktterme. Im Regressionsmodell ist eine Interaktion schlicht das Produkt zweier Prädiktoren. Mit zwei Dummy-Variablen \(A\) und \(B\) lautet das Modell
\[ y_i = \beta_0 + \beta_1 A_i + \beta_2 B_i + \beta_3 (A_i \cdot B_i) + \varepsilon_i. \tag{5.1}\]
Der Koeffizient \(\beta_3\) gibt an, um wie viel sich der Effekt von \(A\) verändert, wenn \(B\) von 0 auf 1 wechselt, er ist eine Differenz von Differenzen. Daraus folgt eine Warnung, die viele Anwenderinnen überrascht: Sobald eine Interaktion im Modell ist, ist \(\beta_1\) kein Haupteffekt mehr, sondern der Effekt von \(A\) an der Stelle \(B = 0\), also nur in der Referenzgruppe. Man nennt das einen einfachen Effekt (simple effect).
WarnungKodierung und Typen von Quadratsummen
Ob die Koeffizienten und Tests für die „Haupteffekte“ das bedeuten, was man erwartet, hängt von zwei technischen Entscheidungen ab.
Erstens von der Kodierung der Faktoren. Bei der in R voreingestellten Dummy-Kodierung (contr.treatment) beziehen sich die Koeffizienten der Haupteffekte auf die Referenzgruppe des jeweils anderen Faktors. Bei der Effektkodierung (contr.sum, Werte \(-1\) und \(+1\)) beziehen sie sich auf den Mittelwert über alle Stufen des anderen Faktors, und das ist es, was typischerweise eher unter einem Haupteffekt versteht.
Zweitens, in Designs mit ungleichen Zellbesetzungen, gibt es unterschiedliche Möglichkeiten (aka Typen) die einzelnen Quadratsummen innerhalb und zwischen für die verschiedenen Faktoren zu berechnen. R berechnet standardmäßig Typ-I-Quadratsummen, die sequenziell sind. Das bedeutet, dass die Quadratsummen eines Faktors davon abhängen, an welcher Stelle er in der Formel steht. Es gibt aber auch sog. Typ-III -Quadratsummen, die jeden Effekt für alle anderen adjustieren und mit Effektkodierung die klassischen Haupteffekte testen. Welcher Typ vorzuziehen ist, wird seit Jahrzehnten diskutiert (Fox, 2016; Maxwell et al., 2018). Für die Praxis genügt: Bei balancierten Designs spielt es keine Rolle; bei unbalancierten sollten Sie wissen, welchen Typ Ihre Software verwendet, und ihn berichten.
Interaktionen sind deutlich schwerer als Haupteffekte zu schätzen. Weil eine Interaktion eine Differenz von Differenzen ist, beruht jede der beiden Differenzen nur auf der Hälfte der Stichprobe. In einem 2 × 2-Design mit gleich großen Zellen ist der Standardfehler der Interaktion deshalb doppelt so groß wie der eines Haupteffekts (vgl. Gelman et al., 2020). Dadurch benötigt man 4-mal soviele Teilnehmer um einen gleich.großen Interaktions wie Haupteffekt zu schätzen. Ist die Interaktion zusätzlich nur halb so groß wie der Haupteffekt, was bei ordinalen Interaktionen realistisch ist, benötigt man die 16-fache Stichprobe, um sie mit derselben Teststärke nachzuweisen. Viele publizierte Interaktionseffekte beruhen auf Studien, die dafür viel zu klein waren.
5.2.1 Interaktionen mit kontinuierlichen Prädiktoren: Moderation
Nichts an Gleichung 5.1 setzt voraus, dass \(A\) und \(B\) Dummy-Variablen sind. Ist einer der beiden Prädiktoren kontinuierlich, etwa die Arbeitsbelastung \(x\), und der andere eine Gruppenvariable wie die Teilnahme an einem Resilienztraining \(z\), dann beschreibt \(\beta_3\), um wie viel sich die Steigung von \(x\) zwischen den Gruppen unterscheidet. Man sagt, \(z\) moderiert den Zusammenhang zwischen \(x\) und \(y\) (Aiken & West, 1991): Hängt das Stresserleben bei trainierten Beschäftigten weniger stark von der Arbeitsbelastung ab als bei untrainierten, ist das Training ein Moderator. Sind beide Prädiktoren kontinuierlich, gilt dasselbe, nur dass sich die Steigung von \(x\) dann kontinuierlich mit \(z\) verändert.
Für die Interpretation gelten zwei Regeln. Erstens sollte man kontinuierliche Prädiktoren vor der Bildung des Produktterms zentrieren (den Mittelwert abziehen). Der Koeffizient von \(x\) ist dann die Steigung bei einem durchschnittlichen Wert von \(z\), statt bei \(z = 0\), was oft gar nicht vorkommt. Am Test der Interaktion ändert die Zentrierung nichts, aber es macht die Haupteffekte leichter zu interpretieren. Zweitens interpretiert man eine signifikante Interaktion über einfache Steigungen (simple slopes): die Steigung von \(x\) in jeder Gruppe beziehungsweise bei ausgewählten Werten von \(z\), etwa eine Standardabweichung unter und über dem Mittelwert. Eine Abbildung der Regressionsgeraden für die verschiedenen Werte des Moderators ist dabei fast immer aufschlussreicher als eine Tabelle.
5.3 Kovarianzanalyse (ANCOVA)
Nimmt man in eine Varianzanalyse zusätzlich einen kontinuierlichen Prädiktor auf, spricht man von einer Kovarianzanalyse (analysis of covariance, ANCOVA), und den kontinuierlichen Prädiktor nennt man Kovariate. Das Modell ist eine gewöhnliche multiple Regression:
\[ y_i = \beta_0 + \beta_1 \cdot \text{Gruppe}_i + \beta_2 x_i + \varepsilon_i \tag{5.2}\]
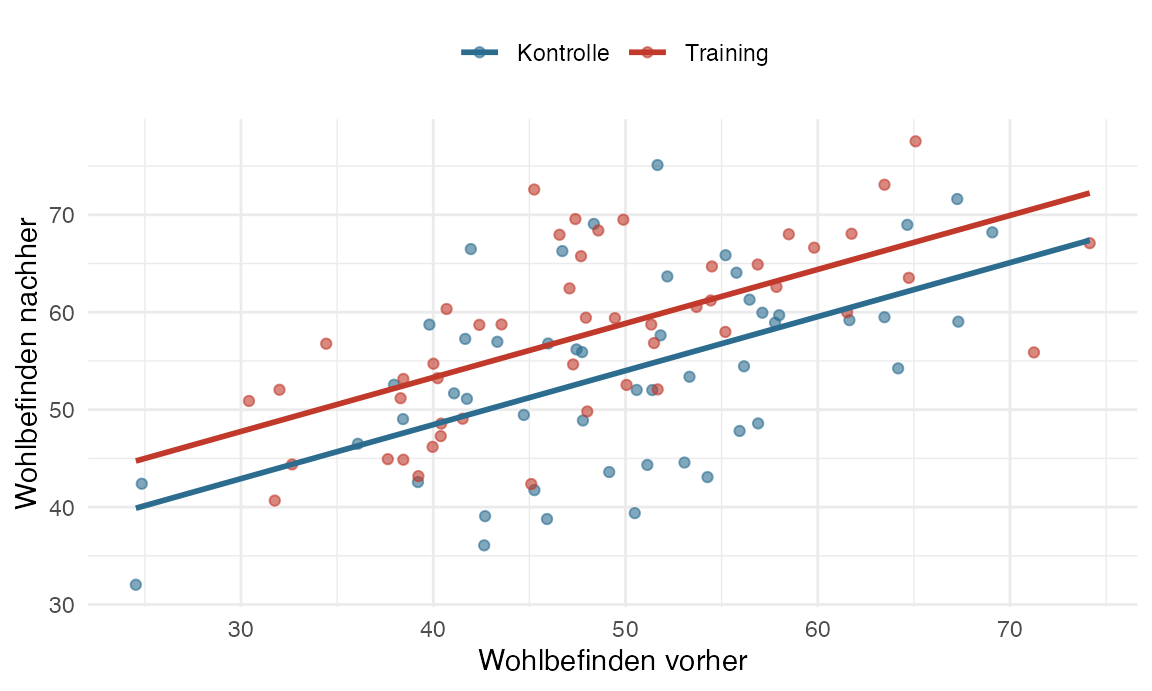
Der Koeffizient \(\beta_1\) ist die Differenz der Gruppen bei gleichem Wert der Kovariate. Grafisch ist das der vertikale Abstand zwischen zwei parallelen Regressionsgeraden (Abbildung 5.3). Die Gruppenmittelwerte, die das Modell für einen mittleren Wert der Kovariate vorhersagt, heißen adjustierte Mittelwerte (estimated marginal means).
Die ANCOVA hat, je nach Studiendesign, zwei ganz unterschiedliche Funktionen.
In randomisierten Experimenten erhöht die Kovariate die Power, d.h. sie macht es wahrscheinlicher, dass man einen bestehenden Effekt auch per Signifikanztest als solchen erkennt. Da die Gruppen durch die Zufallszuweisung im Mittel gleich sind, verändert die Kovariate den erwarteten Gruppeneffekt nicht. Sie erklärt aber einen Teil der Fehlervarianz: Korreliert die Kovariate innerhalb der Gruppen zu \(\rho\) mit dem Kriterium, schrumpft die Fehlervarianz ungefähr um den Faktor \(1 - \rho^2\). Bei \(\rho = .6\) sind das 36 % weniger Fehlervarianz, was der Teststärke einer um gut die Hälfte größeren Stichprobe entspricht. Die Kovariate muss dafür vor der Intervention gemessen worden sein; eine Kovariate, die selbst von der Intervention beeinflusst wird, kann den Effekt verzerren.
In nicht randomisierten Studien soll die Kovariate dagegen Unterschiede zwischen den Gruppen „herausrechnen“. Das ist weitaus heikler. Gruppen, die sich in einer Kovariate unterscheiden, unterscheiden sich meist auch in vielen anderen Merkmalen, und Messfehler in der Kovariate führen dazu, dass die Adjustierung unvollständig bleibt (Miller & Chapman, 2001).
Die ANCOVA setzt voraus, dass die Geraden parallel sind (Homogenität der Regressionssteigungen). Das lässt sich prüfen, indem man die Interaktion Gruppe × Kovariate ins Modell aufnimmt. Ist sie deutlich, ist der Gruppeneffekt nicht mehr eine fixe Zahl, sondern hängt vom Wert der Kovariate ab. Die Kovariate ist eine Moderatorvariable.
5.4 Varianzanalyse mit Messwiederholung
In vielen psychologischen Studien werden dieselben Personen mehrfach gemessen: vor und nach einer Intervention, unter verschiedenen experimentellen Bedingungen oder zu mehreren Zeitpunkten. Die Messungen einer Person sind dann nicht unabhängig voneinander. Die Ergebnisse einer gewöhnlichen ANOVA wären damit falsch. Die Varianzanalyse mit Messwiederholung (repeated measures ANOVA, rmANOVA) nutzt diese Abhängigkeit zu ihrem Vorteil. Sie zerlegt die Varianz innerhalb der Bedingungen noch einmal in zwei Teile: die stabilen Unterschiede zwischen Personen (manche Menschen haben generell ein höheres Wohlbefinden als andere) und die Restvarianz. Nur die Restvarianz geht in den Fehlerterm des F-Tests für den Messwiederholungsfaktor ein. Weil stabile Personenunterschiede in der Psychologie meist einen großen Teil der Varianz ausmachen, haben Messwiederholungsdesigns oft eine erheblich höhere Power als Designs, in denen jede Person nur einer Bedingung ausgesetzt wird.
Sphärizität. Die rmANOVA hat eine zusätzliche Voraussetzung: Die Varianzen aller paarweisen Differenzen zwischen den Messzeitpunkten müssen gleich sein. Bei nur zwei Messzeitpunkten gibt es nur eine Differenz, und die Annahme ist automatisch erfüllt. Bei drei und mehr Zeitpunkten ist sie oft verletzt, weil benachbarte Zeitpunkte stärker korrelieren als weit auseinanderliegende. Der F-Test wird dann zu liberal. Die übliche Lösung ist die Greenhouse-Geisser-Korrektur (Greenhouse & Geisser, 1959), die die Freiheitsgrade mit einem Faktor \(\varepsilon \le 1\) multipliziert, der das Ausmaß der Verletzung widerspiegelt. Da die Korrektur bei erfüllter Annahme kaum schadet, empfiehlt es sich, diese Korrektur immer anzuwenden, statt die Entscheidung vom wenig zuverlässigen Mauchly-Test abhängig zu machen.
Gemischte Designs. Kombiniert man einen Messwiederholungsfaktor mit einem Gruppenfaktor, erhält man ein gemischtes Design (mixed design oder split-plot design) bei dem eben within (die Zeit) und between Effekte (die Gruppe) gleichzeitig betrachtet werden. Das wichtigste Beispiel ist die Interventionsstudie mit Kontroll- und Trainingsgruppe, die vor und nach dem Training gemessen werden. Hier interessiert vor allem die Interaktion Gruppe × Zeit: Verändert sich die Trainingsgruppe stärker als die Kontrollgruppe?
Die klassische rmANOVA schließt Personen mit auch nur einem fehlenden Messzeitpunkt vollständig aus und setzt voraus, dass alle Personen zu denselben Zeitpunkten gemessen wurden.
5.5 Prä-post-Designs mit zwei Gruppen
Die randomisierte Studie mit Vorher- und Nachhermessung ist das Standarddesign der Interventionsforschung. Umso erstaunlicher ist, wie viele verschiedene Auswertungen man in der Literatur findet. Die vier häufigsten sind:
- Nur die Nachhermessung vergleichen (t-Test oder ANOVA auf Post-Werte).
- Veränderungswerte vergleichen: Für jede Person die Differenz Post minus Prä bilden und die Differenzen zwischen den Gruppen vergleichen.
- Eine rmANOVA mit dem Gruppenfaktor, dem Messwiederholungsfaktor Zeit und ihrer Interaktion. Der Test der Interaktion ist dabei mathematisch identisch mit dem Test der Veränderungswerte: Der F-Wert der Interaktion ist das Quadrat des t-Werts aus Variante 2 und liefert daher auch exakt dieselben p-Werte.
- Eine ANCOVA mit den Post-Werten als Kriterium, der Gruppe als Faktor und den Prä-Werten als Kovariate.
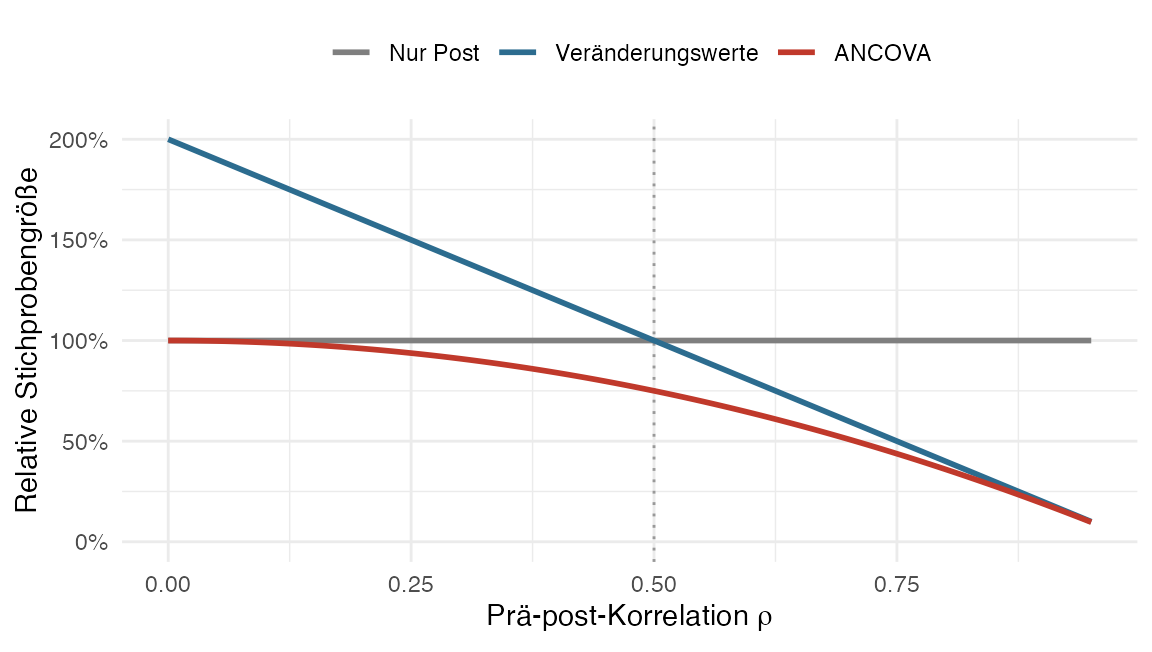
In einer randomisierten Studie schätzen alle vier Varianten denselben Effekt ohne Verzerrung. Sie unterscheiden sich aber erheblich in ihrer Präzision und damit in der Power. Nimmt man an, dass Prä- und Post-Werte dieselbe Standardabweichung SD haben und innerhalb der Gruppen zu \(\rho\) korrelieren, ist die Varianz des geschätzten Effekts proportional zu
\[ \underbrace{1}_{\text{nur Post}}, \qquad \underbrace{2(1 - \rho)}_{\text{Veränderungswerte oder rmANOVA}}, \qquad \underbrace{1 - \rho^2}_{\text{ANCOVA}}. \]
Daraus folgen drei Einsichten, die in Abbildung 5.4 dargestellt sind. Erstens sind Veränderungswerte nur dann präziser als die reine Nachhermessung, wenn \(\rho > .5\) ist; bei kleineren Korrelationen fügt die Differenzbildung mehr Messfehler hinzu, als sie an Personenunterschieden entfernt. Zweitens ist die ANCOVA immer mindestens so präzise wie die anderen Alternativen, denn \(1 - \rho^2 \le 1\) und \(1 - \rho^2 \le 2(1-\rho)\) für alle \(\rho\). Drittens ist der Vorteil der ANCOVA gerade bei mittleren Korrelationen erheblich: Bei \(\rho = .5\) braucht sie ein Viertel weniger Personen als die beiden anderen Varianten.
Die ANCOVA hat außerdem einen zweiten Vorteil: Sie korrigiert für zufällige Unterschiede in der Ausgangslage. Auch in randomisierten Studien sind die Mitglieder der Trainingsgruppe vor der Intervention zufällig mal etwas besser, mal etwas schlechter als die Kontrollgruppe. Der reine Post-Vergleich ignoriert das, und Veränderungswerte überkorrigieren es wegen der Regression zur Mitte: Eine Gruppe, die zufällig schlecht startet, verbessert sich auch ohne Intervention etwas. Die ANCOVA adjustiert genau im richtigen Ausmaß. Aus diesen Gründen empfehlen Methodiker die ANCOVA seit Langem als Standardauswertung randomisierter Prä-post-Studien (Senn, 2006; Van Breukelen, 2006; Vickers & Altman, 2001). Die Einschränkung aus dem vorigen Abschnitt gilt aber auch hier: In nicht randomisierten Studien kann die ANCOVA verzerrt sein, und die Wahl der Analyse ist dort eine inhaltliche Entscheidung.
WarnungEin häufiger Fehler: getrennte Tests in beiden Gruppen
In vielen Arbeiten findet man folgende Argumentation: „In der Trainingsgruppe stieg das Wohlbefinden signifikant (\(p = .01\)), in der Kontrollgruppe nicht (\(p = .20\)). Das Training ist also wirksam.“ Diese Schlussfolgerung ist nicht gerechtfertigt. Getestet wurde zweimal, ob sich eine Gruppe verändert, aber nie, ob sich die Gruppen unterschiedlich verändern. Der Unterschied zwischen „signifikant“ und „nicht signifikant“ ist selbst nicht notwendigerweise signifikant (Gelman & Stern, 2006). Gerade bei kleinen Studien und einem allgemeinen Zeiteffekt führt dieses Vorgehen häufig zu falschen Schlüssen (Bland & Altman, 2011). Getestet werden muss immer der Unterschied zwischen den Gruppen, mit einer der vier oben beschriebenen Methoden, am besten der ANCOVA.
5.5.1 Effektstärken im Prä-post-Design
Auch bei der Effektstärke gibt es in Prä-post-Designs mehrere Möglichkeiten und einige Fallstricke. Cohens \(d\) ist eine Mittelwertsdifferenz geteilt durch eine Standardabweichung. Die entscheidende Frage ist, welche Standardabweichung. Damit \(d\) zwischen Studien mit verschiedenen Designs vergleichbar ist, sollte es sich auf die Streuung der Werte in der Population beziehen, also auf die Standardabweichung der Rohwerte und nicht auf die der Veränderungswerte.
Morris (2008) hat verschiedene Schätzer verglichen und empfiehlt, die Differenz der mittleren Veränderungen durch die gepoolte Standardabweichung der Prä-Werte zu teilen:
\[ d_\text{ppc} = c_p \cdot \frac{(\bar y_{T,\text{post}} - \bar y_{T,\text{prä}}) - (\bar y_{K,\text{post}} - \bar y_{K,\text{prä}})}{SD_\text{prä, gepoolt}}, \qquad c_p = 1 - \frac{3}{4(n_T + n_K - 2) - 1}. \tag{5.3}\]
\(T\) steht für die Trainings-, \(K\) für die Kontrollgruppe, und der Faktor \(c_p\) korrigiert eine kleine Verzerrung in kleinen Stichproben. Die Prä-Werte haben den Vorteil, dass sie von der Intervention noch nicht beeinflusst sind. Wertet man mit einer ANCOVA aus, teilt man entsprechend die adjustierte Mittelwertsdifferenz durch die gepoolte Standardabweichung der Rohwerte.
Teilt man dagegen durch die Standardabweichung der Veränderungswerte, erhält man eine andere Größe, die oft mit \(d_z\) oder \(d_\text{rm}\) bezeichnet wird. Weil die Veränderungswerte bei hoher Prä-post-Korrelation viel weniger streuen, fällt dieses \(d\) um den Faktor \(1/\sqrt{2(1-\rho)}\) größer aus, bei \(\rho = .8\) also um mehr als das Eineinhalbfache. Es ist nicht falsch, aber nicht mit einem \(d\) aus einem Design ohne Messwiederholung vergleichbar. Wer es berichtet, ohne das deutlich zu machen, lässt einen Effekt größer erscheinen, als er ist.
5.6 Fallzahlplanung
Die Teststärke (Power) eines Tests ist die Wahrscheinlichkeit, einen Effekt einer bestimmten Größe zu entdecken, wenn es ihn gibt. Sie hängt von vier Größen ab, von denen man drei festlegen muss, um die vierte zu berechnen: dem Signifikanzniveau \(\alpha\), der Teststärke \(1 - \beta\), der Effektgröße und der Stichprobengröße. Wie wir in der Einleitung gesehen haben, sind viele psychologische Studien viel zu klein (Cohen, 1988). Eine Fallzahlplanung vor der Datenerhebung ist deshalb heute Standard und wird von Ethikkommissionen, Geldgebern und Zeitschriften für Präregistrierungen verlangt.
Für den Vergleich zweier Gruppen gibt es eine nützliche Faustformel. Mit \(\alpha = .05\) (zweiseitig) und einer Teststärke von 80 % braucht man pro Gruppe ungefähr
\[ n \approx \frac{2\,(z_{1-\alpha/2} + z_{1-\beta})^2}{d^2} \approx \frac{16}{d^2} \]
Personen (Lehr, 1992). Für einen mittleren Effekt von \(d = 0{,}5\) sind das 64, für einen kleinen Effekt von \(d = 0{,}2\) schon 400 Personen pro Gruppe. Diese Formel lässt sich direkt auf die Auswertungsvarianten des Prä-post-Designs übertragen: Man multipliziert die Stichprobe mit den Faktoren aus Abbildung 5.4, für die ANCOVA also mit \(1 - \rho^2\) (Borm et al., 2007). Tabelle 5.1 zeigt die Konsequenzen für eine realistische Prä-post-Korrelation von \(\rho = .6\).
| Effekt d | Nur Post | Veränderungswerte | ANCOVA |
|---|---|---|---|
| 0,20 | 393 | 314 | 252 |
| 0,35 | 129 | 103 | 83 |
| 0,50 | 63 | 51 | 41 |
| 0,80 | 25 | 20 | 16 |
Die schwierigste Frage bei jeder Fallzahlplanung ist, welche Effektgröße man annehmen soll. Drei Ratschläge helfen weiter (Lakens, 2022):
- Keine Effektgrößen aus Pilotstudien. Kleine Pilotstudien schätzen Effekte so ungenau, dass eine darauf beruhende Planung oft viel zu kleine Stichproben ergibt (Albers & Lakens, 2018).
- Den kleinsten relevanten Effekt planen. Statt zu fragen, wie groß der Effekt vermutlich ist, fragt man, wie groß er mindestens sein müsste, damit er praktisch bedeutsam ist. Für ein Training, das pro Person 2.000 € kostet, kann das ein ganz anderer Wert sein als für eine kostenlose App.
- Das Auswertungsmodell zugrunde legen. Die Fallzahl muss für den Test berechnet werden, der später tatsächlich gerechnet wird. Wer eine ANCOVA plant, aber für einen t-Test rechnet, verschenkt Ressourcen; wer eine Interaktion testen will, aber für einen Haupteffekt plant, hat eine viel zu kleine Studie.
Für Standarddesigns gibt es Formeln und Programme wie G*Power (Faul et al., 2007) oder das R-Paket pwr. Für komplexere Designs, etwa rmANOVAs mit mehreren Messzeitpunkten, Interaktionen oder Mehrebenenmodelle, ist die Simulation der flexibelste Weg: Man erzeugt viele Datensätze mit dem angenommenen Effekt, wertet jeden so aus wie geplant und zählt, wie oft der Test signifikant wird.
5.7 Varianzanalysen mit R
Nach so viel Konzept geht es nun an die praktische Umsetzung. Einfache Varianzanalysen können Sie, wie im Regressionskapitel gezeigt, mit lm() und anova() rechnen. Für mehrfaktorielle und Messwiederholungsdesigns verwenden wir zusätzlich drei spezialisierte Pakete: afex für die Schätzung mit den üblichen Voreinstellungen (Effektkodierung, Typ-III-Quadratsummen, Greenhouse-Geisser-Korrektur), emmeans für adjustierte Mittelwerte, Kontraste und Post-hoc-Tests und effectsize für Effektstärken (Ben-Shachar et al., 2020).
5.7.1 Beispieldatensatz
library(tidyverse)
library(palmerpenguins)
library(afex)
library(emmeans)

pinguine <- penguins |>
  select(art = species, insel = island,
         schnabel_mm = bill_length_mm, schnabeltiefe_mm = bill_depth_mm,
         flosse_mm = flipper_length_mm, masse_g = body_mass_g,
         geschlecht = sex) |>
  drop_na() |>
  mutate(geschlecht = fct_recode(geschlecht,
                                 weiblich = "female", männlich = "male"),
         id = row_number())
afex braucht eine Variable, die jede Untersuchungseinheit eindeutig kennzeichnet, auch wenn es gar keine Messwiederholung gibt. Deshalb legen wir mit row_number() eine id an.
5.7.2 Einfaktorielle Varianzanalyse
Die einfaktorielle ANOVA kennen Sie bereits aus dem Regressionskapitel. Wir schätzen sie noch einmal mit lm() und berechnen die Effektstärken \(\eta^2\) und \(\omega^2\):
m_1f <- lm(masse_g ~ art, data = pinguine)
anova(m_1f)
Analysis of Variance Table
Response: masse_g
Df Sum Sq Mean Sq F value Pr(>F)
art 2 145190219 72595110 341.89 < 2.2e-16 ***
Residuals 330 70069447 212332
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1effectsize::eta_squared(m_1f)# Effect Size for ANOVA
Parameter | Eta2 | 95% CI
-------------------------------
art | 0.67 | [0.63, 1.00]
- One-sided CIs: upper bound fixed at [1.00].effectsize::omega_squared(m_1f)# Effect Size for ANOVA
Parameter | Omega2 | 95% CI
---------------------------------
art | 0.67 | [0.63, 1.00]
- One-sided CIs: upper bound fixed at [1.00].Welche Arten sich unterscheiden, zeigen die paarweisen Vergleiche. emmeans() berechnet zuerst die Mittelwerte jeder Art aus dem Modell; pairs() vergleicht sie und korrigiert dabei standardmäßig nach Tukey:
emm_art <- emmeans(m_1f, ~ art)
emm_art
art emmean SE df lower.CL upper.CL
Adelie 3706 38.1 330 3631 3781
Chinstrap 3733 55.9 330 3623 3843
Gentoo 5092 42.2 330 5009 5176
Confidence level used: 0.95 pairs(emm_art) contrast estimate SE df t.ratio p.value
Adelie - Chinstrap -26.9 67.7 330 -0.398 0.9164
Adelie - Gentoo -1386.3 56.9 330 -24.359 <0.0001
Chinstrap - Gentoo -1359.3 70.0 330 -19.406 <0.0001
P value adjustment: tukey method for comparing a family of 3 estimates pairs(emm_art, adjust = "holm") contrast estimate SE df t.ratio p.value
Adelie - Chinstrap -26.9 67.7 330 -0.398 0.6909
Adelie - Gentoo -1386.3 56.9 330 -24.359 <0.0001
Chinstrap - Gentoo -1359.3 70.0 330 -19.406 <0.0001
P value adjustment: holm method for 3 tests Einen geplanten Kontrast übergibt man contrast() als benannte Liste von Gewichten in der Reihenfolge der Faktorstufen:
contrast(emm_art, list("Gentoo vs. andere" = c(-1/2, -1/2, 1))) contrast estimate SE df t.ratio p.value
Gentoo vs. andere 1373 54.1 330 25.368 <0.0001Gentoo-Pinguine sind im Mittel um 1373 g schwerer als der Durchschnitt der beiden anderen Arten.
5.7.3 Zweifaktorielle Varianzanalyse
Nun untersuchen wir, ob sich die Gewichtsunterschiede zwischen den Geschlechtern je nach Art unterscheiden. aov_ez() aus afex erwartet den Namen der ID-Variable, der abhängigen Variable, den Datensatz und die Faktoren. Faktoren, die zwischen Personen (hier: Tieren) variieren, übergibt man als between:
m_2f <- aov_ez(id = "id", dv = "masse_g", data = pinguine,
               between = c("art", "geschlecht"))
m_2f
Anova Table (Type 3 tests)
Response: masse_g
Effect df MSE F ges p.value
1 art 2, 327 95726.69 746.92 *** .820 <.001
2 geschlecht 1, 327 95726.69 311.84 *** .488 <.001
3 art:geschlecht 2, 327 95726.69 8.76 *** .051 <.001
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1Die Ausgabe zeigt für jeden Effekt die Freiheitsgrade, die mittlere Fehlerquadratsumme (MSE), den F-Wert, das generalisierte \(\eta^2\) (ges) und den p-Wert. afex verwendet automatisch Effektkodierung und Typ-III-Quadratsummen. Zum Vergleich: Die Typ-I-Quadratsummen von anova() hängen bei ungleichen Zellbesetzungen von der Reihenfolge der Faktoren ab.
anova(lm(masse_g ~ art * geschlecht, data = pinguine))Analysis of Variance Table
Response: masse_g
Df Sum Sq Mean Sq F value Pr(>F)
art 2 145190219 72595110 758.358 < 2.2e-16 ***
geschlecht 1 37090262 37090262 387.460 < 2.2e-16 ***
art:geschlecht 2 1676557 838278 8.757 0.0001973 ***
Residuals 327 31302628 95727
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1anova(lm(masse_g ~ geschlecht * art, data = pinguine))Analysis of Variance Table
Response: masse_g
Df Sum Sq Mean Sq F value Pr(>F)
geschlecht 1 38878897 38878897 406.145 < 2.2e-16 ***
art 2 143401584 71700792 749.016 < 2.2e-16 ***
geschlecht:art 2 1676557 838278 8.757 0.0001973 ***
Residuals 327 31302628 95727
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Da die Zellen hier fast gleich groß sind, sind die Unterschiede zwischen den Reihenfolgen klein. Bei stark unbalancierten Designs können sie erheblich sein. Der Test der Interaktion, die in beiden Formeln zuletzt kommt, ist identisch.
Die Interaktion ist signifikant. Um sie zu verstehen, bilden wir die Zellmittelwerte ab (Abbildung 5.5) und berechnen die einfachen Effekte des Geschlechts für jede Art. Der senkrechte Strich in der Formel ~ geschlecht | art bedeutet „Geschlecht, getrennt für jede Art“:
versatz <- position_dodge(width = 0.3)

ggplot(pinguine, aes(art, masse_g, colour = geschlecht, group = geschlecht)) +
  stat_summary(fun = mean, geom = "line", position = versatz) +
  stat_summary(fun.data = mean_se, fun.args = list(mult = 1.96),
               geom = "pointrange", position = versatz) +
  scale_colour_manual(values = c(weiblich = blau, männlich = akzent)) +
  labs(x = NULL, y = "Körpergewicht (g)", colour = NULL) +
  theme(legend.position = "top")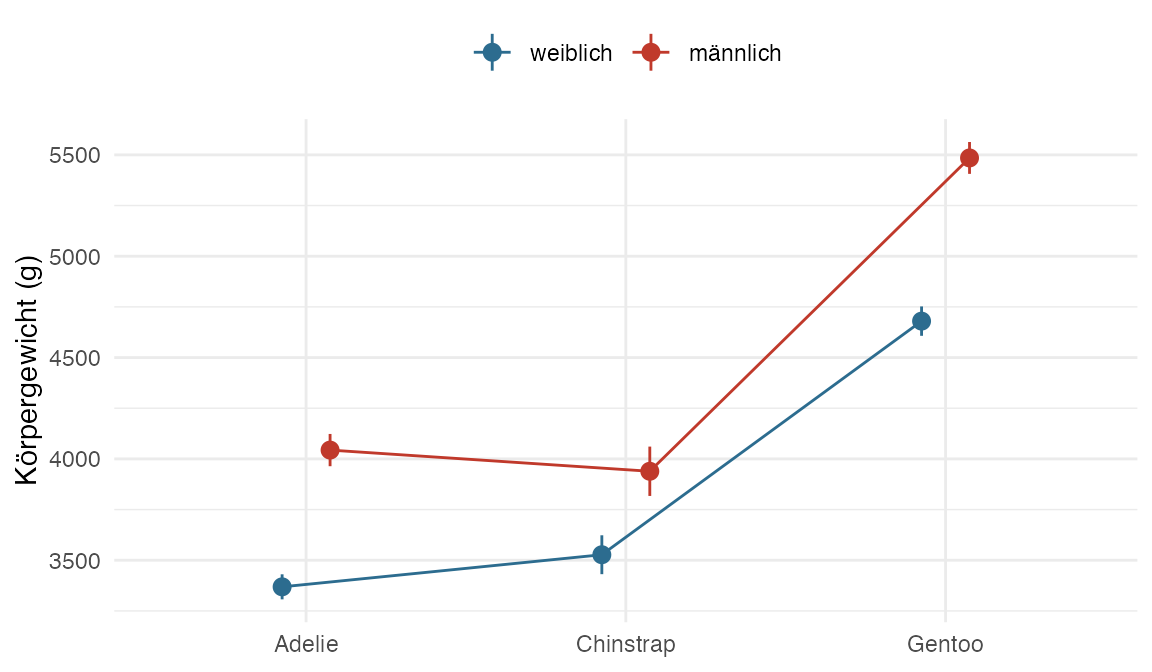
emm_2f <- emmeans(m_2f, ~ geschlecht | art)

pairs(emm_2f)
art = Adelie:
contrast estimate SE df t.ratio p.value
weiblich - männlich -675 51.2 327 -13.174 <0.0001
art = Chinstrap:
contrast estimate SE df t.ratio p.value
weiblich - männlich -412 75.0 327 -5.487 <0.0001
art = Gentoo:
contrast estimate SE df t.ratio p.value
weiblich - männlich -805 56.7 327 -14.188 <0.0001Männliche Tiere sind bei allen drei Arten schwerer, der Unterschied ist aber unterschiedlich groß — eine ordinale Interaktion. Ob sich der Geschlechtsunterschied zwischen zwei bestimmten Arten unterscheidet, prüfen Interaktionskontraste, also Differenzen von Differenzen:
contrast(emm_2f, interaction = "pairwise", by = NULL) geschlecht_pairwise art_pairwise estimate SE df t.ratio p.value
weiblich - männlich Adelie - Chinstrap -263 90.8 327 -2.894 0.0041
weiblich - männlich Adelie - Gentoo 130 76.4 327 1.706 0.0889
weiblich - männlich Chinstrap - Gentoo 393 94.1 327 4.181 <0.00015.7.4 Moderation mit einem kontinuierlichen Prädiktor
Im Regressionskapitel hatten wir angenommen, dass der Zusammenhang zwischen Flossenlänge und Körpergewicht bei allen Arten gleich ist. Jetzt prüfen wir das mit einem Interaktionsterm. Die Flossenlänge zentrieren wir vorher, damit der Koeffizient der Art den Unterschied bei durchschnittlicher Flossenlänge beschreibt:
pinguine <- pinguine |>
  mutate(flosse_c = flosse_mm - mean(flosse_mm))

m_add <- lm(masse_g ~ flosse_c + art, data = pinguine)
m_mod <- lm(masse_g ~ flosse_c * art, data = pinguine)

anova(m_add, m_mod)
Analysis of Variance Table
Model 1: masse_g ~ flosse_c + art
Model 2: masse_g ~ flosse_c * art
Res.Df RSS Df Sum of Sq F Pr(>F)
1 329 45843144
2 327 44391669 2 1451475 5.346 0.005193 **
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1broom::tidy(m_mod)# A tibble: 6 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 4061. 59.4 68.4 9.37e-196
2 flosse_c 32.7 4.69 6.97 1.78e- 11
3 artChinstrap -150. 81.1 -1.85 6.46e- 2
4 artGentoo 150. 108. 1.39 1.66e- 1
5 flosse_c:artChinstrap 1.88 7.86 0.240 8.11e- 1
6 flosse_c:artGentoo 21.5 6.97 3.08 2.23e- 3flosse_c * art ist eine Abkürzung für flosse_c + art + flosse_c:art. Der Doppelpunkt bezeichnet den Produktterm allein.
Der Koeffizient flosse_c ist die Steigung in der Referenzgruppe (Adelie), die Koeffizienten flosse_c:artChinstrap und flosse_c:artGentoo sind die Unterschiede der Steigungen zu dieser Referenz. Die einfachen Steigungen für jede Art berechnet emtrends() direkt:
emtrends(m_mod, ~ art, var = "flosse_c") art flosse_c.trend SE df lower.CL upper.CL
Adelie 32.7 4.69 327 23.5 41.9
Chinstrap 34.6 6.31 327 22.2 47.0
Gentoo 54.2 5.15 327 44.0 64.3
Confidence level used: 0.95 Abbilden lässt sich das Modell mit geom_smooth(), das für jede Art eine eigene Gerade schätzt — genau das, was das Modell mit Interaktion tut (Abbildung 5.6):
ggplot(pinguine, aes(flosse_mm, masse_g, colour = art)) +
  geom_point(alpha = 0.3, size = 1) +
  geom_smooth(method = "lm", formula = y ~ x, se = TRUE) +
  scale_colour_manual(values = c(Adelie = blau, Chinstrap = "grey45",
                                 Gentoo = akzent)) +
  labs(x = "Flossenlänge (mm)", y = "Körpergewicht (g)", colour = NULL) +
  theme(legend.position = "top")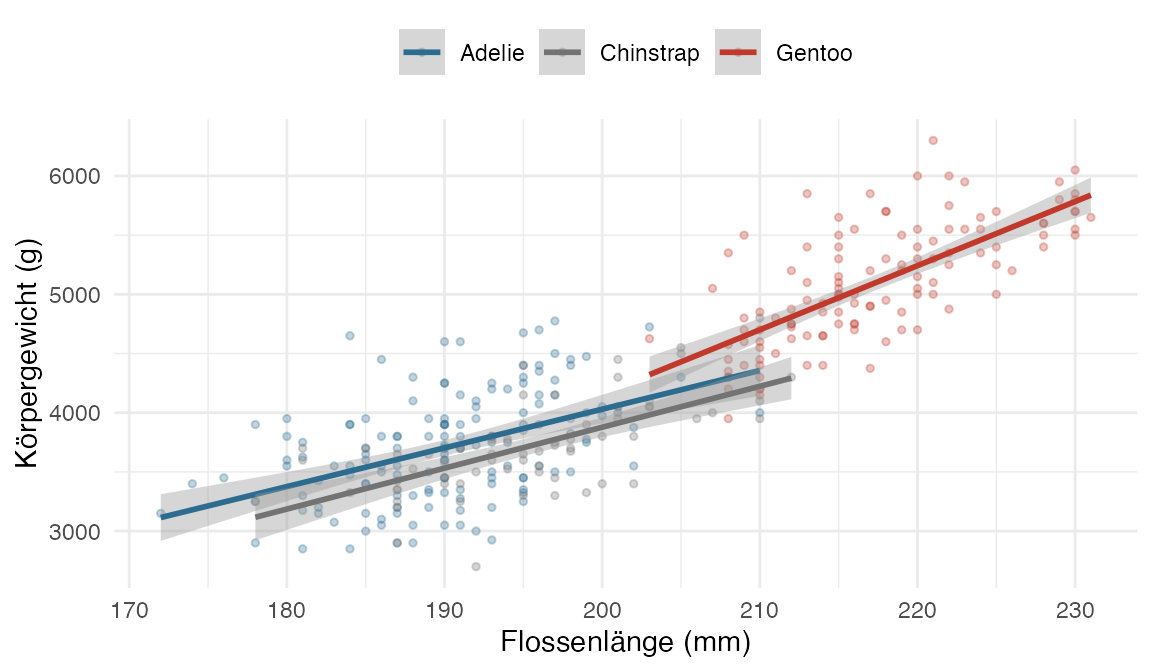
5.7.5 Eine Prä-post-Studie auswerten
Für die Auswertung eines Prä-post-Designs simulieren wir eine randomisierte Studie: 50 Beschäftigte nehmen an einem Resilienztraining teil, 50 bilden die Kontrollgruppe. Das Wohlbefinden wird vorher und nachher auf einer Skala mit Mittelwert 50 und Standardabweichung 10 gemessen. Die Prä-post-Korrelation beträgt \(\rho = .6\), alle verbessern sich um 3 Punkte (etwa durch die Jahreszeit), und das Training bewirkt zusätzlich 5 Punkte. Der wahre Effekt entspricht also \(d = 0{,}5\).
simuliere_prepost <- function(n_pro_gruppe = 50, rho = 0.6, effekt = 5, sd = 10) {
  n      <- 2 * n_pro_gruppe
  gruppe <- rep(c("Kontrolle", "Training"), each = n_pro_gruppe)
  prae   <- rnorm(n, mean = 50, sd = sd)
  post   <- 53 + rho * (prae - 50) + sqrt(1 - rho^2) * rnorm(n, 0, sd) +
    effekt * (gruppe == "Training")
  tibble(id = 1:n,
         gruppe = factor(gruppe, levels = c("Kontrolle", "Training")),
         prae, post)
}

set.seed(2026)
studie <- simuliere_prepost()

studie |>
  summarise(across(c(prae, post), list(m = mean, sd = sd)),
            r = cor(prae, post), .by = gruppe)
# A tibble: 2 × 6
gruppe prae_m prae_sd post_m post_sd r
<fct> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Kontrolle 49.8 9.76 53.9 9.97 0.530
2 Training 48.2 10.3 57.9 9.00 0.650Für die rmANOVA und für Abbildungen brauchen wir die Daten im langen Format, mit einer Zeile pro Person und Messzeitpunkt. pivot_longer() kennen Sie aus dem Kapitel zum Datenmanagement:
studie_lang <- studie |>
  pivot_longer(c(prae, post), names_to = "zeit", values_to = "wohlbefinden") |>
  mutate(zeit = factor(zeit, levels = c("prae", "post"),
                       labels = c("vorher", "nachher")))
Wie immer bietet es sich an, sich die Daten ersteinmal anzuschauen, bevor man anfängt komplexere Modelle an die Daten anzupassen.
versatz <- position_dodge(0.15)

ggplot(studie_lang, aes(zeit, wohlbefinden, colour = gruppe, group = gruppe)) +
  stat_summary(fun = mean, geom = "line", position = versatz) +
  stat_summary(fun.data = mean_cl_boot,
               geom = "pointrange", position = versatz) +
  scale_colour_manual(values = c(Kontrolle = blau, Training = akzent)) +
  labs(x = NULL, y = "Wohlbefinden", colour = NULL) +
  theme(legend.position = "top")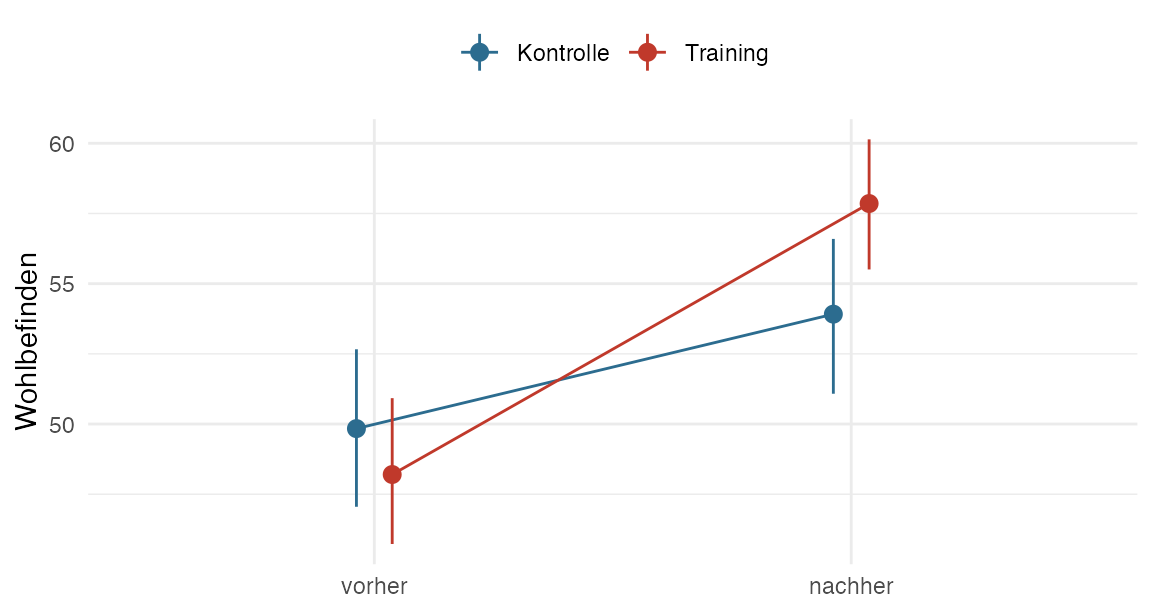
Nun rechnen wir die vier Auswertungsvarianten. Wir machen das nicht, weil Sie Selbst später alle Varianten rechnen sollen, sondern weil man hier nochmal sehr schön sehen kann, dass die ANCOVA für diese Art von Studien das beste Verfahren ist. Die ersten drei sind lineare Modelle; I() sorgt dafür, dass R post - prae als Rechenoperation versteht und nicht als Formelsyntax:
m_post   <- lm(post ~ gruppe, data = studie)
m_diff   <- lm(I(post - prae) ~ gruppe, data = studie)
m_ancova <- lm(post ~ prae + gruppe, data = studie)

m_rm <- aov_ez(id = "id", dv = "wohlbefinden", data = studie_lang,
               between = "gruppe", within = "zeit")
m_rm
Anova Table (Type 3 tests)
Response: wohlbefinden
Effect df MSE F ges p.value
1 gruppe 1, 98 151.49 0.44 .004 .510
2 zeit 1, 98 39.58 59.52 *** .112 <.001
3 gruppe:zeit 1, 98 39.58 9.82 ** .020 .002
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1Die Effektschätzungen der drei linearen Modelle stellen wir nebeneinander:
pp_vergleich <- list("Nur Post"          = m_post,
                     "Veränderungswerte" = m_diff,
                     "ANCOVA"            = m_ancova) |>
  map(\(m) broom::tidy(m, conf.int = TRUE) |> filter(term == "gruppeTraining")) |>
  list_rbind(names_to = "methode") |>
  select(methode, estimate, std.error, conf.low, conf.high, statistic, p.value)

pp_vergleich
# A tibble: 3 × 7
methode estimate std.error conf.low conf.high statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Nur Post 3.94 1.90 0.172 7.71 2.08 0.0406
2 Veränderungswerte 5.58 1.78 2.04 9.11 3.13 0.00228
3 ANCOVA 4.85 1.55 1.77 7.92 3.13 0.00234In allen Auswertungsvarianten ist der Effekt zwar signifikant, aber unterschiedlich groß. Außerdem ist Präzision unterschiedlich. In der Spalte std.error sehen Sie, dass die ANCOVA den Effekt am präzisesten schätzt. Außerdem können Sie prüfen, dass der F-Wert der Interaktion gruppe:zeit in der rmANOVA (9.82) genau das Quadrat des t-Werts der Veränderungswerte ist (9.82). Die Voraussetzung paralleler Geraden prüfen wir, indem wir die Interaktion von Prä-Wert und Gruppe aufnehmen, und die adjustierten Mittelwerte liefert wieder emmeans():
anova(m_ancova, lm(post ~ prae * gruppe, data = studie))Analysis of Variance Table
Model 1: post ~ prae + gruppe
Model 2: post ~ prae * gruppe
Res.Df RSS Df Sum of Sq F Pr(>F)
1 97 5792.6
2 96 5791.1 1 1.5276 0.0253 0.8739emmeans(m_ancova, ~ gruppe) gruppe emmean SE df lower.CL upper.CL
Kontrolle 53.5 1.09 97 51.3 55.6
Training 58.3 1.09 97 56.1 60.5
Confidence level used: 0.95 emmeans() setzt die Kovariate automatisch auf ihren Mittelwert. Die Differenz der adjustierten Mittelwerte ist exakt der Koeffizient gruppeTraining der ANCOVA.
5.7.6 Effektstärken berechnen
Für die Effektstärke nach Gleichung 5.3 brauchen wir die Mittelwerte und Standardabweichungen beider Gruppen zu beiden Zeitpunkten:
kw <- studie |>
  summarise(n = n(), m_prae = mean(prae), m_post = mean(post),
            sd_prae = sd(prae), sd_post = sd(post), .by = gruppe)

gepoolt <- function(sd, n) sqrt(sum((n - 1) * sd^2) / (sum(n) - 2))

sd_prae_gep <- gepoolt(kw$sd_prae, kw$n)
sd_post_gep <- gepoolt(kw$sd_post, kw$n)
c_p <- 1 - 3 / (4 * (sum(kw$n) - 2) - 1)

veraenderung <- kw$m_post - kw$m_prae          # Kontrolle, Training
d_ppc <- c_p * (veraenderung[2] - veraenderung[1]) / sd_prae_gep

d_ancova <- coef(m_ancova)["gruppeTraining"] / sd_post_gep

# zum Vergleich: bezogen auf die Streuung der Veränderungswerte
sd_diff_gep <- studie |>
  summarise(sd = sd(post - prae), n = n(), .by = gruppe) |>
  with(gepoolt(sd, n))
d_veraenderung <- coef(m_diff)["gruppeTraining"] / sd_diff_gep

round(c(d_ppc = d_ppc, d_ancova = unname(d_ancova),
        d_veraenderung = unname(d_veraenderung)), 2)
d_ppc d_ancova d_veraenderung
0.55 0.51 0.63 Die beiden empfohlenen Maße d_ppc und ANCOVA liegen nahe am wahren Wert von 0,5. Das auf die Veränderungswerte bezogene \(d\) fällt deutlich größer aus, obwohl es denselben Effekt beschreiben sollte. In der Praxis sollten Sie daher die ANCOVA verwenden.
5.7.7 Warum die ANCOVA gewinnt: eine Simulation
Eine einzelne Studie kann zufällig für die eine oder andere Methode günstig ausfallen. Ob die theoretischen Überlegungen zur Präzision stimmen, prüfen wir mit einer kleinen Simulationsstudie. Wir wiederholen die Studie 1000-mal, werten jede Wiederholung mit den drei Methoden aus und vergleichen die Verteilung der Schätzungen und den Anteil signifikanter Ergebnisse, also die empirische Teststärke:
werte_aus <- function(d) {
  list("Nur Post"          = lm(post ~ gruppe, data = d),
       "Veränderungswerte" = lm(I(post - prae) ~ gruppe, data = d),
       "ANCOVA"            = lm(post ~ prae + gruppe, data = d)) |>
    map(\(m) broom::tidy(m) |> filter(term == "gruppeTraining")) |>
    list_rbind(names_to = "methode")
}

set.seed(123)
sim <- map(1:1000, \(i) werte_aus(simuliere_prepost())) |>
  list_rbind(names_to = "durchgang") |>
  mutate(methode = fct_inorder(methode))

sim_ergebnis <- sim |>
  summarise(mittlere_schaetzung = mean(estimate),
            sd_schaetzung       = sd(estimate),
            teststaerke         = mean(p.value < .05),
            .by = methode)
sim_ergebnis
# A tibble: 3 × 4
methode mittlere_schaetzung sd_schaetzung teststaerke
<fct> <dbl> <dbl> <dbl>
1 Nur Post 5.13 1.87 0.736
2 Veränderungswerte 5.06 1.79 0.779
3 ANCOVA 5.09 1.55 0.881ggplot(sim, aes(estimate, colour = methode)) +
geom_vline(xintercept = 5, linetype = "dashed", colour = "grey40") +
geom_density(linewidth = 1) +
scale_colour_manual(values = c(`Nur Post` = "grey50",
`Veränderungswerte` = blau,
ANCOVA = akzent)) +
labs(x = "Geschätzter Trainingseffekt", y = "Dichte", colour = NULL) +
theme(legend.position = "top")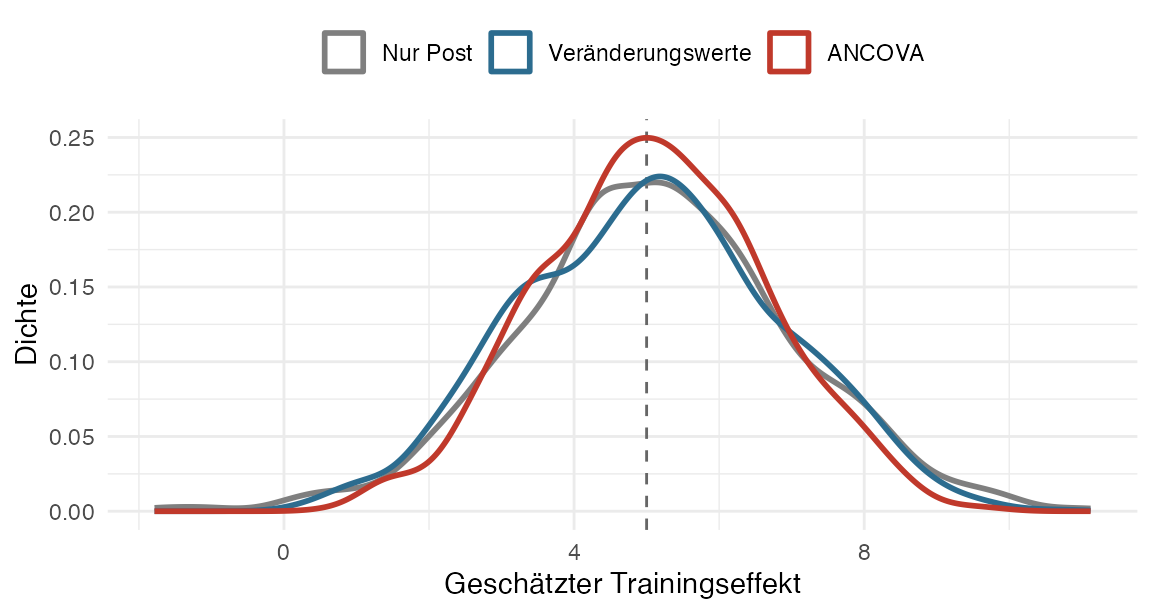
Alle drei Methoden treffen im Mittel den wahren Effekt von 5 Punkten. Die Teststärke unterscheidet sich aber erheblich: Mit derselben Stichprobe entdeckt die ANCOVA den Effekt in 88 % der Studien, der reine Post-Vergleich nur in 74 %.
5.7.8 Messwiederholung mit mehr als zwei Zeitpunkten
Bei mehr als zwei Messzeitpunkten spielt die sog. Sphärizität eine Rolle. Als Beispiel verwenden wir den Datensatz obk.long, der mit afex geladen wird. Er enthält die Daten eines fiktiven Experiments von O’Brien und Kaiser mit drei Behandlungsgruppen (treatment: control, A, B), die vor der Behandlung (pre), danach (post) und in einer Nachuntersuchung (fup) gemessen wurden. Zu jedem Zeitpunkt werden fünf Messungen durchgeführt, die wir mit fun_aggregate = mean zu einem Mittelwert zusammenfassen:
data(obk.long, package = "afex")

m_obk <- aov_ez(id = "id", dv = "value", data = obk.long,
                between = "treatment", within = "phase",
                fun_aggregate = mean)
m_obk
Anova Table (Type 3 tests)
Response: value
Effect df MSE F ges p.value
1 treatment 2, 13 6.41 2.91 + .269 .090
2 phase 1.74, 22.64 0.81 19.29 *** .212 <.001
3 treatment:phase 3.48, 22.64 0.81 5.43 ** .131 .004
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '+' 0.1 ' ' 1
Sphericity correction method: GG In der Zeile phase und treatment:phase sehen Sie Freiheitsgrade mit Nachkommastellen: Das ist die Greenhouse-Geisser-Korrektur, die afex standardmäßig anwendet. Die unkorrigierten Werte und die Sphärizitätstests zeigt summary(m_obk). Einfache Effekte und Post-hoc-Tests funktionieren genau wie bei Designs ohne Messwiederholung:
emm_obk <- emmeans(m_obk, ~ phase | treatment)
pairs(emm_obk, adjust = "holm")
treatment = control:
contrast estimate SE df t.ratio p.value
fup - post 0.400 0.486 13 0.822 1.0000
fup - pre 0.200 0.471 13 0.425 1.0000
post - pre -0.200 0.627 13 -0.319 1.0000
treatment = A:
contrast estimate SE df t.ratio p.value
fup - post 0.750 0.544 13 1.379 0.1911
fup - pre 2.250 0.526 13 4.275 0.0027
post - pre 1.500 0.700 13 2.141 0.1035
treatment = B:
contrast estimate SE df t.ratio p.value
fup - post 0.714 0.411 13 1.738 0.1059
fup - pre 3.143 0.398 13 7.899 <0.0001
post - pre 2.429 0.530 13 4.586 0.0010
P value adjustment: holm method for 3 tests 5.7.9 Fallzahlberechnung
Das Paket pwr berechnet Fallzahlen für die Standardfälle. Lässt man eines der Argumente n, d (bzw. f), sig.level oder power weg, wird genau dieses berechnet. Für einen t-Test bzw. den reinen Post-Vergleich mit \(d = 0{,}5\):
library(pwr)

plan_t <- pwr.t.test(d = 0.5, sig.level = 0.05, power = 0.80)
plan_t
     Two-sample t test power calculation

              n = 63.76561
              d = 0.5
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group
Für die ANCOVA multipliziert man die Fallzahl mit \(1 - \rho^2\). Bei einer erwarteten Prä-post-Korrelation von .6 ergibt das:
n_ancova <- ceiling(plan_t$n * (1 - 0.6^2))
n_ancova
[1] 41Für eine einfaktorielle ANOVA verwendet pwr.anova.test() die Effektgröße \(f\) nach Cohen, die bei zwei Gruppen \(d/2\) entspricht. Für drei Gruppen und einen mittleren Effekt von \(f = 0{,}25\):
pwr.anova.test(k = 3, f = 0.25, sig.level = 0.05, power = 0.80)
     Balanced one-way analysis of variance power calculation

              k = 3
              n = 52.3966
              f = 0.25
      sig.level = 0.05
          power = 0.8

NOTE: n is number in each group
Die Werte von n gelten in pwr immer pro Gruppe. Runden Sie stets auf.
Ob die Formel für die ANCOVA stimmt, können wir mit derselben Simulationslogik wie oben prüfen. Wir simulieren Studien mit 41 Personen pro Gruppe und bestimmen die Teststärke der ANCOVA und des reinen Post-Vergleichs:
set.seed(99)
pwr_sim <- map(1:1000, \(i) werte_aus(simuliere_prepost(n_pro_gruppe = n_ancova))) |>
  list_rbind() |>
  summarise(teststaerke = mean(p.value < .05), .by = methode)
pwr_sim
# A tibble: 3 × 2
methode teststaerke
<chr> <dbl>
1 Nur Post 0.604
2 Veränderungswerte 0.685
3 ANCOVA 0.784Die ANCOVA erreicht mit 41 statt 64 Personen pro Gruppe die geplanten 80 %, der Post-Vergleich mit derselben Stichprobe nicht. Diese Art der simulationsbasierten Fallzahlplanung lässt sich auf jedes Design übertragen, für das es keine Formel gibt: Man ersetzt einfach die Funktionen simuliere_prepost() und werte_aus() durch das geplante Design und die geplante Auswertung.
5.8 Fazit
- Die Varianzanalyse zerlegt die Gesamtvarianz in einen Anteil zwischen und einen innerhalb der Gruppen und testet mit dem F-Test, ob sich Mittelwerte unterscheiden. Sie ist ein Spezialfall des Allgemeinen Linearen Modells.
- Nach einem signifikanten F-Test klären geplante Kontraste oder Post-hoc-Tests mit Korrektur für multiples Testen, welche Gruppen sich unterscheiden. Als Effektstärken dienen \(\eta^2\), \(\omega^2\) und das partielle bzw. generalisierte \(\eta^2\).
- Interaktionen sind Produktterme im linearen Modell und beschreiben, ob und wie der Effekt eines Faktors von einem anderen abhängt. Sind Interaktionen im Modell, hängt die Bedeutung der Haupteffekte von der Kodierung ab, und bei unbalancierten Designs vom Typ der Quadratsummen. Tests der Interaktionen benötigen viel größere Stichproben als Haupteffekte.
- Moderation ist eine Interaktion mit einem kontinuierlichen Prädiktor. Man zentriert die Prädiktoren und interpretiert die Interaktion über einfache Steigungen und Abbildungen.
- Die ANCOVA erhöht in randomisierten Studien die Teststärke, weil die Kovariate Fehlervarianz aufklären kann. In nicht randomisierten Studien kann sie Gruppenunterschiede nur begrenzt „herausrechnen“.
- Die rmANOVA entfernt stabile Personenunterschiede aus dem Fehlerterm. Bei mehr als zwei Messzeitpunkten korrigiert man für Verletzungen der Sphärizität mit Greenhouse-Geisser.
- In randomisierten Prä-post-Designs ist die ANCOVA mit dem Prä-Wert als Kovariate die präziseste Auswertung. Effektstärken bezieht man auf die Standardabweichung der Rohwerte, nicht der Veränderungswerte, und getrennte Tests in beiden Gruppen ersetzen nie den Test des Gruppenunterschieds.
- Die Fallzahlplanung gehört vor die Datenerhebung. Sie sollte auf dem kleinsten relevanten Effekt und dem tatsächlich geplanten Auswertungsmodell beruhen; für komplexe Designs ist die Simulation das Mittel der Wahl.
- In R rechnet man Varianzanalysen mit
lm()oderafex::aov_ez(), berechnet adjustierte Mittelwerte, Kontraste und einfache Effekte mitemmeans, Effektstärken miteffectsizeund Fallzahlen mitpwroder per Simulation.
5.8.1 Vertiefung
Das Standardwerk zur Planung und Auswertung von Experimenten ist Designing Experiments and Analyzing Data von Maxwell, Delaney und Kelley (2018), das konsequent aus der Perspektive von Modellvergleichen argumentiert und alle Themen dieses Kapitels ausführlich behandelt. Zur Auswertung von Prä-post-Studien sind der kurze und sehr klare Beitrag von Vickers und Altman (2001) und die etwas technischere Arbeit von Van Breukelen (2006) zu empfehlen, die auch den Unterschied zwischen randomisierten und nicht randomisierten Studien herausarbeitet. Effektstärken für Prä-post-Designs behandelt Morris (2008). Wie man eine Fallzahlen mit und ohne Poweranalysen sinnvoll begründet, beschreibt Lakens (2022). Und wer Interaktionen mit kontinuierlichen Prädiktoren vertiefen möchte, findet bei Aiken und West (1991) den Klassiker zum Thema.