| Datenpaar | M (x) | SD (x) | M (y) | SD (y) | r (x, y) |
|---|---|---|---|---|---|
| 1 | 9 | 3.32 | 7.5 | 2.03 | 0.82 |
| 2 | 9 | 3.32 | 7.5 | 2.03 | 0.82 |
| 3 | 9 | 3.32 | 7.5 | 2.03 | 0.82 |
| 4 | 9 | 3.32 | 7.5 | 2.03 | 0.82 |
2 Abbildungen
“…the disputes that for so many generations have vexed philosophers are destroyed by visible certainty, and we are liberated from wordy arguments.” — Galileo Galilei (1610/2016)
In diesem Kapitel lernen Sie, warum Abbildungen für komplexe Datenanalysen unverzichtbar sind, welche konzeptuellen Prinzipien guten Abbildungen zugrunde liegen und wie Sie mit dem Paket ggplot2 sehr effizient auch komplexe Abbildungen erstellen können. Die erste Hälfte des Kapitels ist bewusst konzeptuell: Sie soll Ihnen ein Gespür dafür geben, wann und wozu Sie Abbildungen einsetzen. Die zweite Hälfte ist praktisch und zeigt Schritt für Schritt, wie Sie in R zu publikationsreifen Grafiken kommen.
Galileo hatte recht: Gute Forschungsmethoden erzeugen häufig visible certainty. Während er aber von der Erfindung des Teleskops sprach, kann man dasselbe von modernen Methoden der Datenvisualisierung sagen. Diese macht Zusammenhänge unmittelbar sichtbar, die in einer Tabelle voller Zahlen verborgen bleiben. Abbildungen haben im Kontext von komplexen Forschungsmethoden unterschiedliche Funktionen, die man voneinander abgrenzen kann. Die augenscheinlichste Funktion ist es Analyseergebnisse effektiv an ein Publikum zu kommunizieren. Die zweite Funktion ist es Daten zu explorieren. Wir haben im letzten Kapitel bereits davon gesprochen, dass psychologische Forschung oft hypothesengetrieben ist, es ist aber auch wichtig schnell einzelne Ideen zu Zusammenhängen darstellen zu können. Drittens eignen sich Abbildungen ganz hervorragend um die Daten zu checken und Voraussetzungen zu prüfen. In angewandten Forschungsprojekten gibt es daher ein paar Grafiken, die man nur für sich selbst macht, andere, die man mit Kollegen bespricht und zuletzt solche, die man final publizieren lassen möchte.
2.1 Warum Abbildungen wichtig sind
2.1.1 Anscombes Quartett: Kennwerte können täuschen
Ein statistisches Modell ist immer nur so gut wie die Annahmen, auf denen es beruht. Eine lineare Regression etwa unterstellt einen linearen Zusammenhang, geht von annähernd normalverteilten Residuen aus und reagiert empfindlich auf einzelne Ausreißer. Das Tückische ist: Verletzungen dieser Annahmen schlagen sich häufig gerade nicht in den üblichen Kennwerten wie Mittelwert, Standardabweichung oder Korrelation nieder.
Ein sehr anschauliches Beispiel hierfür wurde von Franxis Anscombe entwickelt, das sog. Anscombes Quartett (Anscombe, 1973). Es besteht aus vier Datenpaaren X und Y Die Tabelle 2.1 fasst die zentralen Kennwerte der vier Datensätze zusammen.
Die Mittelwerte, Standardabweichungen und Korrelationen sind praktisch identisch. Auch die Korrelation ist in allen vier Datenpaaren gleich bei r = 0.82, eine lineare Regression würde für alle vier Datensätze dieselbe Gerade schätzen. Ein Blick auf die zugehörige Abbildung 2.1 offenbart jedoch vier grundverschiedene Situationen:
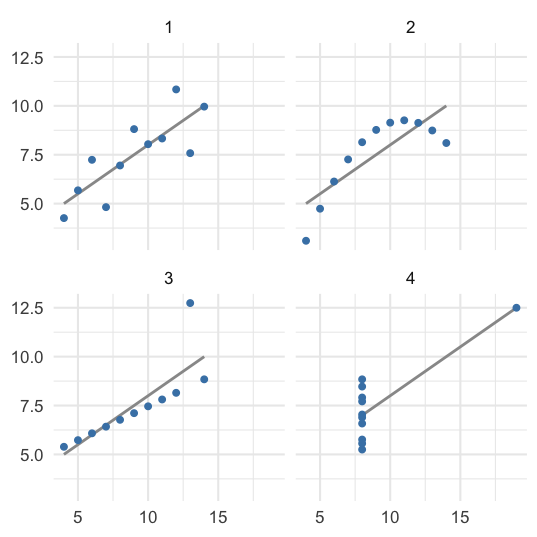
Nur im ersten Datenpaar ist die Annahme eines linearen Zusammenhangs und damit auch die Interpretation eines positiven Zusammenhangs tatsächlich angemessen. Das zweite zeigt einen klar nicht-linearen (quadratischen) Verlauf. Solche Zusammenhänge finden sich immer wieder, wenn man den Zusammenhang zwischen Stress oder Arousal. Während eine zunahme von Stress erstmal dazu führt, dass die Leistung steigt, werden diese Zuwächse immer geringer und kehren sich irgendwann um. Eine gute Erklärung für diesen Verlauf lieferen Beerendonk und Kollegen (2024). Das ist auch für Manager wichtig, die denken, dass sie immer mehr Leistung aus Mitarbeitern herauspressen können. Das dritte Variablenpaar stellt einen perfekten linearen Zusammenhang dar, der durch einen einzigen Ausreißer nach unten verzerrt wird. Das vierte Datenpaar und insbesondere die Korrelation, die man daraus berechnen kann, beruht ganz auf einem einzigen einflussreichen Punkt.
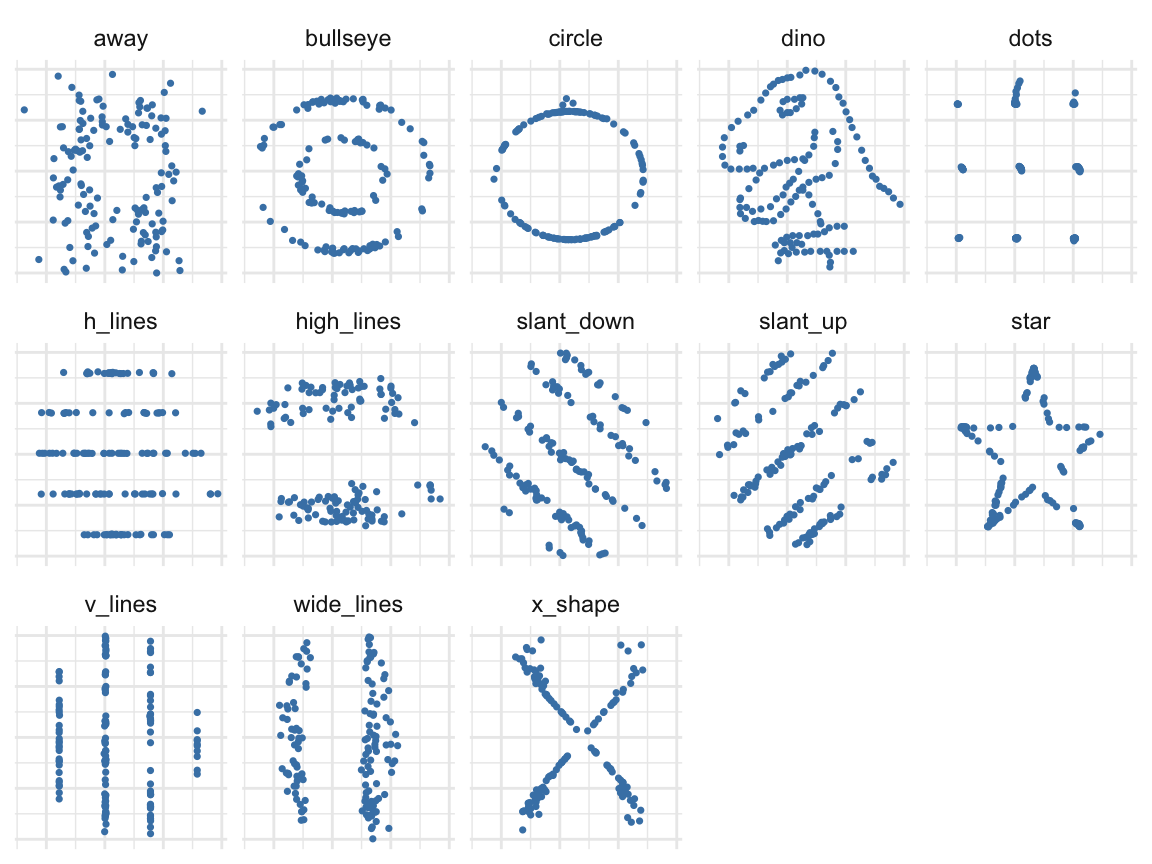
Wichtig ist, dass diese vier nicht die einzigen Sonderfälle sind, die man sich vorstellen kann oder die in der Praxis auch vorkommen. Matejka und Fitzmaurice (2017) erzeugten mit dem Datasaurus Dozen noch viele weitere Datensätze die auch wieder identische numerische Zusammenfassungsstatistiken erzeugen aber alle vollkommen unterschiedlich ausschauen (Abbildung 2.2). Sie sollten sich allso immer die Daten nicht nur deskriptiv als Tabelle sondern auch als Abbildungen anschauen.
“..make both calculations and graphs. Both sorts of output should be studied; each will contribute to understanding.” — F. Anscombe (1973)
2.1.2 Explorative Datenanalyse
Die Idee, Daten nicht nur zur Bestätigung vorab formulierter Hypothesen, sondern auch zur Entdeckung von Struktur zu nutzen, geht auf John Tukey (1977) zurück. Er prägte den Begriff der Explorativen Datenanalyse (Exploratory Data Analysis, EDA) und stellte sie der konfirmatorischen Datenanalyse gegenüber.
EDA unterscheidet zwischen explorativer Datenanalyse (Struktur entdecken, Hypothesen erzeugen) und konfirmatorischer Datenanalyse (vorab festgelegte Hypothesen prüfen).
Beide Modi verfolgen unterschiedliche Ziele:
- Konfirmatorisch: Sie testen eine vorab festgelegte Hypothese mit einem passenden statistischen Verfahren. Die Frage ist bereits gestellt, bevor Sie die Daten sehen.
- Explorativ: Sie befragen die Daten offen. Welche Verteilungen liegen vor? Gibt es unerwartete Gruppen, Zusammenhänge, Auffälligkeiten? Welche Hypothesen legen die Daten überhaupt nahe?
Abbildungen sind das zentrale Werkzeug der EDA. Ein Histogramm deckt Schiefe oder Mehrgipfligkeit auf, ein Streudiagramm zeigt nicht-lineare Zusammenhänge, ein Boxplot pro Gruppe macht unterschiedliche Streuungen sichtbar. Ganz praktisch dient die explorative Grafik auch der Datenqualität: Unmögliche Werte (ein Alter von 200 Jahren), fehlerhafte Kodierungen oder systematisch fehlende Werte fallen im Bild oft sofort auf, während sie in Kennwerten untergehen.
WarnungExplorative Befunde sind Hypothesen, keine Ergebnisse
Die Stärke der EDA ist zugleich ihre Gefahr. Wer lange genug in einem Datensatz sucht, findet fast immer irgendein auffälliges Muster — auch dann, wenn in der Grundgesamtheit gar kein Effekt existiert. Ein rein explorativ „entdeckter” Zusammenhang darf daher nicht ohne Weiteres als bestätigt gelten. Er ist eine Hypothese, die anschließend an neuen Daten konfirmatorisch geprüft werden muss. Diese Trennung ist eigentlich nur dann aufrecht zu erhalten, wenn man die Hypothesen vor der Datenerhebung präregistriert hat.
2.2 Wie man gute Abbildungen erstellt
Nachdem geklärt ist, dass man immer Abbildungen erstellen sollte, stellt sich als nächste Frage wie man möglichst gute Abbildungen erstellt.
2.2.1 Prinzipien guter Abbildungen
Wann ist eine Abbildung gut? Die einflussreichsten Antworten stammen von Edward Tufte, der in einer Reihe von Büchern (2013) sehr anschaulich und nachvollziehbar dargelegt hat, wie man Abbildungen nutzen kann, um besser über die dargestellten Sachverhalte nachdenken zu können und im besten Fall auch bessere Entscheidungen zu treffen.Für unsere Zwecke lassen sich seine Überlegungen auf einige wenige Prinzipien verdichten.
“Graphical excellence is that which gives to the viewer the greatest number of ideas in the shortest time with the least ink in the smallest space” — E. Tufte 1983
Show the data. Aggregierte Darstellungen (etwa reine Balken für Mittelwerte) verbergen die zugrunde liegende Verteilung. Wo es die Datenmenge erlaubt, sollten die Rohdaten sichtbar bleiben — etwa als Punkte, notfalls überlagert mit einer Zusammenfassung.
Grafische Integrität. Eine Abbildung darf nicht mehr behaupten, als die Daten hergeben. Tufte formalisiert das im Lie Factor: dem Verhältnis der im Bild dargestellten Effektgröße zur tatsächlichen Effektgröße in den Daten. Klassische Verstöße sind abgeschnittene y-Achsen, die kleine Unterschiede dramatisch wirken lassen, oder Flächen und Volumina, die eine eindimensionale Größe darstellen und den Effekt dadurch überzeichnen.
Data-Ink-Ratio. Ein möglichst großer Anteil der „Tinte” einer Abbildung sollte tatsächlich Daten darstellen. Alles Übrige — dekorative Rahmen, Schlagschatten, Farbverläufe, überflüssige Gitterlinien — bezeichnet Tufte als Chartjunk. Die Faustregel lautet: Entfernen Sie alles, was Sie weglassen können, ohne dass Information verloren geht.
Datendichte und Small Multiples. Gute Abbildungen zeigen viel Information auf wenig Raum. Ein besonders wirkungsvolles Mittel sind Small Multiples: dieselbe Abbildung, viele Male für verschiedene Teilgruppen wiederholt und nebeneinander angeordnet. Das Auge erkennt Unterschiede zwischen kleinen, gleich aufgebauten Bildern mühelos — Anscombes Quartett oben ist genau ein solches Small-Multiple-Design.
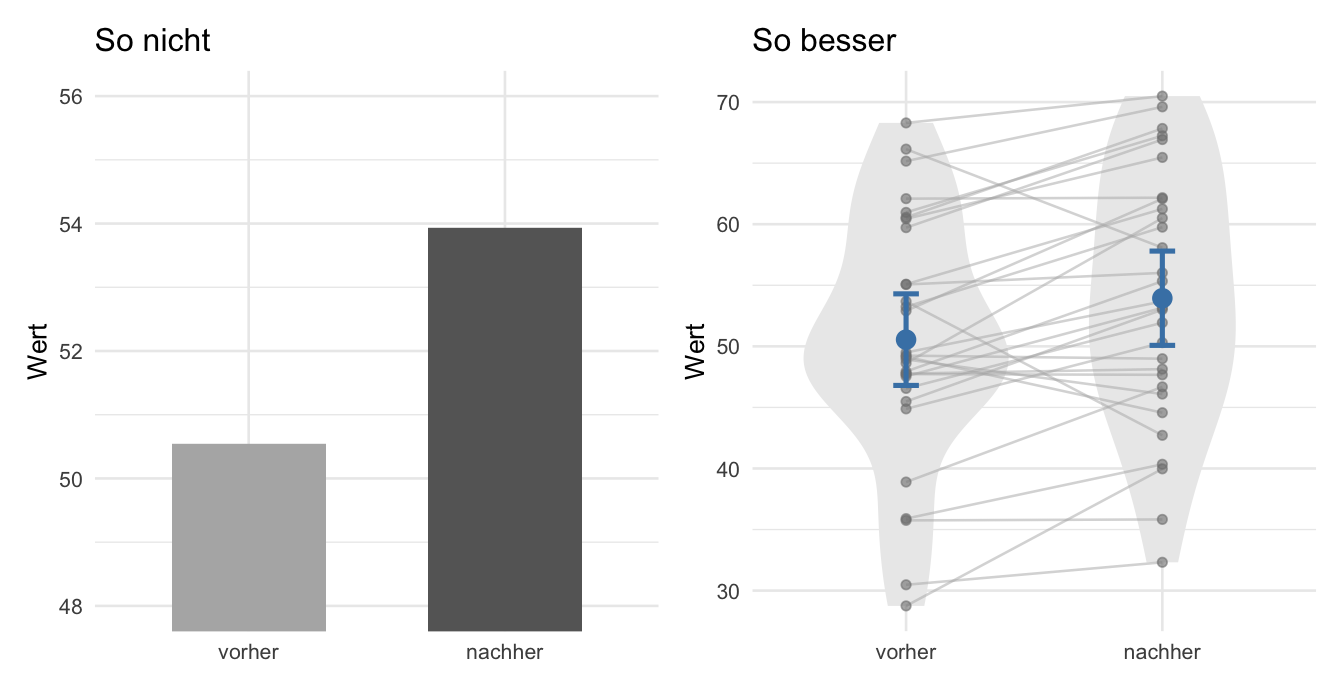
Leider folgen viele der Abbildungen auch in wissenschaftlichen Fachzeitschriften nicht diesen Prinzipien sondern nutzen Abbildungen mit absolut minimalem Informationsgehalt. In der Abbildung 2.3 links sind wenn man ehrlich ist nur zwei Datenpunkte dargestellt, der Mittelwert vorher und der Mittelwert nachher. Es wird sehr viel Tinte und Platz darauf verwendet das darzustellen. Im Gegensatz dazu sind in der Abbildung rechts alle 60 Rohdatenpunkte dargestellt. Auch die gepaarte Natur der Daten wird explizit gemacht und Konfidenzintervalle1 sowie ein Violin-Plot zur Darstellung der Dichteverteilung sind enthalten. Die Rohdaten helfen enorm dabei den Unterschied zu kontextualisieren, während die Verbindungslinien es ermöglichen sofort zu identifizieren, dass sich nur 3 von 30 Personen verschlechtert haben.
2.2.2 Abbildungen für Menschen
Während diese Prinzipien schon einige Anhaltspunkte liefern, ist es auch hilfreich sich ein paar Gedanken dazu zu machen, wie das menschliche visuelle System funktioniert. Unser visuelles System ist auf bestimmte Merkmale in der Umwelt spezialisiert, die es mühelos und sehr genau unterscheiden kann. Andere visuelle Merkmale können wir Menschen nur grob und manche gar nicht unterscheiden. Ein gutes Beispiel hierfür ist das Farbensehen. Rund 8 % der Männer und 0,5 % der Frauen haben eine Farbfehlsichtigkeit, die es ihnen unmöglich macht Rot und Grün zu unterscheiden. Eine Abbildung, die ihre Information allein über die Unterscheidung von Rot und Grün transportiert, ist für diese Personen nicht lesbar. Daraus folgen zwei Regeln, die wir im praktischen Teil umsetzen: Verlassen Sie sich nie auf Farbe allein — stützen Sie eine Farbkodierung zusätzlich durch Form, Beschriftung oder Position ab —, und verwenden Sie farbfehlsichtigkeitssichere Farbpaletten wie das später vorgestellte viridis-Schema.
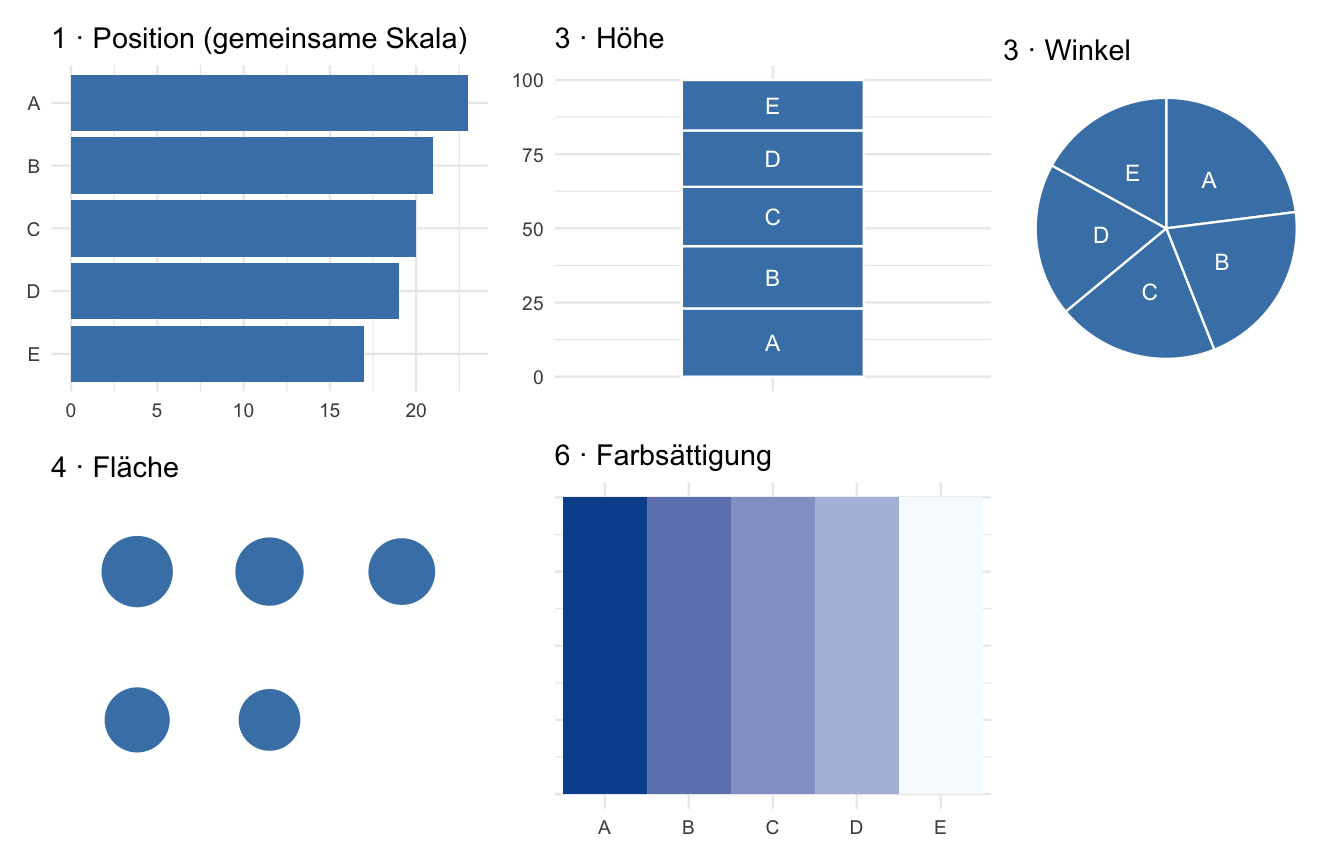
Dass sich Wahrnehmung von Abbildungen systematisch untersuchen lässt, macht sie zum Gegenstand einer Subdisziplin der Wahrnehmungspsychologie: der sog. grafischen Wahrnehmung (graphical perception). Die Grundfrage dieser Forschungsrichtung ist eigentlich recht einfach: Wenn eine Zahl auf eine visuelle Eigenschaft abgebildet wird — auf eine Länge, einen Winkel, eine Fläche, einen Farbton —, wie genau kann eine Betrachterin diese Zahl anschließend wieder ablesen? Die ersten die dies systematisch experimentell untersuchten waren Cleveland und McGill (1984). Sie erstellten unterschiedliche Abbdildungen wie die in Abbildung 2.4 dargestellten und baten dann Probanden die Werte aus den einzelnen Abbildungen abzulesen. Aus der Genauigkeit mit der den Probanden dies galang, bildeten sie eine Rangreihe von der genauesten zur ungenauesten Kodierung:
- Position auf einer gemeinsamen Skala (z. B. Balkenenden oder Punkte an derselben Achse)
- Position auf getrennten, aber gleich skalierten Achsen
- Länge, Richtung, Winkel/Steigung
- Fläche
- Volumen, Krümmung
- Farbsättigung und Helligkeit
Daraus folgt eine einfache Entwurfsregel, die wir bei der praktischen Umsetzung immer wieder anwenden werden: Kodieren Sie die wichtigste quantitative Aussage über Position oder Länge und reservieren Sie schwächere Kanäle wie Farbe oder Fläche für kategoriale oder nachrangige Information. Wenn Sie Farben verwenden, achten Sie bitte auch darauf Farbpaletten zu verwenden, die auch für Menschen mit rot-grün Fehlsichtigkeit und auch in SW ausgedruckt zu lesen sind.
2.2.3 Abbildungen und Unsicherheit
Bisher ging es um die Form der Darstellung. Ein weiterer Strang der Methodendiskussion betrifft ihren Inhalt: Was genau soll eine Ergebnisabbildung zeigen? Die New Statistics (Cumming & Calin-Jageman, 2017) plädieren für einen Wechsel von der dichotomen Signifikanzentscheidung („signifikant — ja oder nein?“) hin zum Schätzen: Im Zentrum stehen Effektgrößen und ihre Unsicherheit. Das hat auch auswirkungen auf die Gestaltung von Abbildungen. Eine gute Ergebnisabbildung zeigt idealerweise dreierlei zugleich: die Schätzung (z. B. den Gruppenmittelwert), ihre Unsicherheit (meist ein 95%-Konfidenzintervall) und, wo möglich, die Rohdaten. Das ergänzt Tuftes „show the data” um ein „show the uncertainty”.
Fehlerbalken sind dabei allerdings nur so nützlich wie ihre Beschriftung. Dieselben „Whisker” können die Standardabweichung (die Streuung der Daten), den Standardfehler (die Präzision des Mittelwerts, etwa \(SD/\sqrt{n}\)) oder ein Konfidenzintervall (bei großem \(n\) ungefähr zwei Standardfehler) darstellen. Alle drei sehen identisch aus, bedeuten aber völlig Verschiedenes. Ein Fehlerbalken ohne Angabe, wofür er steht, ist uninterpretierbar — geben Sie es daher stets in der Bildunterschrift oder Legende an.
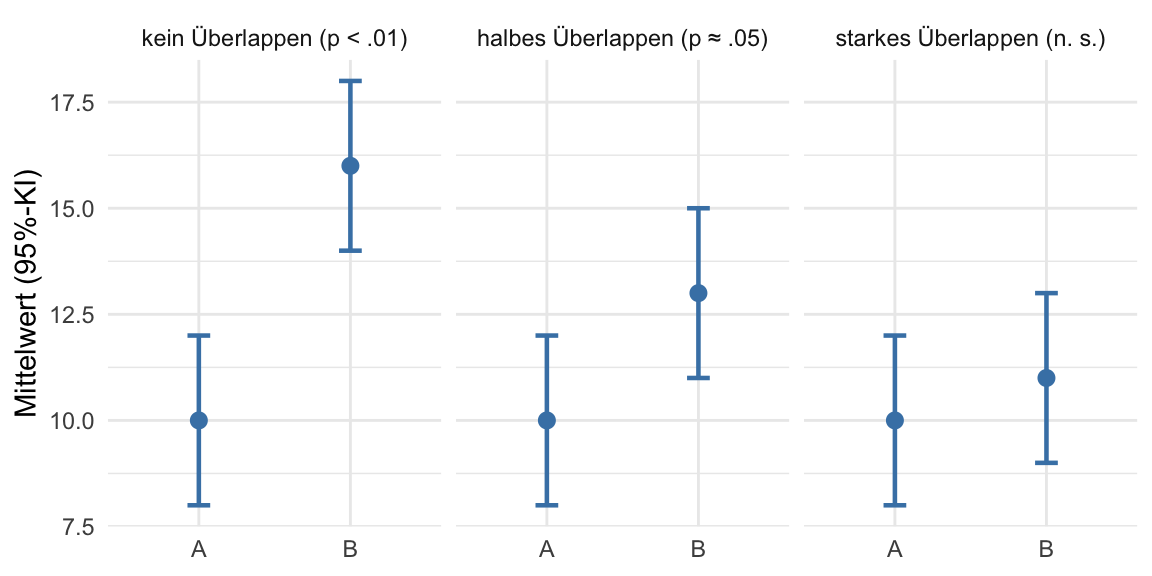
Cumming und Finch (2005) zeigen zudem, dass sich aus Konfidenzintervallen „mit dem Auge” auf Signifikanz schließen lässt: Überlappen die 95%-Intervalle zweier Mittelwerte nur wenig, ist der Unterschied etwa auf dem 5%-Niveau signifikant. Abbildung 2.5 veranschaulicht diese rules of eye an drei Szenarien mit unabhängigen Gruppen 2.
2.2.4 Geklickt oder programmiert?
Grundsätzlich gibt es zwei Wege, eine Abbildung am Computer zu erzeugen. Beim ersten klicken Sie sich in einer grafischen Oberfläche (Excel, SPSS-Menüs, GraphPad) durch Dialoge und schieben Elemente von Hand zurecht. Beim zweiten beschreiben Sie die Abbildung in Code und lassen sie vom Programm erzeugen.
Für die tägliche Arbeit erscheint der geklickte Weg zunächst schneller. Für wissenschaftliches oder auch effizentes Arbeiten in der Wirtschaft ist der programmierte Weg jedoch klar überlegen:
- Reproduzierbarkeit: Der Code dokumentiert exakt und vollständig, wie die Abbildung entstanden ist. Jede*r kann sie aus den Rohdaten identisch reproduzieren. Auch Sie selbst können kritischen Kollegen ganz genau nachweisen, wie sie etwas erstellt haben.
- Aktualisierbarkeit: Kommen neue Daten hinzu oder ändert sich eine Kodierung, erzeugen Sie die gesamte Abbildung mit einem Tastendruck neu, ohne erneutes Zurechtklicken.
- Konsistenz: Über ein gemeinsames Theme sehen alle Abbildungen einer Arbeit einheitlich aus. Gerade für wiederkehrende Aufgaben wie Quartalsberichte ist das ein klarer Vorteil.
- Skalierbarkeit: Zwanzig Abbildungen für zwanzig Teilstichproben sind eine Schleife, keine zwanzig Nachmittage. Insofern erlauben diese Abbildungen einen wirklich ganz neuen Zugang zu den zugrundeliegenden Daten.
Diese Vorteile sind der Kern des Prinzips der reproduzierbaren Forschung, und sie sind der Grund, warum wir Abbildungen in R programmieren.
2.2.5 Beispieldatensatz
Wir nutzen im weiteren Verlauf den penguins Datensatz aus dem Paket palmerpenguins als Beispiel. Er enthält Körpermaße von 344 Pinguinen dreier Arten, die auf dem Palmer-Archipel in der Antarktis erfasst wurden. Für uns interessant sind vor allem flipper_length_mm (Flossenlänge in mm), body_mass_g (Körpergewicht in Gramm) und bill_length_mm (Schnabellänge in mm) sowie die kategorialen Variablen species (Art) und sex (Geschlecht).
glimpse(penguins)Rows: 344
Columns: 8
$ species <fct> Adelie, Adelie, Adelie, Adelie, Adelie, Adelie, Adel…
$ island <fct> Torgersen, Torgersen, Torgersen, Torgersen, Torgerse…
$ bill_length_mm <dbl> 39.1, 39.5, 40.3, NA, 36.7, 39.3, 38.9, 39.2, 34.1, …
$ bill_depth_mm <dbl> 18.7, 17.4, 18.0, NA, 19.3, 20.6, 17.8, 19.6, 18.1, …
$ flipper_length_mm <int> 181, 186, 195, NA, 193, 190, 181, 195, 193, 190, 186…
$ body_mass_g <int> 3750, 3800, 3250, NA, 3450, 3650, 3625, 4675, 3475, …
$ sex <fct> male, female, female, NA, female, male, female, male…
$ year <int> 2007, 2007, 2007, 2007, 2007, 2007, 2007, 2007, 2007…
Hinweis
Der Datensatz steckt im Paket palmerpenguins, das Sie ggf. einmalig mit install.packages("palmerpenguins") installieren müssen. ´
2.2.6 Base R oder ggplot2?
R bringt bereits ein eigenes Grafiksystem mit (die Funktionen hist(), boxplot(), plot()), mit denen man schnell Histogramme, Streudiagramme und Boxplots erstellen kann.
par(mfrow = c(1, 3)) # Um Abbildungen nebeneinander darzustellen.
hist(penguins$body_mass_g)
boxplot(penguins$body_mass_g)
plot(penguins$body_mass_g, penguins$flipper_length_mm)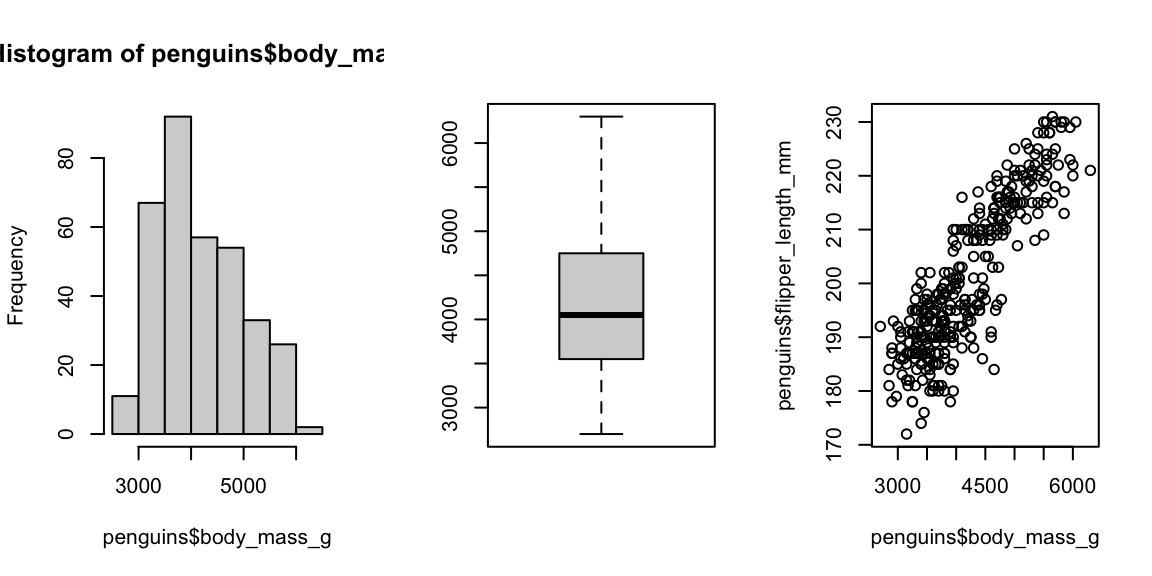
Für explorative Ad-hoc-Plots sind diese Arten der Abbildung völlig ausreichend. Sobald Abbildungen aber komplexer und publikationsreif werden sollen, stößt das base-R-System an Grenzen: Jede zusätzliche Ebene, jede Gruppierung, jede Legende muss von Hand ergänzt werden. Genau das wird in ggplot2 anders gelöst und zwar auf Basis einer durchdachten Theorie von Abbildungen, der Grammar of Graphics.
2.3 Die Grammar of Graphics und ggplot2
Die Grammar of Graphics wurde von Leland Wilkinson (2012) entwickelt und von Hadley Wickham (2010) in eine praktisch umsetzbare, „geschichtete” (engl. layered) Form gebracht, die zur Grundlage von ggplot2 wurde. Die Grundidee ist so elegant wie folgenreich: Statt für jeden Diagrammtyp (Balken, Linie, Streuung …) eine eigene Spezialfunktion vorzuhalten, zerlegt man jede statistische Abbildung in dieselben wenigen, kombinierbaren Bausteine. Ein Diagramm ist dann keine feste Vorlage mehr, sondern eine Grammatik, d.h. ein Satz von Komponenten, aus denen man Abbildungen frei zusammensetzen kann. Die wichtigsten Kompenenten sind in Tabelle 2.2 zusammengefasst.
| Komponente | Bedeutung | In ggplot2 |
|---|---|---|
| Data | die zugrunde liegenden Daten | ggplot(data = ...) |
| Aesthetics | Zuordnung von Variablen zu grafischen Eigenschaften (Achsen, Farbe, Größe …) | aes(...) |
| Geometries | die geometrische Repräsentation (Punkte, Linien, Balken …) | geom_*() |
| Statistics | statistische Transformationen der Daten (Zählen, Glätten …) | stat_*() |
| Scales | Übersetzung von Datenwerten in konkrete Achsen- und Farbskalen | scale_*() |
| Facets | Aufteilung in Teilabbildungen (Small Multiples) | facet_*() |
| Coordinates | das Koordinatensystem | coord_*() |
| Theme | das nicht-datenbezogene Erscheinungsbild | theme_*() |
Der entscheidende Punkt: Diese Bausteine sind unabhängig voneinander und lassen sich frei kombinieren. Wechseln Sie das geom von Punkten zu Linien, bleibt alles andere gleich. Fügen Sie eine Farb-Aesthetic hinzu, gilt sie automatisch für alle Ebenen. Aus wenigen Bausteinen entsteht so eine praktisch unbegrenzte Vielfalt von Abbildungen.
2.3.1 Der Grundaufbau einer ggplot-Abbildung
Jede ggplot2-Abbildung beginnt mit der Funktion ggplot(), der Sie die Daten und über aes() die Aesthetic Mappings übergeben. Für sich genommen erzeugt das nur eine leere Zeichenfläche mit passend skalierten Achsen, es fehlt noch das geom, das festlegt, wie die Daten dargestellt werden.
ggplot(data = penguins, mapping = aes(x = flipper_length_mm, y = body_mass_g))
Ebenen aka Layers werden mit dem +-Operator hinzugefügt. Fügen wir geom_point() hinzu, entsteht ein Streudiagramm:
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g)) +
  geom_point()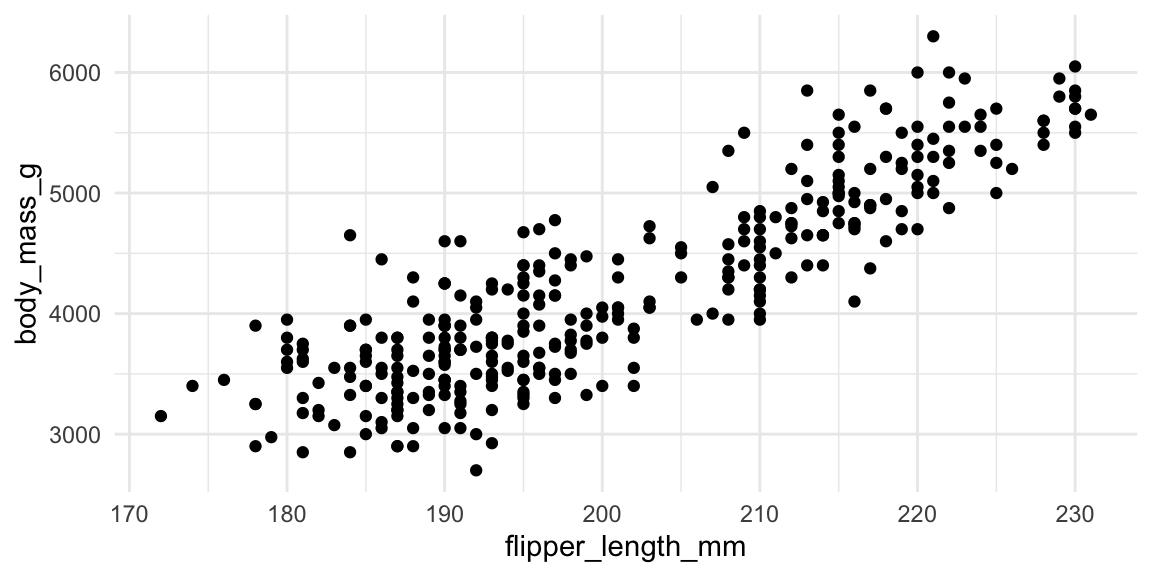
Man erkennt sofort einen klaren positiven Zusammenhang: Pinguine mit längeren Flossen sind in der Regel schwerer. Übrigens sind die Argumentnamen data = und mapping = optional, da sie an erster und zweiter Stelle stehen, lässt man sie üblicherweise weg, wie in diesem und allen folgenden Beispielen.
2.3.2 Aesthetics: Variablen abbilden
Eine Aesthetic ist eine visuelle Eigenschaft, auf die eine Variable abgebildet wird. Neben x und y gehören dazu insbesondere color, fill, shape, size und alpha (Transparenz). Bilden wir die Art auf die Farbe ab:
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g, color = species)) +
  geom_point()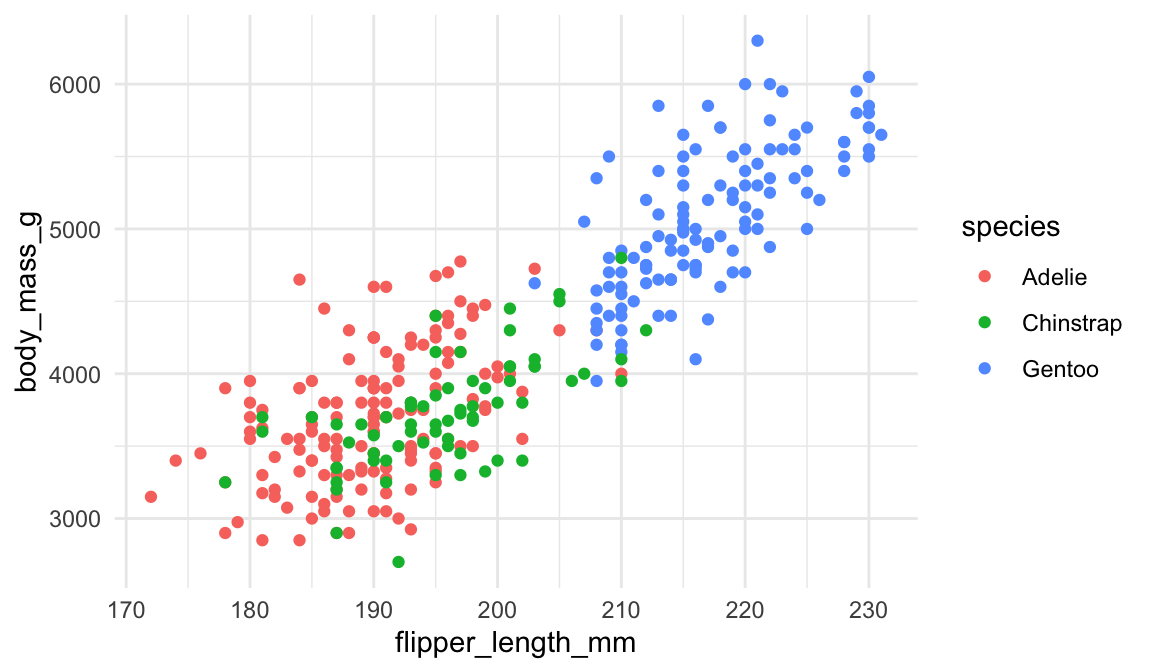
Nun wird deutlich, dass sich die Punktwolke in die drei Arten auffächert: Die Gentoo-Pinguine bilden die Gruppe mit langen Flossen und hohem Gewicht oben rechts, während sich Adelie und Chinstrap im unteren Bereich stärker überlappen.
2.3.3 Geome
Das geom bestimmt die geometrische Repräsentation. Dieselben Daten lassen sich durch einfaches Austauschen des geom völlig unterschiedlich darstellen. Ein Boxplot des Körpergewichts pro Art:
ggplot(penguins, aes(x = species, y = body_mass_g)) +
  geom_boxplot()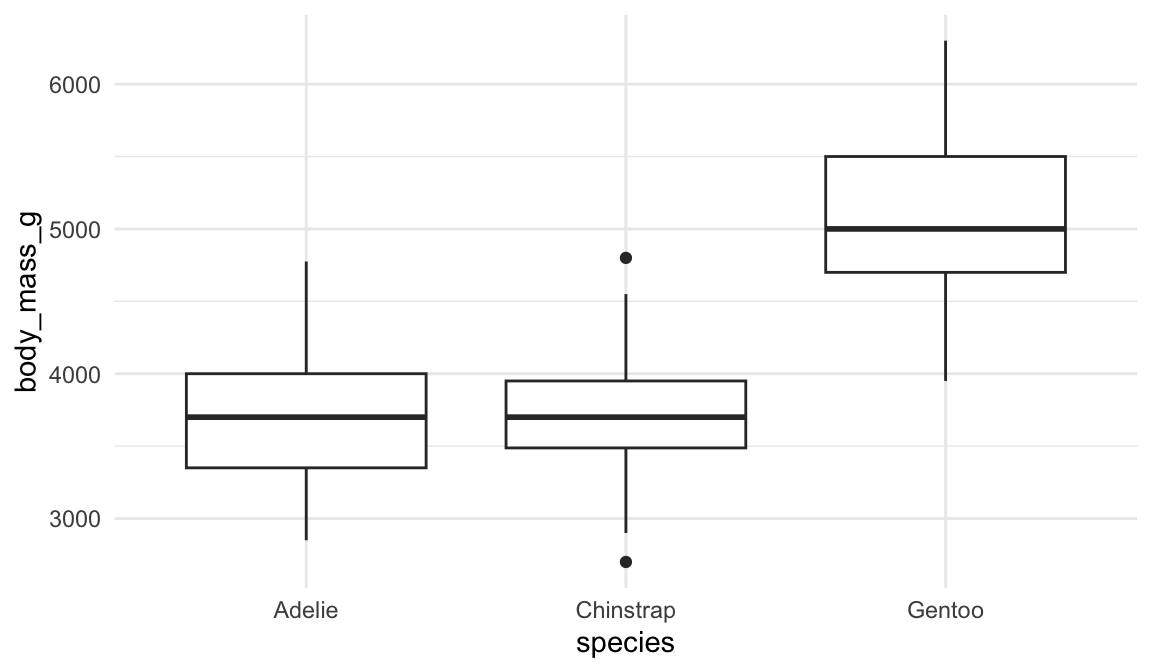
Für eine einzelne kontinuierliche Variable eignen sich Histogramm oder Dichtekurve:
ggplot(penguins, aes(x = flipper_length_mm)) +
  geom_histogram(binwidth = 2)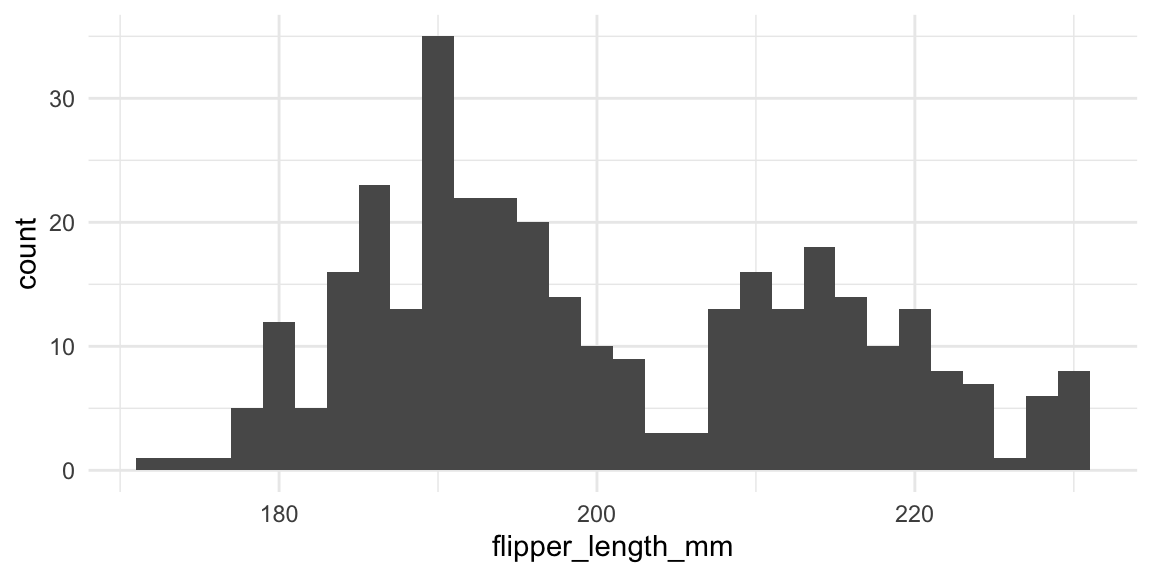
Die deutliche Zweigipfligkeit der Flossenlänge ist ein typischer EDA-Befund: Sie deutet auf Untergruppen hin — tatsächlich hat die (größere) Gentoo-Art erheblich längere Flossen als die beiden anderen Arten. In keinem einzelnen Kennwert wäre diese Struktur sichtbar gewesen.
Hinweis
Beim Histogramm lohnt es sich fast immer, die Klassenbreite bewusst über binwidth (oder die Anzahl über bins) zu setzen. Der Standardwert (bins = 30) ist selten optimal, und ggplot2 weist Sie mit einer Meldung darauf hin.
2.3.4 Mehrere Ebenen kombinieren
Die volle Stärke der Grammatik zeigt sich, wenn Sie mehrere geoms übereinanderlegen. Wir kombinieren die Rohdaten (Punkte) mit einer geglätteten Trendlinie:
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g)) +
  geom_point() +
  geom_smooth(method = "lm")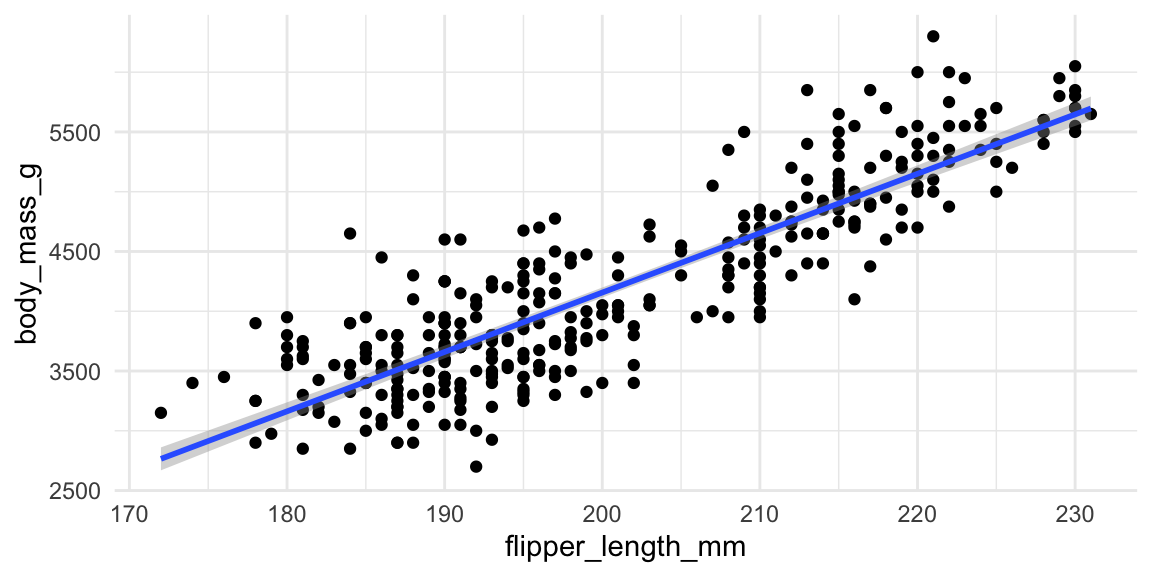
Aesthetics, die Sie im ggplot()-Aufruf angeben, gelten für alle Ebenen. Ergänzen wir eine Farb-Aesthetic für die Art, wird sowohl nach Farbe gepunktet als auch je Gruppe eine eigene Gerade geschätzt:
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g, color = species)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE)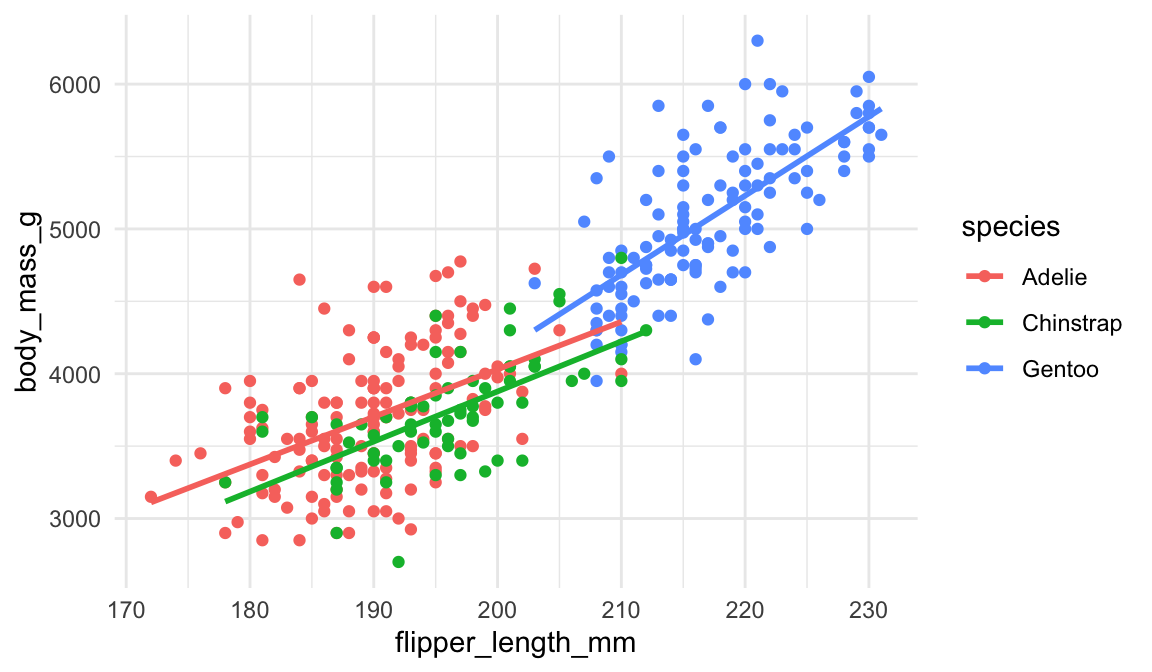
2.3.5 Statistische Transformationen
Manche geoms zeichnen nicht die Rohdaten, sondern eine statistische Transformation davon. geom_bar() etwa zählt im Hintergrund die Häufigkeiten je Kategorie (die Statistik count):
ggplot(penguins, aes(x = species)) +
  geom_bar()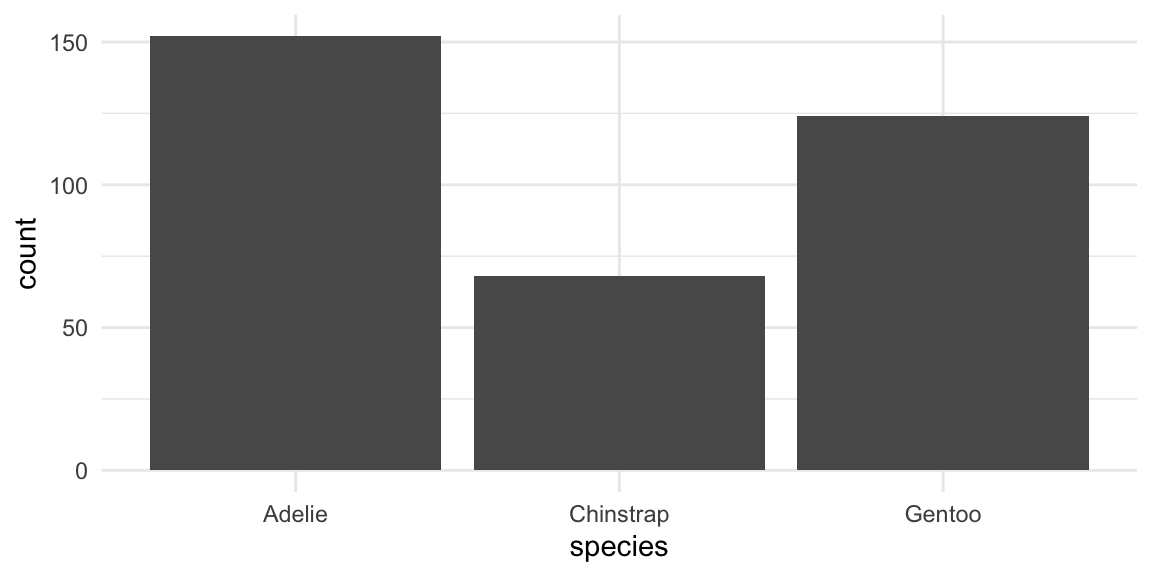
Häufig möchten Sie aber nicht Häufigkeiten, sondern Zusammenfassungen wie Mittelwerte mit Streuungsmaß darstellen. stat_summary() erlaubt das flexibel:
ggplot(penguins, aes(x = species, y = body_mass_g)) +
  stat_summary(fun = mean, geom = "point", size = 3) +
  stat_summary(fun.data = mean_se, geom = "errorbar", width = 0.2)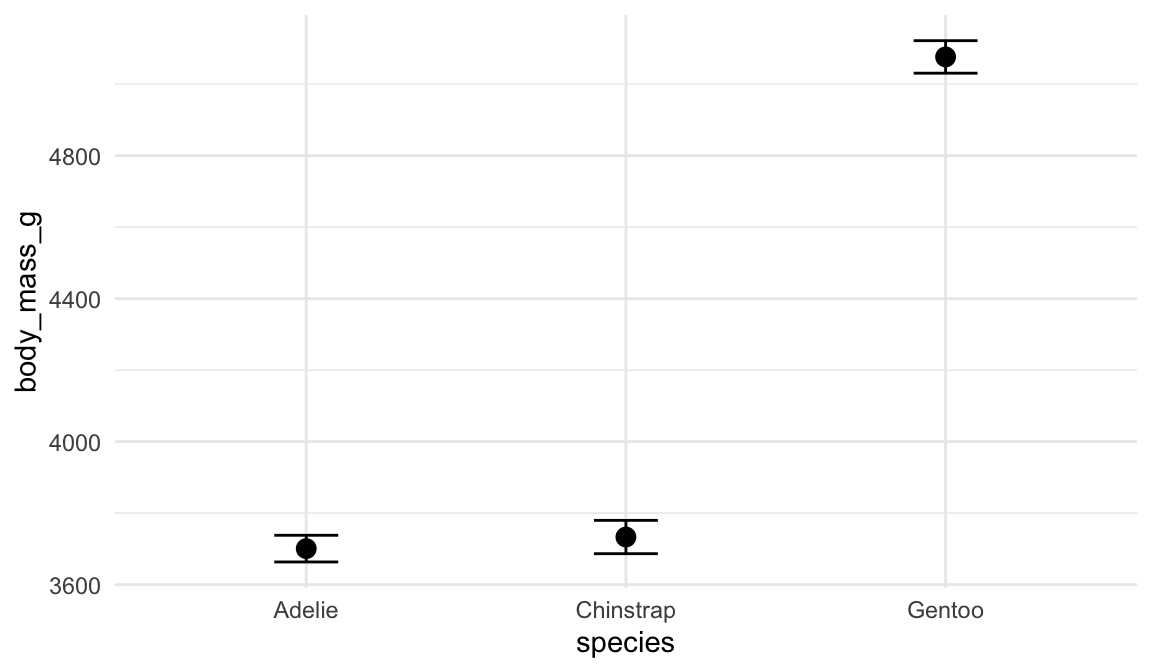
Den größten Erkenntniswert hat eine solche Zusammenfassung, wenn sie die Rohdaten und die Unsicherheit der Schätzung zeigt (siehe Abschnitt „Abbildungen und Unsicherheit”). Für ein 95%-Konfidenzintervall berechnen wir dessen Grenzen einmalig selbst und legen Mittelwert und Fehlerbalken über die leicht gejitterten Rohdaten:
ggplot(penguins, aes(x = species, y = body_mass_g)) +
  geom_jitter(width = 0.08, alpha = 0.3) +
  stat_summary(fun.data = mean_cl_boot, col = "red") +
  labs(x = "Art", y = "Körpergewicht (g)")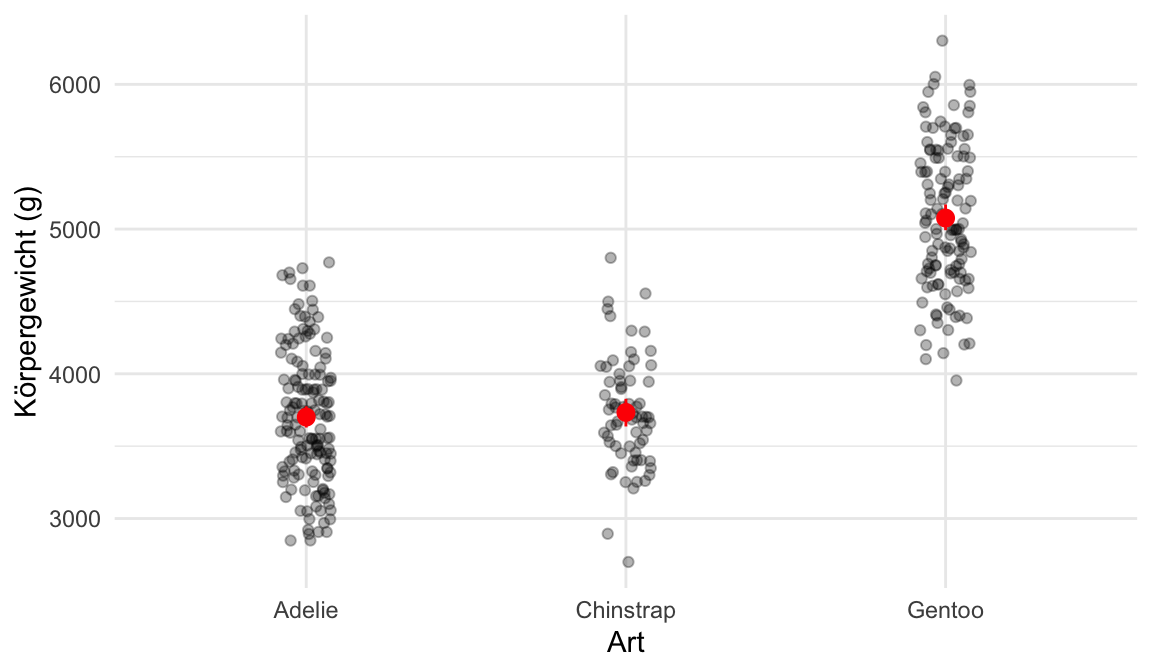
Tipp
Die Bildunterschrift nennt ausdrücklich, wofür die Fehlerbalken stehen (95%-KI des Mittelwerts). Ohne diese Angabe wäre die Abbildung nicht interpretierbar, da unklar wäre, ob die Fehlerbalken Konfidenzintervalle, eine Standardabweichung oder einen Standardfehler zeigen.
2.3.6 Position adjustments
Wenn sich Elemente überlagern, steuert das position-Argument, wie sie angeordnet werden. Bei gruppierten Balken sind die drei wichtigsten Varianten "stack", "dodge" und "fill" (vgl. Abb. 2.17). Der Standard "stack" stapelt die Gruppen aufeinander. "dodge" stellt die Balken nebeneinander — am besten geeignet, um die Gruppen direkt zu vergleichen. Zuletzt normiert "fill" jede Säule auf 100 % und zeigt damit Anteile statt absoluter Häufigkeiten:
library(patchwork)

pinguine_sex <- drop_na(penguins, sex)

p_stack <- ggplot(pinguine_sex, aes(x = species, fill = sex)) +
  geom_bar(position = "stack") +
  labs(title = "stack", x = NULL, y = "Anzahl")

p_dodge <- ggplot(pinguine_sex, aes(x = species, fill = sex)) +
  geom_bar(position = "dodge") +
  labs(title = "dodge", x = NULL, y = "Anzahl")

p_fill <- ggplot(pinguine_sex, aes(x = species, fill = sex)) +
  geom_bar(position = "fill") +
  labs(title = "fill", x = NULL, y = "Anteil")

p_stack + p_dodge + p_fill + plot_layout(guides = "collect")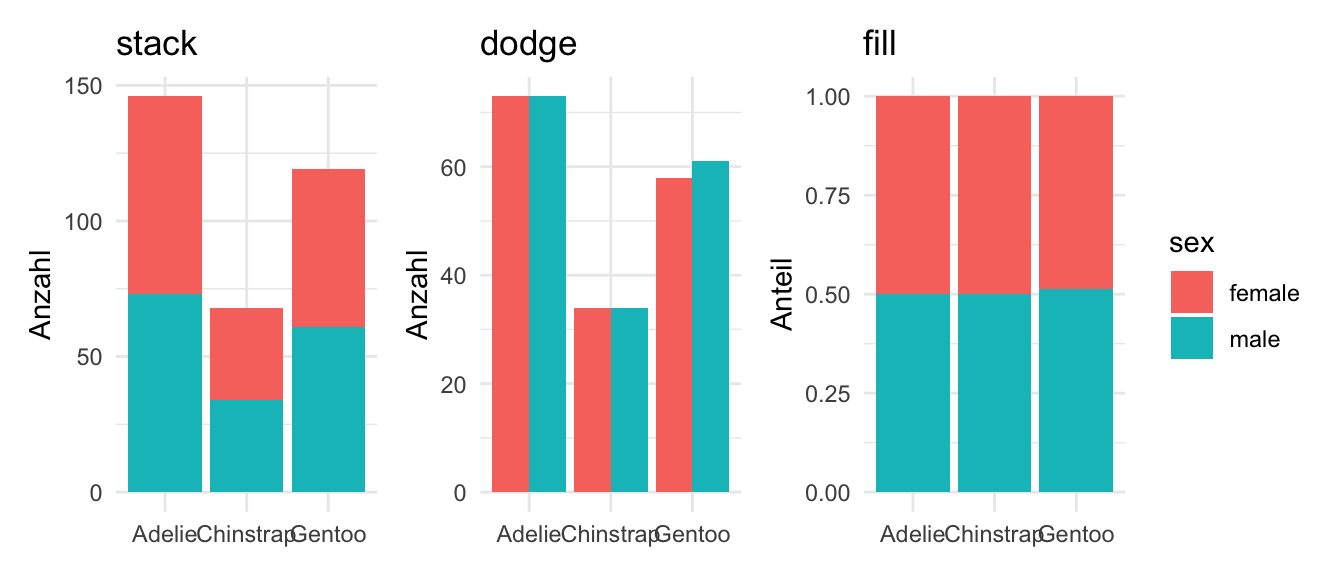
Für Streudiagramme mit vielen überlappenden Punkten ist position = "jitter" nützlich: Es verrauscht die Positionen minimal und macht so die tatsächliche Punktdichte sichtbar. Die Kurzform ist geom_jitter().
2.3.7 Skalen
Scales übersetzen Datenwerte in konkrete visuelle Werte — welche Zahl liegt wo auf der Achse, welche Kategorie bekommt welche Farbe. Für jede Aesthetic gibt es passende scale_*()-Funktionen.
Besonders häufig passt man Farbskalen an. Hier kommt die im konzeptuellen Teil angesprochene Barrierefreiheit ins Spiel: Die Standardpalette von ggplot2 ist für farbfehlsichtige Personen nicht ideal. Die viridis-Paletten wurden genau dafür entworfen. Sie sind perzeptuell uniform — gleiche Abstände im Farbwert entsprechen gleichen wahrgenommenen Abständen —, bleiben auch bei einer Rot-Grün-Schwäche unterscheidbar und funktionieren sogar in Graustufen. Sie sind direkt in ggplot2 eingebaut (kein Zusatzpaket nötig) und über scale_color_viridis_*() bzw. scale_fill_viridis_*() erreichbar. Das Suffix wählt den Skalentyp: _d für diskrete (kategoriale), _c für kontinuierliche Variablen.
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g, color = species)) +
  geom_point() +
  scale_color_viridis_d()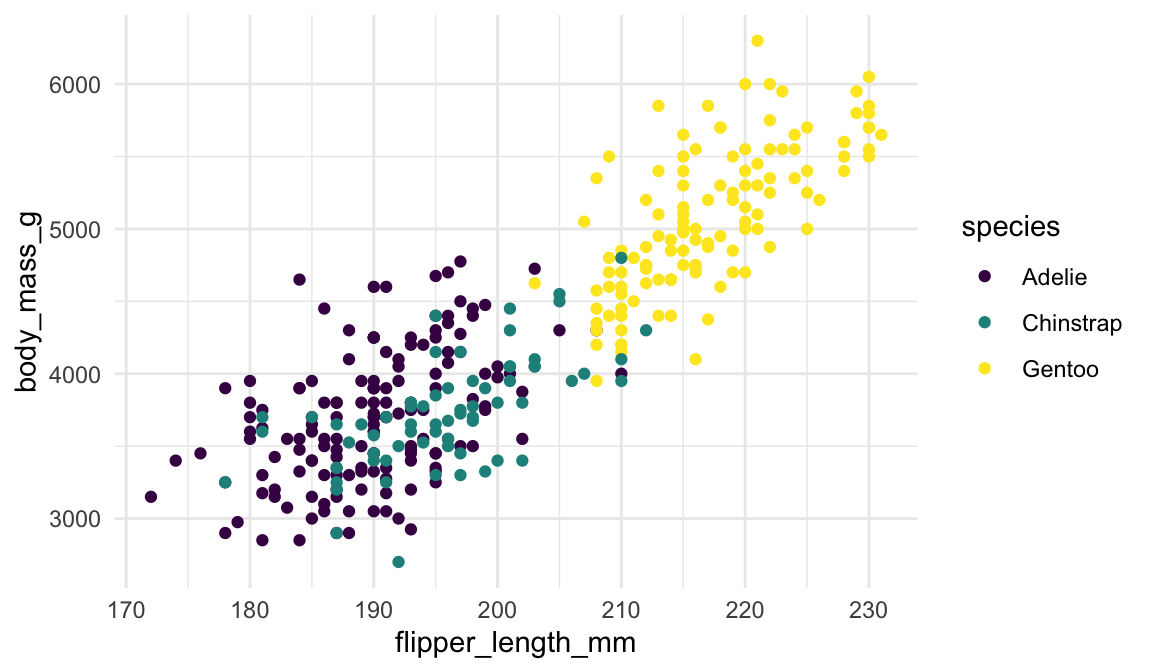
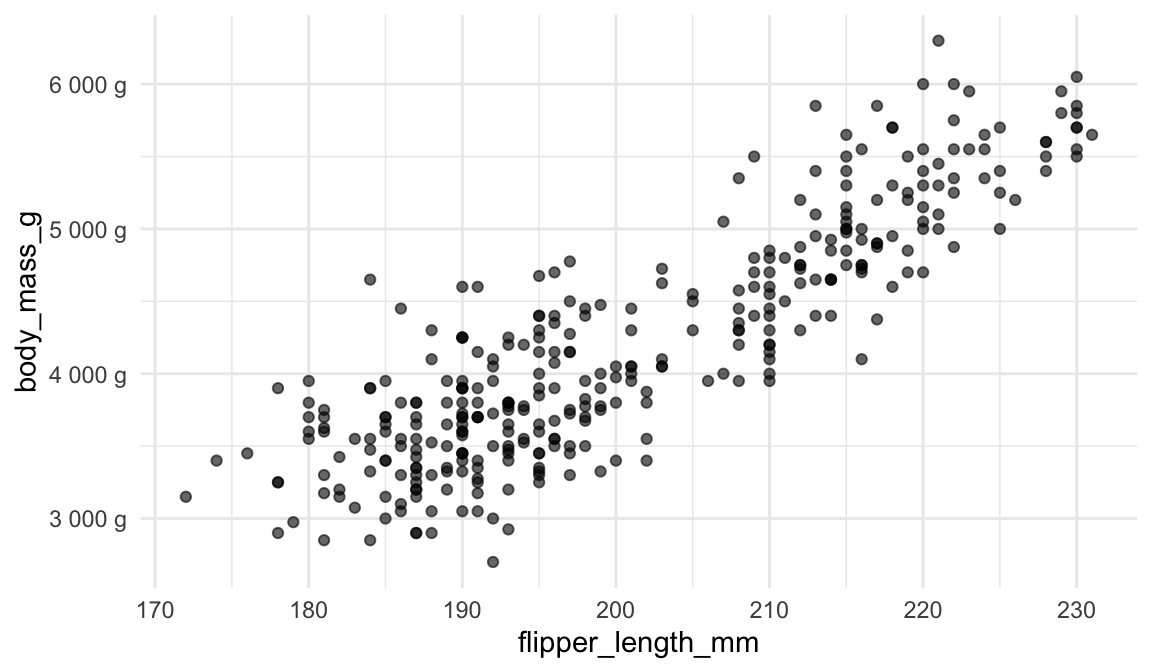
Auch Achsen sind Skalen. Über scale_*_continuous() steuern Sie die Achsenabschnitte (breaks), deren Beschriftung (labels) und den sichtbaren Bereich (limits):
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g)) +
  geom_point(alpha = 0.6) +
  scale_y_continuous(
    breaks = seq(3000, 6000, by = 1000),
    labels = scales::label_number(suffix = " g")
  )
Für stark rechtsschiefe Variablen — etwa Einkommen oder Reaktionszeiten — bietet sich zudem eine logarithmische Achse an, die Sie einfach über scale_x_log10() bzw. scale_y_log10() erhalten.
2.3.8 Facetten: Small Multiples
Das Facetting setzt das oben beschriebene Small-Multiples-Prinzip um: Es zerlegt die Daten nach einer (oder zwei) kategorialen Variablen und zeichnet dieselbe Abbildung für jede Teilmenge. facet_wrap() teilt nach einer Variablen auf:
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g)) +
  geom_point() +
  facet_wrap(~ species)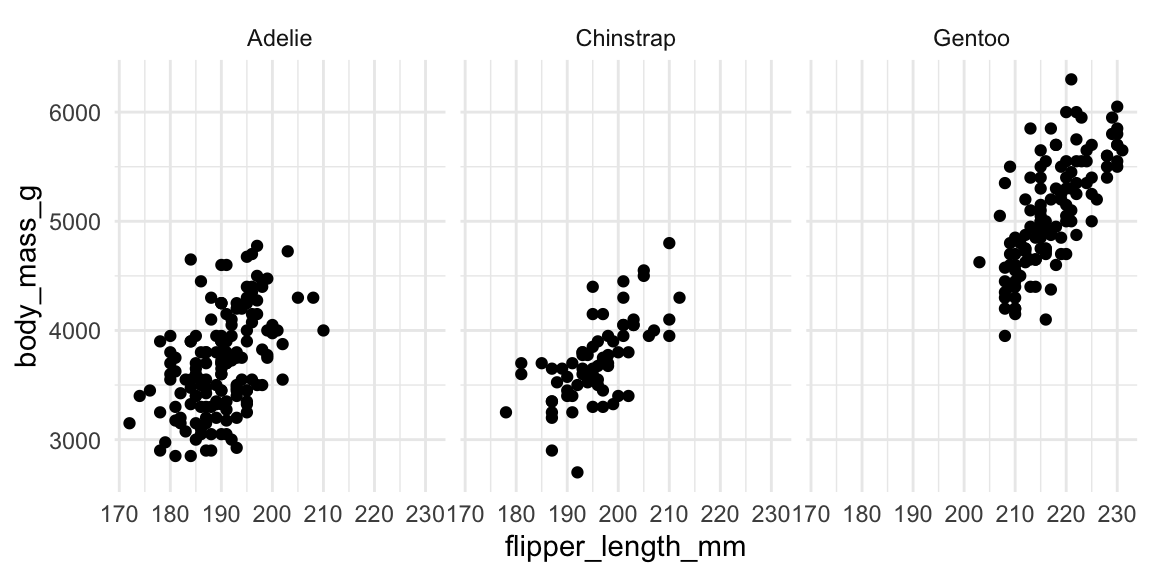
facet_grid() bildet ein Gitter aus zwei Variablen (Zeilen ~ Spalten) und eignet sich, um zwei Faktoren gleichzeitig zu betrachten:
ggplot(drop_na(penguins, sex), aes(x = flipper_length_mm, y = body_mass_g)) +
  geom_point() +
  facet_grid(species ~ sex)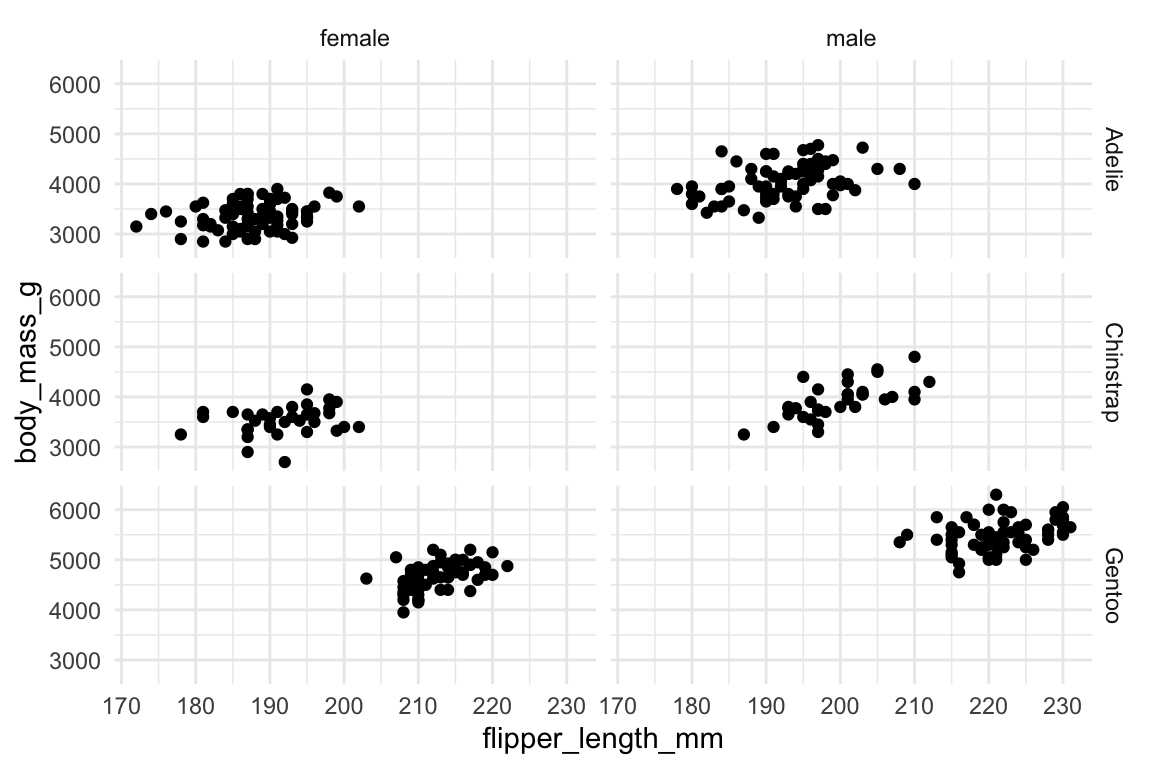
Facetting ist eines der wirksamsten Mittel überhaupt, um komplexe, mehrdimensionale Zusammenhänge übersichtlich darzustellen — und in ggplot2 kostet es genau eine Zeile.
2.3.9 Koordinatensysteme
Standardmäßig verwendet ggplot2 ein kartesisches Koordinatensystem. coord_flip() vertauscht die Achsen, was bei langen Kategorienamen die Lesbarkeit verbessert. coord_cartesian() erlaubt es, in einen Ausschnitt zu „zoomen”, ohne dabei Datenpunkte zu entfernen (was Kennwerte wie Trendlinien verfälschen würde):
ggplot(penguins, aes(x = species, y = body_mass_g)) +
  geom_boxplot() +
  coord_flip()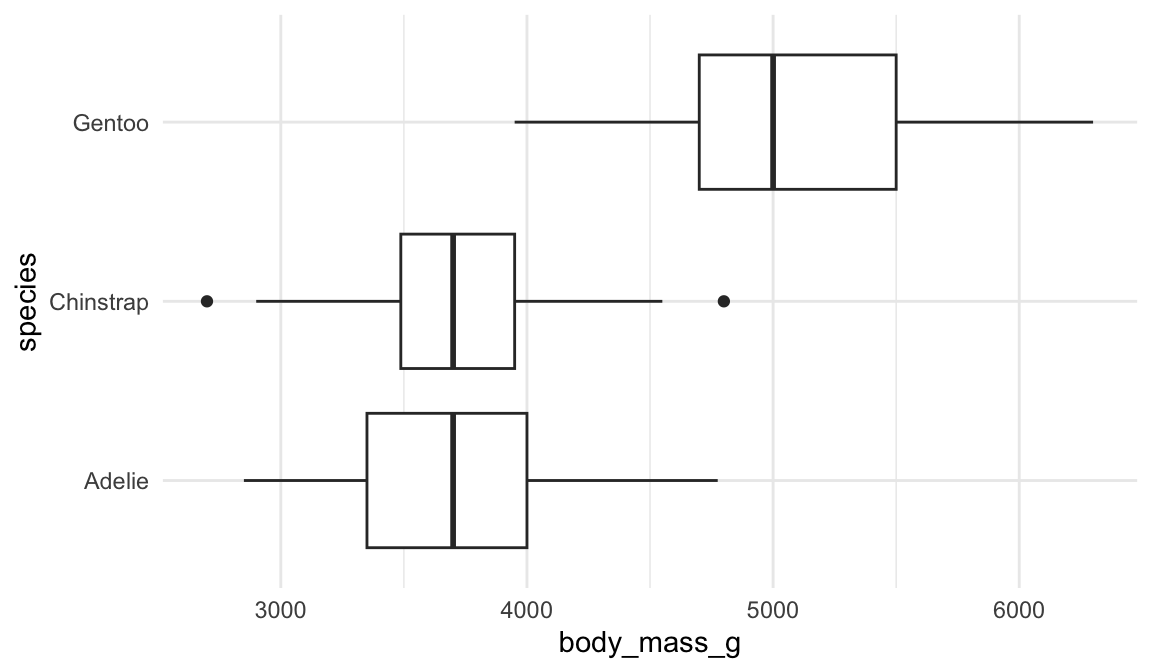
2.3.10 Beschriftung und Themes
Zu einer publikationsreifen Abbildung gehören informative Beschriftungen. labs() steuert Titel, Achsen- und Legendentitel sowie eine Quellenangabe (caption). Das Theme bestimmt das gesamte nicht-datenbezogene Erscheinungsbild — Schriftgrößen, Gitterlinien, Hintergrund. ggplot2 bringt eine Reihe fertiger Themes mit (theme_minimal(), theme_classic(), theme_bw() …), und einzelne Elemente lassen sich über theme() gezielt anpassen:
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g, color = species)) +
  geom_point() +
  scale_color_viridis_d() +
  labs(
    title = "Längere Flossen, schwerere Pinguine",
    subtitle = "Körpermaße von 344 Pinguinen des Palmer-Archipels",
    x = "Flossenlänge (mm)",
    y = "Körpergewicht (g)",
    color = "Art",
    caption = "Datenquelle: Palmer Station LTER / palmerpenguins"
  ) +
  theme_classic(base_size = 11)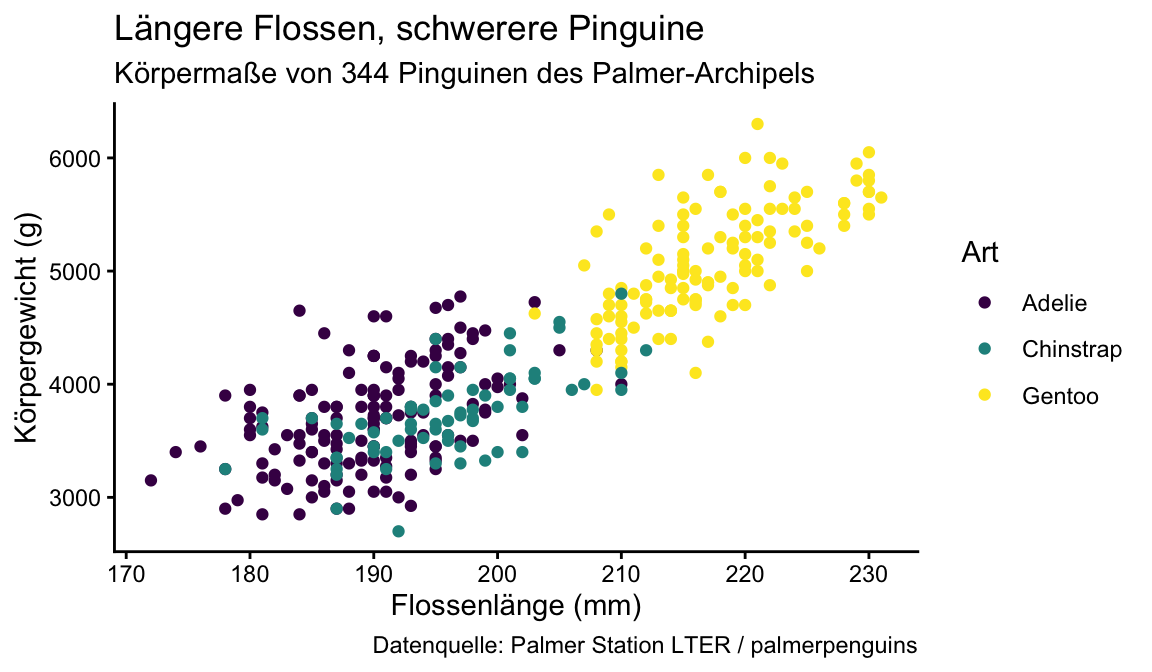
2.3.11 Abbildungen speichern
In einem Quarto-Dokument werden Abbildungen beim Rendern automatisch eingebunden. Möchten Sie eine Abbildung als eigenständige Datei exportieren — etwa für einen Vortrag oder eine Zeitschrift —, verwenden Sie ggsave(). Es speichert standardmäßig die zuletzt erzeugte Abbildung; Format, Größe und Auflösung geben Sie explizit an:
ggsave("pinguine.png", width = 6, height = 4, dpi = 300)Das Dateiformat ergibt sich aus der Endung. Für Publikationen empfiehlt sich ein Vektorformat wie .pdf oder .svg, das sich verlustfrei skalieren lässt.
2.3.12 Ein zusammenfassendes Beispiel
Zum Abschluss kombinieren wir die Bausteine zu einer einzigen, kompakten Abbildung. Sie verknüpft zwei kontinuierliche Variablen (x, y), eine Farb-Aesthetic (species), zwei geometrische Ebenen (Punkte und Trendlinien), Facetting nach Erhebungsjahr, eine angepasste Farbskala, vollständige Beschriftung und ein reduziertes Theme:
ggplot(penguins, aes(x = flipper_length_mm, y = body_mass_g, color = species)) +
  geom_point(alpha = 0.6) +
  geom_smooth(method = "lm", se = FALSE) +
  facet_wrap(~ year) +
  scale_color_viridis_d(option = "C", end = 0.85) +
  labs(
    title = "Flossenlänge und Körpergewicht nach Art und Erhebungsjahr",
    x = "Flossenlänge (mm)",
    y = "Körpergewicht (g)",
    color = "Art"
  ) +
  theme_minimal(base_size = 11)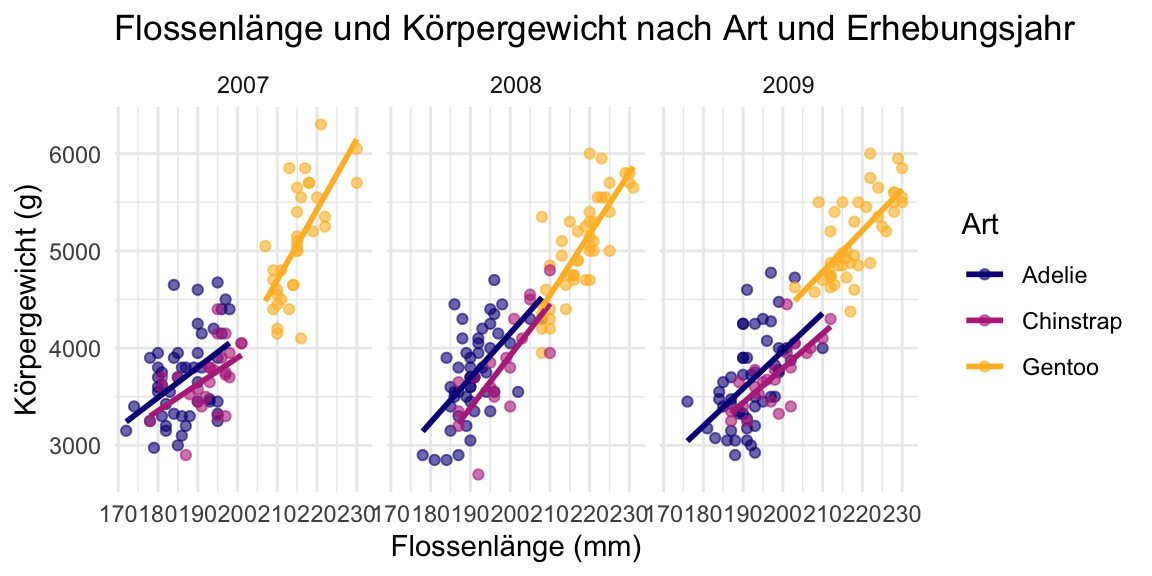
Jeder einzelne Baustein ist für sich verständlich, und zusammen ergeben sie eine dichte, ehrliche und reproduzierbare Darstellung. Genau das ist die Idee der Grammar of Graphics.
2.3.13 Mehrere Abbildungen kombinieren: cowplot
Manchmal soll eine einzige Abbildung mehrere eigenständige Diagramme vereinen — etwa eine mehrteilige „Panel”-Abbildung mit den Teilbeschriftungen A, B, C, wie sie in Publikationen üblich ist. Das im konzeptuellen Teil bereits genutzte patchwork ist eine Möglichkeit; eine zweite, gerade für Publikationsabbildungen sehr verbreitete ist das Paket cowplot. Seine zentrale Funktion ist plot_grid(): Sie ordnet beliebige ggplots in einem Raster an, versieht sie auf Wunsch mit Teilbeschriftungen (labels), richtet ihre Achsen exakt aneinander aus (align, axis) und kann eine gemeinsame Legende teilen.
library(cowplot)

p_scatter <- ggplot(penguins, aes(flipper_length_mm, body_mass_g, color = species)) +
  geom_point() +
  scale_color_viridis_d() +
  theme_minimal(base_size = 10)

p_box <- ggplot(drop_na(penguins, sex), aes(species, body_mass_g, fill = species)) +
  geom_boxplot() +
  scale_fill_viridis_d(guide = "none") +
  theme_minimal(base_size = 10)

plot_grid(p_scatter, p_box, labels = c("A", "B"), rel_widths = c(1.5, 1))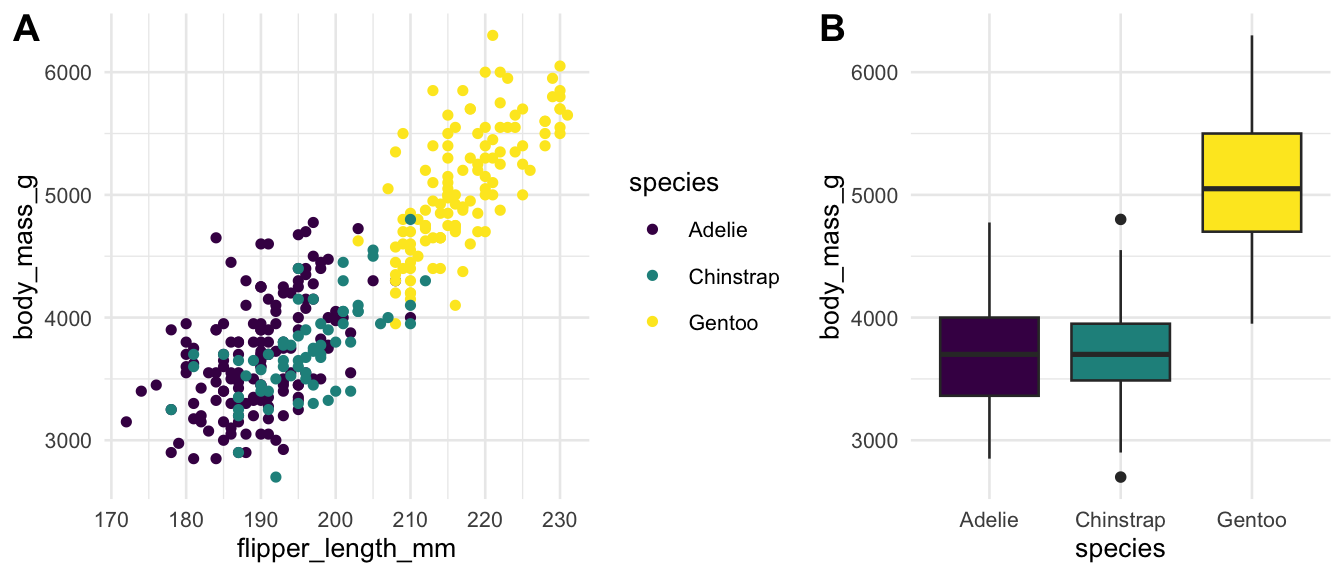
Hinweis
cowplot und das unten verwendete ggupset sind Zusatzpakete: install.packages(c("cowplot", "ggupset")).
Ein aufschlussreiches Anwendungsbeispiel für zusammengesetzte Abbildungen sind UpSet-Plots. Sie visualisieren die Schnittmengen zwischen Mengen: Wenn ein Element mehreren Gruppen zugleich angehören kann (ein Film ist Komödie und Drama), wird ein Venn-Diagramm ab drei oder vier Mengen unübersichtlich. Ein UpSet-Plot zeigt stattdessen die Größe jeder Schnittmenge als Balken, ausgerichtet an einer Matrix, die die beteiligten Mengen markiert — selbst also eine aus mehreren exakt ausgerichteten Teilabbildungen zusammengesetzte Grafik. Das Paket ggupset erzeugt sie als gewöhnliche ggplots über scale_x_upset():
library(ggupset)

tidy_movies |>
  distinct(title, year, length, .keep_all = TRUE) |>
  ggplot(aes(x = Genres)) +
  geom_bar() +
  scale_x_upset(n_intersections = 8) +
  labs(x = "Genre-Kombination", y = "Anzahl Filme")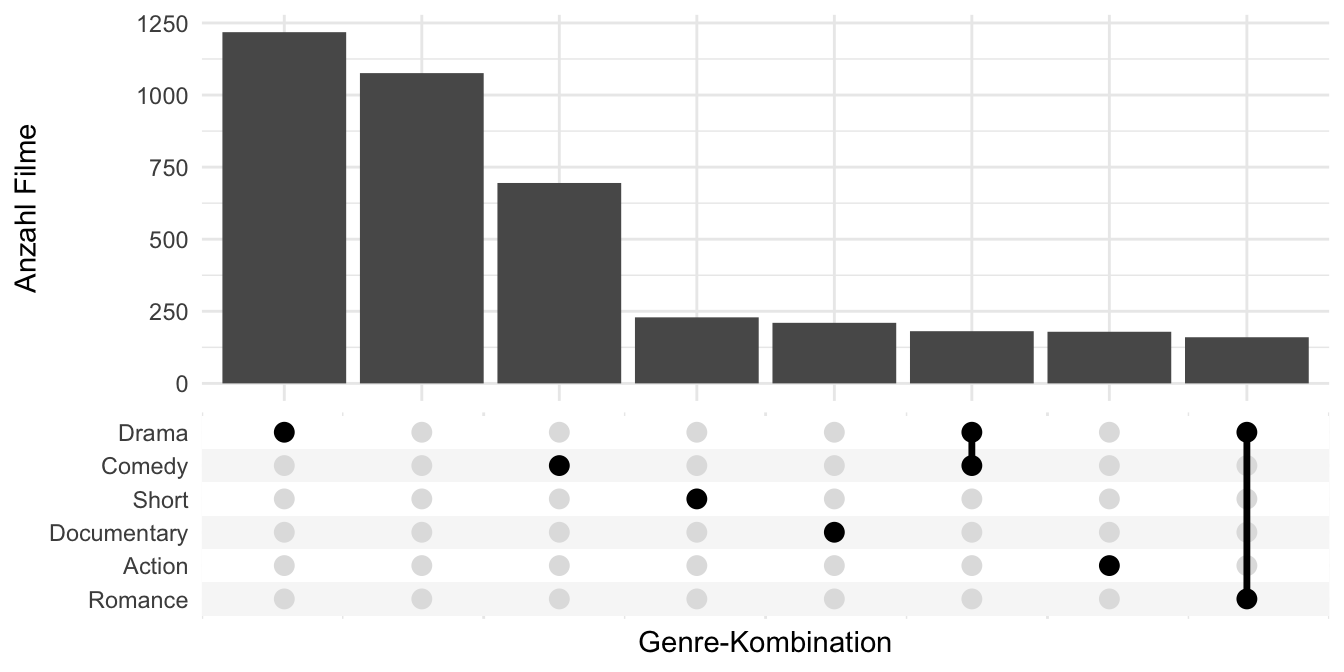
Da ggupset ein gewöhnliches ggplot-Objekt zurückgibt, lässt es sich mit plot_grid() oder patchwork problemlos neben weitere Panels setzen — damit schließt sich der Kreis zu cowplot.
2.4 Fazit
- Abbildungen dienen zwei Zwecken: der Prüfung und Exploration der eigenen Daten und der Kommunikation von Ergebnissen. Anscombes Quartett zeigt, warum der erste Zweck unverzichtbar ist: Kennwerte allein können täuschen.
- Gute Abbildungen folgen wenigen Prinzipien: grafische Integrität, ein hoher Data-Ink-Anteil, hohe Datendichte und die Sichtbarkeit der Rohdaten.
- Wissenschaftliche Abbildungen sollten programmiert statt geklickt werden — der Reproduzierbarkeit, Aktualisierbarkeit und Konsistenz wegen.
- Die Grammar of Graphics zerlegt jede Abbildung in kombinierbare Bausteine: Daten, Aesthetics, Geome, Statistiken, Skalen, Facetten, Koordinaten und Theme.
ggplot2setzt diese Grammatik in R um. Wenn Sie die Bausteine beherrschen, erstellen Sie aus ihnen praktisch jede Abbildung, die Sie brauchen.
2.4.1 Vertiefung
Wenn Sie an dem Thema Abbildungen interessiert sind und sich auf einer etwas abstrakteren Ebene mit Abbildungen beschäftigen möchten, empfehle ich Ihnen unbeding die Bücher von Edward Tufte. Es gibt auch eine sehr gute Keynote von Ihm, die er vor ein paar Jahren auf einem Microsoft summit gehalten hat (https://www.youtube.com/watch?v=rHUDJ8RyseQ). Ein eher praktisches und weniger tiefgehendes Buch zum Thema Datenvisualisierung ist das Buch von Alberto Cairo (2012). Falls Sie besonders viel über ggplot2 lernen möchten, empfehle ich das komplette Buch über das ggplot2-Paket von dem Entwickler selbst (Wickham, 2016), sowie das frei verfügbare Kapitel zur Datenvisualisierung in R for Data Science.