%%{init: {'flowchart': {'curve': 'basis'}}}%%
flowchart LR
    problem["Problem"]
    subgraph planung [Theorie und Planung]
        direction LR
        theorie["Theorie &<br>Forschungsstand"]
        hypo["Hypothesen"]
        design["Untersuchungs-<br>design"]
    end
    subgraph durchfuehrung [Durchführung]
        direction LR
        operat["Operationalisierung<br>& Stichprobe"]
        erhebung["Daten-<br>erhebung"]
    end
    subgraph auswertung [Auswertung]
        direction LR
        analyse["Daten-<br>analyse"]
        interpret["Interpretation"]
    end
    publik["Bericht &<br>Publikation"]

    problem --> theorie --> hypo --> design
    design --> operat --> erhebung
    erhebung --> analyse --> interpret
    interpret --> publik
    publik -.->|neue Fragestellungen| problem

    classDef box fill:#DCEBF3,stroke:#2C6C8F,color:#123244;
    class problem,theorie,hypo,design,operat,erhebung,analyse,interpret,publik box
    style planung fill:#F5FAFD,stroke:#9FB8C6,stroke-dasharray:4 4
    style durchfuehrung fill:#F5FAFD,stroke:#9FB8C6,stroke-dasharray:4 4
    style auswertung fill:#F5FAFD,stroke:#9FB8C6,stroke-dasharray:4 4
    linkStyle default stroke:#000000,stroke-width:1.5px,fill:none
    linkStyle 8 stroke:#8a8a8a,stroke-width:1.3px
1 Einführung
“I suppose it is tempting, if the only tool you have is a hammer, to treat everything as if it were a nail.” — (Maslow, 1962)
Die Psychologische Methodenlehre ist eine spannende und sehr dynamische Disziplin innerhalb der Psychologie. Das Ziel dieses Kurses ist Sie mit den wichtigsten Konzepten und Hintergrundinformationen zu versorgen und Ihnen beizubringen, wie Sie diese Methoden effektiv und effizient einsetzen können, um Forschungsfragen in der Psychologie zu beantworten. Nachdem Sie dieses Buch gelesen haben, werden Sie ganz viele unterschiedliche Untersuchungsmethoden kennengelernt haben. Die Welt wird hoffentlich nicht mehr aus nur aus Nägeln bestehen.
1.1 Was Sie lernen werden
„To consult the statistician after an experiment is finished is often merely to ask him to conduct a post mortem examination. He can perhaps say what the experiment died of.” — Ronald A. Fisher (1938)
Empirische Forschung in der Psychologie beginnt nicht mit Daten, sondern mit einem Problem. Aus ihm entwickeln wir — gestützt auf Theorie und Forschungsstand — Hypothesen, daraus ein Untersuchungsdesign, eine Operationalisierung und eine Stichprobe; erst dann werden Daten erhoben, ausgewertet und interpretiert, und am Ende steht ein Bericht, der neue Fragen aufwirft (Abbildung 1.1). Obwohl dieser Ablauf eine gute Orientierung liefert, ist es wichtig zu bedenken, dass die einzelnen Phasen stark aufeinander bezogen sind. Die entscheidende Weichenstellen dafür welche Methode eingesetzt werden können fällt daher nicht erst bei der Analyse, sondern bei der Wahl und Planung des Untersuchungsdesigns. Umgekehrt ist es auch so, dass das Wissen um Auswertungsmethoden : Erst wer die Verfahren kennt, kann überhaupt die richtigen Hypothesen formulieren. Wer nur den t-Test kennt, plant eben Zwei-Gruppen-Experimente und stellt Zwei-Gruppen-Fragen. Ein breiteres Methodenrepertoire erlaubt bessere Fragen und bessere Studien — deshalb setzt dieses Buch für viele Verfahren bewusst früher an als bei der reinen Datenanalyse.
In diesem Buch geht es um komplexe Forschungsmethoden lernen. Damit sind in erster Linie Forschungsmethoden gemeint, die sich dadurch auszeichnen, dass sie Viele Variablen gleichzeitig betrachten können. Einfache Verfahren wie der t-Test betrachten wenige Variablen, multivariate Verfahren viele auf einmal. Dadurch können auch komplexere Untersuchungsdesigns, bei denen z.B. die einzelnen Beobachtungen nicht alle unabhängig voneinander sind, besser analysiert werden. Es gibt aber noch zwei weitere Aspekte, für die sich ein Buch in komplexen Forschungsmethoden lohnt. Erstens, wenn man nicht nur die Analyse der Ergebnisse in den Blick nimmt, sondern auch Untersuchungen plant. Zweitens, indem wir die Methoden selbst in den Blick nehmen und Methoden kennenlernen um diese zu bewerten und weiterzuentwickeln.
Bei allen Methoden mit denen wir uns befassen, ist mir wichtig, dass Sie die ganzen Schritte des Forschungsprozesses so einer Studie verstehen, kritisieren und selbst einsetzen können. Das bedeutet, dass Sie einerseits die mathematischen Grundlagen verstehen, andererseits aber die Übersicht nicht verlieren und Ergebnisse jederzeit mit einfacheren, oft graphischen Methoden gegenprüfen können.
1.2 Wie dieses Buch aufgebaut ist
Wir hangeln uns an den Methoden entlang. Zu jeder Methode gibt es einen gewissen mathematischen Hintergrund — das ist ein Zugang, um zu verstehen, was ein Verfahren eigentlich tut. Ein zweiter Zugang sind Simulationsstudien: Statt ein Verfahren nur herzuleiten, lassen wir es auf Daten mit bekannten Eigenschaften los und schauen, ob es sich so verhält, wie wir es erwarten.
Dieses Buch ist statisch. Das heißt: Sie können es ausdrucken und in der Badewanne oder am Strand lesen, ohne Angst zu haben, dass etwas kaputtgeht. Parallel gibt es ein Workbook mit interaktiven Übungen zu den einzelnen Kapiteln.
Datenmanagement und Visualisierung. Bevor wir mit einzelnen Verfahren beginnen, besprechen wir zwei Themen, die einen Großteil der praktischen Arbeit ausmachen: das Datenmanagement (also das Importieren, Bereinigen und Transformieren von Daten) und die Visualisierung von Daten. Das Datenmanagement nimmt in der Praxis den größten Teil der Auswertungsarbeit am Computer in Anspruch; die Visualisierung wird in der Psychologie leider oft vernachlässigt.
Das Allgemeine Lineare Modell und seine Erweiterungen. Ausgehend von der multiplen Regression erarbeiten wir die zugrunde liegende Idee des Allgemeinen Linearen Modells und wichtige Erweiterungen. Dazu gehören Mehrebenenmodelle, mit denen sich auch komplexe Abhängigkeiten zwischen Beobachtungen modellieren lassen, sowie Varianten für andere Datentypen (z. B. die logistische Regression) und regularisierte Verfahren (z. B. die LASSO-Regression).
Faktorenanalysen und Strukturgleichungsmodelle. Anschließend sprechen wir über Faktorenanalysen und Strukturgleichungsmodelle, mit denen sich die Beziehungen zwischen mehreren (auch latenten) Variablen untersuchen lassen.
Item-Response-Theorie. Ein eigenes Kapitel widmet sich der Item-Response-Theorie als maßgeblicher Grundlage für die Entwicklung von (adaptiven) Tests.
Clusteranalyse. Danach behandeln wir die Clusteranalyse, mit der sich Gruppen von Fällen datengetrieben identifizieren lassen.
LLMS Zum Schluss lernen Sie Methoden kennen, um effizient mit Sprachmodellen sog. LLMs zu arbeiten.
1.3 Was nicht Inhalt dieses Buches ist
Ein Buch wird auch durch das definiert, was es bewusst weglässt. Zwei Dinge grenze ich ausdrücklich aus.
Bayesianische Statistik. Neben der in diesem Buch verwendeten frequentistischen Statistik gibt es eine lange Tradition, die das eigentliche Problem in der Logik des p-Werts selbst verortet und stattdessen für bayesianische Verfahren wirbt (Wagenmakers et al., 2017). Diese quantifizieren Evidenz direkt (etwa über Bayes-Faktoren) und beziehen Vorwissen (Priors) systematisch ein. Der Ansatz ist elegant und in manchen Fragestellungen klar überlegen. In diesem Buch spielt er dennoch nur eine untergeordnete Rolle — aus zwei praktischen Gründen: Erstens ist die überwältigende Mehrheit der Verfahren und Studien, die Ihnen begegnen werden, frequentistisch; Sie müssen sie lesen und verstehen können. Zweitens sind die wichtigsten Lehren der letzten Jahrzehnte — ausreichende Power, Schätzen statt bloßem Testen, Transparenz — weitgehend unabhängig davon, ob man frequentistisch oder bayesianisch rechnet. Wir bleiben daher beim frequentistischen Rüstzeug und greifen bayesianische Methoden nur dort auf, wo sie besonders hilfreich sind.
Reine Data Science und Programmierung. Sie werden auch kein Profi in Data Science. Es wird weiterhin Menschen geben, die schneller Daten hin- und herschieben und bessere Werkzeuge dafür haben. Unser Ziel ist ein anderes: Sie sollen nicht nur gegebene Daten auswerten, sondern auch überlegen und planen können, welche Daten besonders relevant für die Beantwortung einer Fragestellung aus der Praxis ist.
1.4 Konzeptuelle Voraussetzungen
Da Sie eine Vorlesung in komplexen Forschungsmethoden der Psychologie besuchen, haben Sie mit hoher Wahrscheinlichkeit bereits mehrere Kurse in nicht-komplexen Forschungsmethoden erfolgreich absolviert. In einem typischen (wirtschafts-) Psychologie sind das Kurse in Methodenlehre (gerne I und II), Statistik, Diagnostik und Experimentalpraktika absolviert und selbst eine empirische Abschlussarbeit geschrieben. Bevor wir mit einzelnen Verfahren beginnen, möchte ich dennoch einige Grundgedanken wiederholen, die erklären, warum wir in der Psychologie bestimmte Schritte gehen und andere nicht.
1.4.1 p-Werte und ihre Kritik
Statistischer Test. Ein Verfahren, das anhand von Daten zwischen zwei Hypothesen entscheidet — meist einer Nullhypothese und einer Alternativhypothese.
Das vertrauteste Werkzeug der psychologischen Statistik ist der Nullhypothesen-Signifikanztest, und in seinem Zentrum steht der p-Wert. Ronald Fisher prägte die Idee, ein Ergebnis als „signifikant” zu bezeichnen, wenn es unter der Nullhypothese hinreichend unwahrscheinlich ist; ergänzt um die Alpha- und Beta-Fehler von Neyman und Pearson wurde daraus das Standardwerkzeug der Disziplin. Sein Reiz liegt auch darin, dass er gut zum kritischen Rationalismus Karl Poppers (2007) passt: Statt eine Theorie zu „beweisen”, versuchen wir, eine Nullhypothese zu widerlegen. Diese Nähe zur Falsifikation ist attraktiv — auch wenn die statistische Nullhypothese selten mit der eigentlich interessierenden Theorie identisch ist.
An diesem Werkzeug hat sich über Jahrzehnte eine tiefgreifende Kritik entzündet, die man kennen muss, um die heutige Methodenpraxis zu verstehen.
Das Power-Problem. Schon Cohen (1988) zeigte, dass viele psychologische Studien viel zu kleine Stichproben hatten, um selbst mittelgroße Effekte zuverlässig zu finden — ihre statistische Power war gering. Das Beunruhigende daran: Bei geringer Power sagt ein „nicht signifikantes” Ergebnis fast nichts aus, und ein „signifikantes” ist überraschend oft ein Fehlalarm. Cohen und andere warben jahrzehntelang für Poweranalysen und für die Berichterstattung von Effektstärken — mit erstaunlich wenig Wirkung: Sedlmeier & Gigerenzer (1989) stellten fest, dass sich die Power der publizierten Studien über Jahre kaum verbessert hatte.
Die „New Statistics”. Als Reaktion auf die Fixierung auf das Sternchen hinter dem p-Wert plädierte Cumming (2012) für eine neue Statistik: weg vom dichotomen „signifikant/nicht signifikant”, hin zur Schätzung von Effektstärken mit Konfidenzintervallen und zur kumulativen Bündelung von Befunden in Meta-Analysen. Nicht „Gibt es einen Effekt?“, sondern „Wie groß ist er, und wie sicher sind wir uns?” sollte die Leitfrage sein.
Die Replikationskrise. Um 2011 kippte die Stimmung. Auslöser war unter anderem eine Studie von Daryl Bem (2011), der damals gängige Erhebungs- und Auswertungsmethoden verwendete, und mit ihnen zu dem Schluss kam, dass Probanden tatsächlich zu übernatürlichen Fähigkeiten wie dem Vorraussagen der nächsten Karte in einem gemischten Kartendeck in der Lage sind. Eine Reihe von Arbeiten haben dann herausgearbeitet welche sog. Freiheitsgrade (aka researcher degrees of freedom) dafür verantwortlich sind, dass man es liegt, dass man praktisch jedes Ergebnis signifikant bekommt Simmons et al. (2011). Den empirischen Höhepunkt lieferte die von Brian Nosek koordinierte Open Science Collaboration (Open Science Collaboration, 2015): Von 100 wiederholten Studien ließ sich nur etwa ein Drittel bis die Hälfte replizieren. Das war der Beginn dessen, was heute als Replikationskrise bekannt ist. Wichtig ist zu betonen, dass auch in anderen Feldern in denen es untersucht wurde, die Rate an replizierbaren Ergebnissen deutlich geringer ausfällt. So hat sich in der Krebsforschung herausgestellt, dass von 53 Landmark Befunden aus der präklinischen Krebsforschung nur 6 (11%) replizieren ließen (Begley & Ellis, 2012).
Metascience. Diese Krise hatte einen überaus produktiven Effekt: Sie machte die Forschungspraxis selbst zum Forschungsgegenstand. Aus der Reformbewegung gingen Präregistrierung, Registered Reports, offene Daten und groß angelegte Replikationsprojekte hervor (Munafò et al., 2017). Damit ist die Psychologie zu einem Vorreiter der Metascience geworden — der wissenschaftlichen Untersuchung des Wissenschaftsbetriebs selbst. Studien in Metascience beschäftigen sich damit welche Forschungsmethoden eingesetzt werden und wie sich dies über die Zeit verändert.
1.4.2 Simulationsstudien als Forschungsmethoden
Neben der Frage welche Methoden in der Praxis eingesetzt werden, gibt es auch sehr viel Forschung dazu, welche Methoden eingesetzt werden sollten. Wenn man die Methoden zum Gegenstand der Forschung macht, stellt man sich die Frage wie gut funktioniert eine Methode eigentlich, und unter welchen Bedingungen?
- Hält ein t-Test sein Alpha-Niveau von 5 % ein, wenn die Varianzen in den Gruppen ungleich sind?
- Wie viel Power habe ich bei einer Stichprobe von nur 20 Personen pro Gruppe?
- Liefert ein Verfahren verzerrte Schätzungen, wenn Werte fehlen?
Solche Fragen lassen sich zum Teil durch mathematische Herleitungen beantworten, für realistische Szenarien wird das aber schnell unhandlich. Das wichtigste und zugleich zugänglichste Werkzeug der angewandten Statistik ist daher die Simulationsstudie (Morris et al., 2019). Die Grundidee ist recht einfach (vgl. Abbildung 1.2):
- Man erzeugt Daten mit bekannten Eigenschaften — man kennt also die „Wahrheit”, weil man sie selbst festgelegt hat.
- Man wendet das interessierende Verfahren auf diese Daten an und protokolliert das Ergebnis (z. B. den p-Wert).
- Man wiederholt die Schritte 1 und 2 sehr oft — typischerweise tausende Male — und wertet aus, ob sich das Verfahren so verhält, wie man es erwartet.
%%{init: {'flowchart': {'curve': 'basis'}}}%%
flowchart LR
    truth["Wahre Eigenschaften<br>festlegen<br>(die Wahrheit)"]

    subgraph loop [Tausende Wiederholungen]
        direction LR
        gen["1. Daten<br>erzeugen"]
        apply["2. Verfahren<br>anwenden"]
        record["3. Ergebnis<br>protokollieren<br>(z. B. p-Wert)"]
    end

    eval["Auswerten:<br>Verhält sich das Verfahren<br>wie erwartet?"]

    truth --> gen
    gen --> apply
    apply --> record
    record -.->|nächste Wiederholung| gen
    record --> eval

    classDef box fill:#DCEBF3,stroke:#2C6C8F,color:#123244;
    classDef result fill:#EAF3E7,stroke:#4C8C4A,color:#1F3D1E;
    class truth,gen,apply,record box
    class eval result
    style loop fill:#F5FAFD,stroke:#9FB8C6,stroke-dasharray:4 4
    linkStyle default stroke:#000000,stroke-width:1.5px,fill:none
    linkStyle 3 stroke:#8a8a8a,stroke-width:1.3px
Ein kleines Beispiel um den Einfluss der Varianzhomogenität auf die Performanz von t-tests zu zeigen. Wir generieren Daten aus zwei Gruppen, zwischen denen es keinen echten Mittelwertsunterschied gibt, in der einen Gruppe sind 30 und in der anderen Gruppe 60 Personen. Zuerst simulieren wir die Daten so, dass beide Gruppen dieselbe Varianz haben. Mit den Daten rechnen wir dann einen t-Test und schreiben uns den resultierenden p-Wert auf. Das machen wir 10.000 mal. Wenn der Test hält, was er verspricht, sollten ungefähr 5 % der p-Werte kleiner als .05 sein — also etwa 500 von 10.000. Spannend wird es, wenn wir die erzeugten Daten gezielt manipulieren: Was passiert mit dieser Fehlerrate, wenn wir die Daten so generieren, dass die Varianzen in der kleineren Gruppe doppelt so hoch oder nur halb so hoch wie in der größeren Gruppe sind?
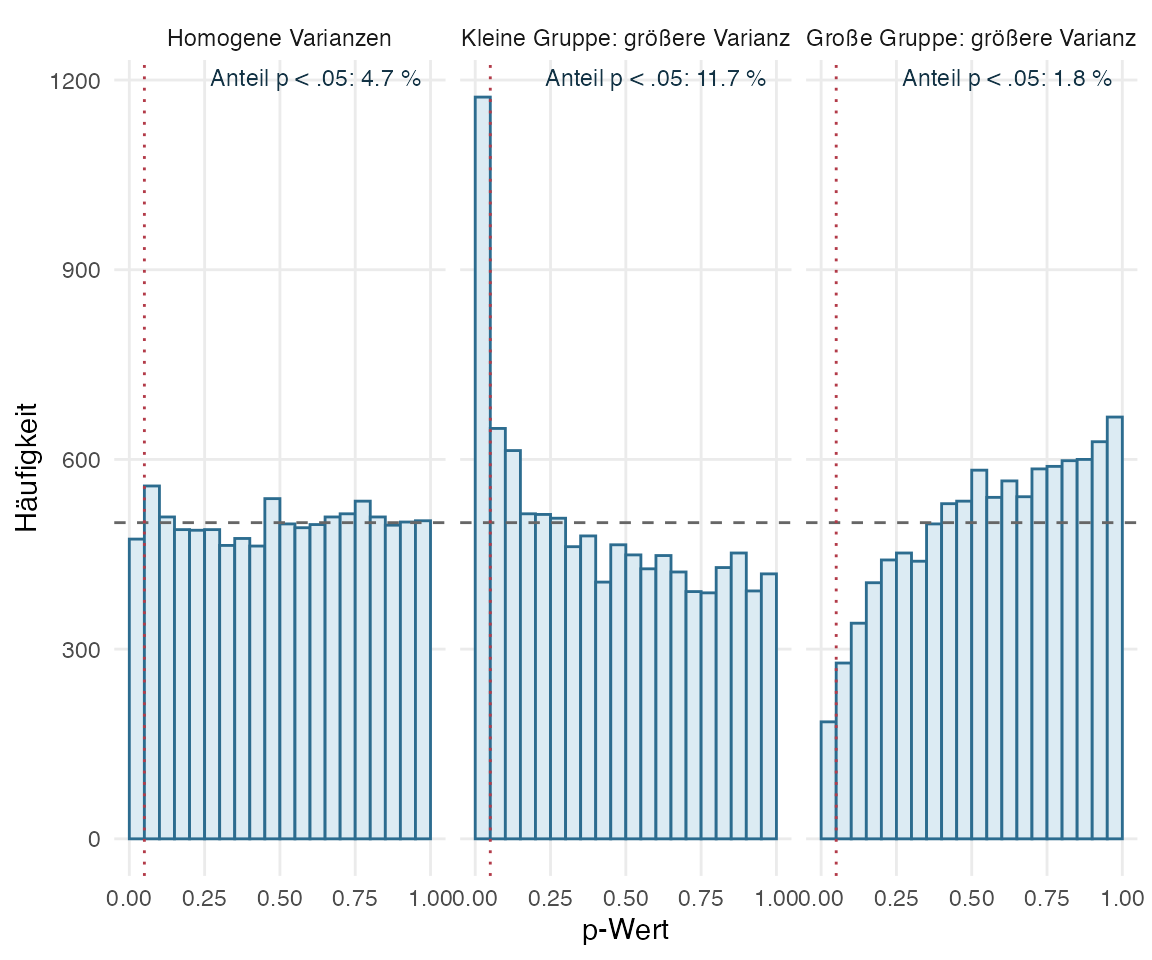
Das Ergebnisse Abbildung 1.3 ist eindrücklich: Bei homogenen Varianzen sind die p-Werte gleichverteilt, und die Fehlerrate liegt wie erwartet bei rund 5 %. Der Test funktioniert wie gewünscht. Sobald aber die kleinere Gruppe die größere Varianz hat, häufen sich kleine p-Werte, und der Test wird deutlich zu liberal (die Fehlerrate steigt klar über 5 %). Hat umgekehrt die größere Gruppe die größere Varianz, verschieben sich die p-Werte nach oben, und der Test wird zu konservativ. Die Faustregel „bei ungleichen Gruppen aufpassen” bekommt so ein konkretes Gesicht — und man sieht sofort, warum der Welch-Test (in R die Voreinstellung) die bessere Wahl ist.
Simulationsstudien haben für uns einen doppelten Wert. Zum einen machen sie Annahmen erfahrbar: Statt den Satz „der t-Test setzt Varianzhomogenität voraus” auswendig zu lernen, sehen Sie unmittelbar, was passiert, wenn diese Annahme verletzt ist. Zum anderen können Sie diese nutzen, um die Methoden zu überprüfen. Sie müssen einem neuen oder unbekannten Verfahren nicht blind vertrauen, sondern können sein Verhalten selbst untersuchen. Wir werden deshalb immer mal wieder kleinere Simulationsstudien nutzen, um zu checken, ob die Methoden auch das tun, was wir denken.
1.4.3 Modelle: erklären oder vorhersagen?
„All models are wrong, but some are useful” — George Box (1976).
Fast alle Verfahren in diesem Buch beruhen auf statistischen Modellen. Modell. Ein Modell ist eine vereinfachte, formale Beschreibung, wie die beobachteten Daten zustande gekommen sein könnten. Wir tun so, als seien die Daten nach einer bestimmten, überschaubaren Regel entstanden, und schätzen dann die Größen (Parameter) dieser Regel. Weil ein Modell die Wirklichkeit immer vereinfacht, ist keines im strengen Sinn „richtig”. Für uns heißt das: Die Frage ist nie, ob ein Modell wahr ist, sondern ob es für unseren Zweck nützlich ist — und ob wir seine Grenzen kennen.
Was „nützlich” bedeutet, hängt allerdings vom Zweck ab. Shmueli (2010) unterscheidet zwei grundverschiedene Ziele:
- Erklären. Wir wollen verstehen, warum etwas passiert, und Hypothesen über Mechanismen prüfen. Hier zählt, ob die Modellstruktur der vermuteten (kausalen) Struktur entspricht; ein theoretisch begründetes, sparsames Modell ist oft aussagekräftiger als ein komplexes. Praktisch werden hierfür oft multiple regressionen verwendet, bei denen man schätzen kann, wie stark der “Einfluss” unterschiedlicher Variablen auf das Outcome ist.
- Vorhersagen. Wir wollen für neue Fälle möglichst treffsichere Prognosen, unabhängig davon, ob wir den Mechanismus verstehen. Hier zählt allein die Vorhersagegüte an neuen Daten — auch ein „Black-Box”-Modell bei dem wir im Extremfall gar nicht sagen können woran es liegt, dass eine bestimmte aussage getroffen wurde, ist willkommen.
Beides ist legitim, aber die Entscheidungen unterscheiden sich: Ein Modell, das am besten erklärt, sagt nicht unbedingt am besten vorher — und umgekehrt. In der Psychologie liegt der Schwerpunkt traditionell beim Erklären; mit dem Einzug von Machine-Learning-Methoden gewinnt aber auch die Vorhersageperspektive an Bedeutung. Es hilft, sich bei jeder Analyse zu fragen, in welchem der beiden Modi man gerade arbeitet. Während der Schwerpunkt des Buches auf Methoden beruht, die eher zum Erklären passen, werden wir auch moderne Vorhersagemethoden (z.B. das LASSO) besprechen.
1.4.4 Was Sie schon mitbringen sollten
Ein Bachelorstudium der Psychologie vermittelt eine ganze Reihe methodischer Grundlagen, auf die dieses Buch aufbaut. Sie sollten daher die folgenden Fragen beantworten können:
- Was bedeutet es, eine Hypothese konfirmatorisch statt exploratorisch zu prüfen — und warum ist diese Unterscheidung so wichtig?
- Was sind die besonderen Merkmale eines strengen Experiments (Manipulation, Kontrolle, Randomisierung)?
- Worin unterscheiden sich experimentelle, quasi-experimentelle und korrelative Designs — und warum erlaubt nur das Experiment kausale Schlüsse?
- Was bedeuten interne und externe Validität, und welche typischen Störgrößen (Confounder) gefährden sie?
- Was ist der Unterschied zwischen einem Between- und einem Within-Design (Messwiederholung), und welche Folgen hat das für die Auswertung?
- Was heißt Operationalisierung — wie wird aus einem theoretischen Konstrukt eine messbare Variable?
Messen und psychometrische Qualität
- Welche Skalenniveaus gibt es, und welche Auswertungen erlauben sie jeweils?
- Was sind die psychometrischen Gütekriterien (Objektivität, Reliabilität, Validität), wie misst man sie, und wie hängen sie zusammen?
- Was besagt die Klassische Testtheorie, und was sagen Itemkennwerte wie Trennschärfe und interne Konsistenz über die Qualität einer Skala?
Beschreiben und Zusammenhänge
- Welche Maße der zentralen Tendenz und der Streuung gibt es, wann verwendet man welches, und wozu dient die Standardisierung (z-Werte)?
- Wie unterscheiden sich Kovarianz und Korrelation, wie interpretiert man einen Korrelationskoeffizienten, und hängt Korrelation mit Kausalität zusammen?
Testen, Schätzen und Standardverfahren
- Was ist ein statistischer Test — Nullhypothese, Prüfgröße und p-Wert?
- Wie hängen Alpha-Fehler, Beta-Fehler, Effektstärke und Stichprobenumfang (Power) zusammen — und wie unterscheidet sich statistische Signifikanz von Effektstärke und praktischer Relevanz?
- Wie wählt man mithilfe eines Entscheidungsbaums das passende Standardverfahren (t-Test, χ²-Test, Korrelation, ANOVA, Regression) für eine Fragestellung?
- Was versteht man unter Moderation und Mediation, und wie lassen sich diese Effekte statistisch prüfen?
Wo bekommt man dieses Wissen her? Am schnellsten aus den eigenen Bachelor-Unterlagen — die allermeisten dieser Punkte wurden dort behandelt. Zum Auffrischen und Vertiefen eignen sich die einschlägigen Lehrbücher: Für Untersuchungsdesign und Evaluation ist das Buch von Bortz und Döring Döring (2023) der deutschsprachige Klassiker. Wer Forschungsmethoden und Statistik aus einem Guss sucht, ist mit dem Buch von Eid und Kollegen gut bedient Eid et al. (2017), das beide Bereiche verbindet. Die statistischen Grundlagen lassen sich zusätzlich im Buch von Bortz (2010) nachschlagen. Einen besonders zugänglichen und praxisnahen Einstieg bietet das Buch von Field (2026). Speziell für die psychometrischen Themen (Gütekriterien, Testtheorie) ist Moosbrugger und Kelava (2020) das Standardwerk.