4 ALM und Multiple lineare Regression
“…less is more, except of course for sample size.” — Jacob Cohen (1990)
In diesem Kapitel lernen Sie das Allgemeinen Linearen Modell kennen, dass viele Verfahren, die Sie im Bachelor vielleicht als getrennte Werkzeuge kennengelernt haben — t-Test, Korrelation, Varianzanalyse —, eigentlich Spezialfälle ein und desselben Modells sind. Danach klären wir, was es bedeutet, dass die Parameter dieses Modells nach dem Prinzip der Maximum-Likelihood-Schätzung geschätzt werden. Anschließend geht es um die Frage, wie das Gesamtmodell und die einzelnen Parameter sinnvoll interpretiert werden können. Zum Abschluss des konzeptuellen Teils besprechen wir die Annahmen des Modells 1. Wie in den vorigen Kapiteln ist die zweite Hälfte praktisch: Sie zeigt, wie Sie Regressionsmodelle in R schätzen, prüfen, visualisieren und mit dem Paket modelsummary in publikationsreife Tabellen überführen.
Der Name des Verfahrens ist eigentlich ein historischer Zufall. Francis Galton (1886) untersuchte gegen Ende des 19. Jahrhunderts, wie die Körpergröße von Eltern mit der ihrer erwachsenen Kinder zusammenhängt. Dabei fiel ihm auf, dass die Kinder sehr großer Eltern zwar überdurchschnittlich groß waren, aber im Mittel weniger extrem als ihre Eltern — und umgekehrt für sehr kleine Eltern. Galton nannte das Phänomen „regression towards mediocrity“, die Rückkehr zum Mittelmaß. Heute sprechen wir von der Regression zur Mitte, und sie ist ein Artefakt jeder nicht perfekten Korrelation. Die Methode, mit der Galton den Zusammenhang beschrieb, behielt den Namen, obwohl sie mit einem „Rückschritt“ nichts zu tun hat.
Die Regression zur Mitte ist bis heute eine der häufigsten Fehlerquellen bei der Bewertung von Interventionen: Wer gezielt die schlechtesten Abteilungen eines Unternehmens coacht, wird beim nächsten Mal fast immer eine Verbesserung sehen — auch ganz ohne Coaching.
4.1 Das Allgemeine Lineare Modell
4.1.1 Daten = Modell + Fehler
Die Grundidee aller Verfahren in diesem und den folgenden Kapiteln lässt sich in einer einzigen Zeile zusammenfassen:
\[ \text{Daten} = \text{Modell} + \text{Fehler} \]
Wir versuchen, die beobachteten Werte einer abhängigen Variable (auch Kriterium oder Outcome) \(y\) durch eine einfache, formale Regel aus einer oder mehreren unabhängigen Variablen (Prädiktoren) \(x_1, x_2, \ldots, x_k\) vorherzusagen. Was die Regel nicht erklären kann, landet im Fehler. Im Allgemeinen Linearen Modell (ALM) ist diese Regel eine gewichtete Summe der Prädiktoren:
\[ y_i = \beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i} + \ldots + \beta_k x_{ki} + \varepsilon_i, \qquad \varepsilon_i \sim N(0, \sigma^2) \tag{4.1}\]
Dabei ist \(y_i\) der Wert von Person (oder bei uns Pinguin) \(i\), \(\beta_0\) der Achsenabschnitt (Intercept), also der vorhergesagte Wert, wenn alle Prädiktoren null sind, und \(\beta_1\) bis \(\beta_k\) sind die Regressionsgewichte (Steigungen). Der Fehler oder das Residuum \(\varepsilon_i\) ist die Abweichung des beobachteten vom vorhergesagten Wert \(\hat{y}_i\). Von den Fehlern nehmen wir an, dass sie im Mittel null sind, unabhängig voneinander und normalverteilt mit einer für alle Beobachtungen gleichen Varianz \(\sigma^2\). Auf diese Annahmen kommen wir am Ende des konzeptuellen Teils ausführlich zurück.
Linear heißt das Modell, weil es linear in den Parametern ist: Die \(\beta\)s werden nur mit etwas multipliziert und aufaddiert. Die Prädiktoren selbst dürfen durchaus transformiert sein — auch \(y = \beta_0 + \beta_1 x + \beta_2 x^2\) ist ein lineares Modell, obwohl es eine Kurve beschreibt.
Kompakter lässt sich das Modell in Matrixschreibweise notieren. Alle \(y\)-Werte stehen in einem Vektor \(\mathbf{y}\), alle Prädiktorwerte — ergänzt um eine Spalte aus Einsen für den Achsenabschnitt — in der sogenannten Designmatrix \(\mathbf{X}\):
\[ \mathbf{y} = \mathbf{X}\boldsymbol{\beta} + \boldsymbol{\varepsilon} \tag{4.2}\]
Diese Schreibweise sieht zunächst abstrakt aus, sie macht aber einen zentralen Punkt sichtbar: Das Modell interessiert sich nicht dafür, was in den Spalten von \(\mathbf{X}\) steht. Das können kontinuierliche Messwerte sein, aber genauso gut Nullen und Einsen, die eine Gruppenzugehörigkeit kodieren. Genau deshalb ist das Modell allgemein.
HinweisObacht: Allgemein oder generalisiert?
Im Englischen werden leider zwei verschiedene Modellfamilien als GLM abgekürzt. Das Allgemeine Lineare Modell (general linear model) aus diesem Kapitel setzt normalverteilte Fehler voraus. Das Generalisierte Lineare Modell (generalized linear model) erweitert es auf andere Verteilungen, etwa für binäre Outcomes (logistische Regression) oder Häufigkeiten (Poisson-Regression). Wir behandeln es im Kapitel zur logistischen Regression. In R entspricht das dem Unterschied zwischen lm() und glm().
4.1.2 Regressionsgewichte in der multiplen Regression
In der einfachen Regression mit nur einem Prädiktor ist \(\beta_1\) schlicht die Steigung der Geraden: Sie beschreibt um wie viele Einheiten sich der der vorhergesagte Wert von \(y\) ändert, wenn \(x\) um eine Einheit steigt. In der multiplen Regression mit mehreren Prädiktoren ändert sich die Bedeutung auf subtile, aber entscheidende Weise. Das Gewicht \(\beta_j\) beschreibt nun die vorhergesagte Veränderung in \(y\), wenn \(x_j\) um eine Einheit steigt und alle anderen Prädiktoren konstant bleiben. Man spricht von einem partiellen Regressionsgewicht.
Die Regressionsgewichte einzelner Prädiktoren in einer multiplen Regression können sich stark ändern in Abhängigkeit davon welche anderen Prädiktoren Teil des Modells sind.
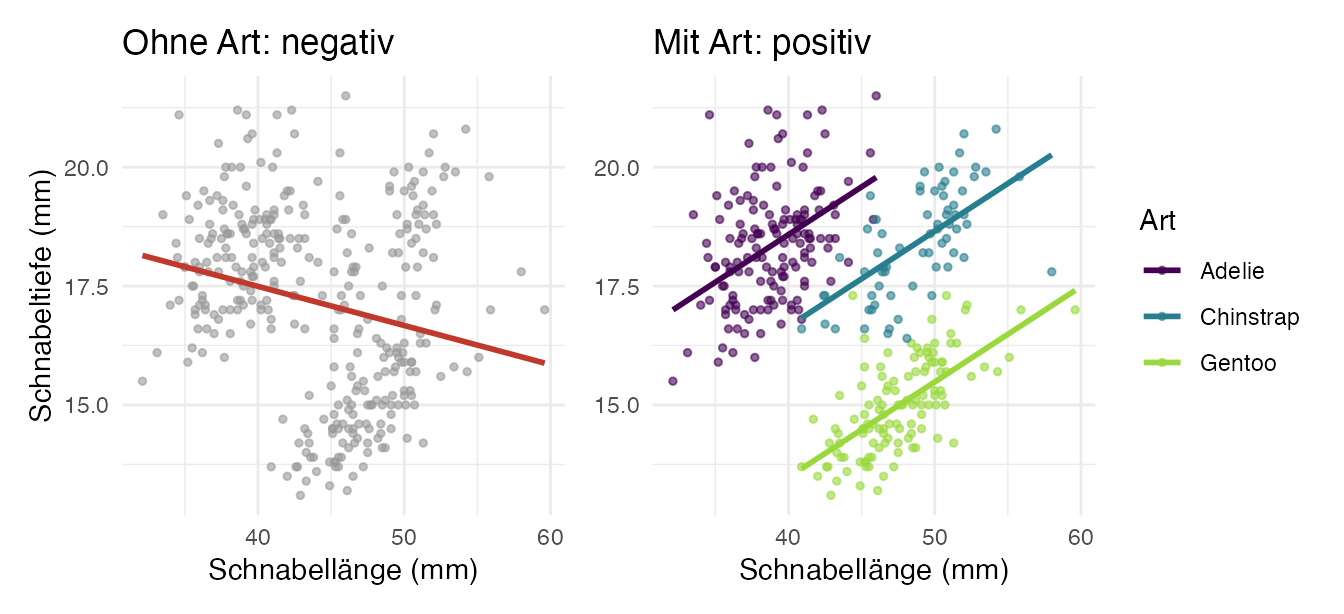
Wie groß der Unterschied zwischen einfachem und partiellem Gewicht sein kann, zeigt ein Beispiel aus dem Pinguin-Datensatz. Betrachtet man alle Tiere gemeinsam, hängen Schnabellänge und Schnabeltiefe negativ zusammen: Längere Schnäbel sind flacher. Nimmt man die Art als zweiten Prädiktor in das Modell auf, kehrt sich das Vorzeichen dieses Gewichtes. Innerhalb jeder Art gilt: Je länger der Schnabel, desto tiefer ist er auch (Abbildung 4.1). Der negative Gesamtzusammenhang entsteht nur, weil die Gentoo-Pinguine lange, aber flache Schnäbel haben. Dieses Muster ist als Simpson-Paradox bekannt.
WarnungStatistische Kontrolle ist keine experimentelle Kontrolle
Die Formulierung „unter Konstanthaltung der anderen Prädiktoren“ klingt nach Experiment, ist aber rein rechnerisch gemeint. In Beobachtungsdaten hält niemand etwas konstant; das Modell vergleicht lediglich Fälle, die sich in den übrigen Prädiktoren ähneln. Ob ein partielles Gewicht kausal interpretiert werden darf, hängt davon ab, ob die richtigen Variablen im Modell sind. Wer eine wichtige Störvariable vergisst, erhält verzerrte Gewichte; wer eine Variable aufnimmt, die selbst eine Folge von \(x\) und \(y\) ist (ein sogenannter Collider), erzeugt sogar Zusammenhänge, die es gar nicht gibt. Welche Variablen in ein Modell gehören, ist deshalb eine theoretische und keine statistische Frage.
Weil die Gewichte in den Einheiten der jeweiligen Variablen angegeben werden (Gramm pro Millimeter, Punkte pro Lebensjahr …), lassen sie sich nicht direkt miteinander vergleichen. Standardisiert man vor der Schätzung alle Variablen (z-Werte), erhält man standardisierte Regressionsgewichte \(\beta^*\): Sie geben an, um wie viele Standardabweichungen sich \(y\) verändert, wenn \(x_j\) um eine Standardabweichung steigt. Das erleichtert den Vergleich, hat aber einen Preis: Standardisierte Gewichte hängen von der Streuung der Variablen in der jeweiligen Stichprobe ab und lassen sich deshalb schlecht zwischen Studien vergleichen. Für kategoriale Prädiktoren sind sie ohnehin kaum sinnvoll interpretierbar.
In der Praxis ist deshalb ein Vorschlag von Gelman (2007) verbreitet: Man zentriert die kontinuierlichen Prädiktoren und teilt sie durch zwei Standardabweichungen, während binäre Prädiktoren (0/1) und das Kriterium in ihren ursprünglichen Einheiten bleiben. Das Gewicht gibt dann an, um wie viel sich \(y\) verändert, wenn man eine Person eine Standardabweichung unter dem Mittelwert mit einer Person eine Standardabweichung darüber vergleicht. Weil ein binärer-Prädiktor mit etwa gleich großen Gruppen eine Standardabweichung von 0,5 hat, entspricht ihr Sprung von 0 auf 1 ebenfalls zwei Standardabweichungen, sodass die Gewichte kontinuierlicher und binärer Prädiktoren recht gut vergleichbar werden. Die Tabelle unten stellt die drei Varianten gegenüber. Wichtig die unterschiedlichen Transformationen haben keinen Einfluss auf die Gesamtmodellgüte, sondern stellen nur die Prädiktoren anders dar.
| Unstandardisiert | Beta (z-Werte) | 2 SD | |
|---|---|---|---|
| In der Spalte Beta ist auch das Körpergewicht z-standardisiert. | |||
| Flossenlänge | 48.21 | 0.84 | 1351.38 |
| [44.59, 51.83] | [0.78, 0.90] | [1249.83, 1452.93] | |
| Schnabellänge | -5.20 | -0.04 | -56.89 |
| [-14.76, 4.36] | [-0.10, 0.03] | [-161.46, 47.68] | |
| Geschlecht: männlich | 358.63 | 0.45 | 358.63 |
| [276.85, 440.41] | [0.34, 0.55] | [276.85, 440.41] | |
| Num.Obs. | 333 | 333 | 333 |
| R2 | 0.807 | 0.807 | 0.807 |
4.1.3 t-Test, Korrelation und Regression: ein Modell
Im Bachelorstudium lernt man die statistischen Standardverfahren meist als getrennte Werkzeuge, häufig verbunden mit einem Entscheidungsbaum: Zwei Gruppen vergleichen — t-Test. Zwei kontinuierliche Variablen — Korrelation. Mehr als zwei Gruppen — Varianzanalyse. Jacob Cohen (1968) hat schon vor über fünfzig Jahren darauf hingewiesen, dass diese Trennung künstlich ist. Fast alle dieser Verfahren sind Spezialfälle des Allgemeinen Linearen Modells (vgl. auch Lindeløv, 2019).
Der t-Test als Regression. Kodiert man die Gruppenzugehörigkeit als Dummy-Variable mit den Werten 0 und 1 (etwa 0 = weiblich, 1 = männlich), ergibt sich das Modell \(y_i = \beta_0 + \beta_1 \cdot \text{männlich}_i + \varepsilon_i\). Für weibliche Tiere (\(x = 0\)) sagt es \(\beta_0\) vorher, für männliche (\(x = 1\)) \(\beta_0 + \beta_1\). Der Achsenabschnitt ist also der Mittelwert der Referenzgruppe, und die Steigung \(\beta_1\) ist exakt die.
Mittelwertsdifferenz. Der t-Wert für \(\beta_1\) ist identisch mit dem des klassischen t-Tests für unabhängige Stichproben (mit der Annahme gleicher Varianzen). Die Regressionsgerade verbindet einfach die beiden Gruppenmittelwerte.
Die Korrelation als Regression. Standardisiert man \(x\) und \(y\) vor der Schätzung, ist die Steigung der einfachen Regression exakt der Korrelationskoeffizient \(r\). Entsprechend ist der Determinationskoeffizient \(R^2\) der einfachen Regression das Quadrat der Korrelation, und auch hier stimmen die Signifikanztests überein.
Der t-Test als Regression. Kodiert man die Gruppenzugehörigkeit als Dummy-Variable mit den Werten 0 und 1 (etwa 0 = weiblich, 1 = männlich), ergibt sich das Modell \(y_i = \beta_0 + \beta_1 \cdot \text{männlich}_i + \varepsilon_i\). Für weibliche Tiere (\(x = 0\)) sagt es \(\beta_0\) vorher, für männliche (\(x = 1\)) \(\beta_0 + \beta_1\). Der Achsenabschnitt ist also der Mittelwert der Referenzgruppe, und die Steigung \(\beta_1\) ist exakt die Mittelwertsdifferenz. Der t-Wert für \(\beta_1\) ist identisch mit dem des klassischen t-Tests für unabhängige Stichproben mit der Annahme gleicher Varianzen. Das lässt sich direkt in R überprüfen:
t.test(masse_g ~ geschlecht, data = pinguine, var.equal = TRUE) |>
  broom::tidy() |>
  select(estimate, statistic, p.value)
# A tibble: 1 × 3
estimate statistic p.value
<dbl> <dbl> <dbl>
1 -683. -8.54 4.90e-16lm(masse_g ~ geschlecht, data = pinguine) |>
broom::tidy() |>
select(term, estimate, statistic, p.value)# A tibble: 2 × 4
term estimate statistic p.value
<chr> <dbl> <dbl> <dbl>
1 (Intercept) 3862. 68.0 1.70e-196
2 geschlechtmännlich 683. 8.54 4.90e- 16Mittelwertsdifferenz, t-Wert und p-Wert stimmen überein. Nur das Vorzeichen unterscheidet sich, weil t.test() die erste Gruppe minus die zweite rechnet, lm() dagegen die zweite Gruppe minus die Referenzgruppe.
Die Korrelation als Regression. Standardisiert man \(x\) und \(y\) vor der Schätzung, ist die Steigung der einfachen Regression exakt der Korrelationskoeffizient \(r\). Entsprechend ist der Determinationskoeffizient \(R^2\) der einfachen Regression das Quadrat der Korrelation, und auch hier stimmen die Signifikanztests überein:
cor.test(~ masse_g + flosse_mm, data = pinguine) |>
  broom::tidy() |>
  select(estimate, statistic, p.value)
# A tibble: 1 × 3
estimate statistic p.value
<dbl> <dbl> <dbl>
1 0.873 32.6 3.13e-105m_kor <- lm(scale(masse_g) ~ scale(flosse_mm), data = pinguine)
broom::tidy(m_kor) |>
select(term, estimate, statistic, p.value)# A tibble: 2 × 4
term estimate statistic p.value
<chr> <dbl> <dbl> <dbl>
1 (Intercept) -5.32e-16 -1.99e-14 1.000e+ 0
2 scale(flosse_mm) 8.73e- 1 3.26e+ 1 3.13 e-105c(r_quadrat = cor(pinguine$masse_g, pinguine$flosse_mm)^2,
R2 = summary(m_kor)$r.squared)r_quadrat R2
0.7620922 0.7620922 Die Varianzanalyse als Regression. Hat ein kategorialer Prädiktor mehr als zwei Stufen, etwa die drei Pinguinarten, braucht man mehr als eine Dummy-Variable. Bei drei Arten genügen zwei: eine für Chinstrap und eine für Gentoo, während die Adelie-Pinguine als Referenzkategorie bei beiden den Wert 0 haben. Der Achsenabschnitt ist dann der Mittelwert der Referenzkategorie, und die beiden Gewichte sind die Abweichungen der anderen Arten von ihr. Der F-Test der einfaktoriellen Varianzanalyse ist nichts anderes als der Test, ob beide Gewichte gleichzeitig null sind. Die klassische ANOVA-Tabelle aus aov() und die Tabelle, die anova() für das entsprechende lineare Modell erzeugt, sind deshalb identisch:
aov(masse_g ~ art, data = pinguine) |> summary() Df Sum Sq Mean Sq F value Pr(>F)
art 2 145190219 72595110 341.9 <2e-16 ***
Residuals 330 70069447 212332
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1lm(masse_g ~ art, data = pinguine) |> anova()Analysis of Variance Table
Response: masse_g
Df Sum Sq Mean Sq F value Pr(>F)
art 2 145190219 72595110 341.89 < 2.2e-16 ***
Residuals 330 70069447 212332
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Nimmt man zusätzlich einen kontinuierlichen Prädiktor auf, wird daraus die Kovarianzanalyse (ANCOVA). Tabelle 4.2 fasst die wichtigsten Entsprechungen zusammen.
| Klassisches Verfahren | Als lineares Modell | In R |
|---|---|---|
| Einstichproben-t-Test | \(y = \beta_0\) | lm(y ~ 1) |
| t-Test (unabhängige Stichproben) | \(y = \beta_0 + \beta_1 \cdot \text{Gruppe}\) | lm(y ~ gruppe) |
| t-Test (abhängige Stichproben) | \(y_2 - y_1 = \beta_0\) | lm(y2 - y1 ~ 1) |
| Pearson-Korrelation | \(z_y = \beta_1 z_x\) | lm(scale(y) ~ scale(x)) |
| Einfaktorielle ANOVA | \(y = \beta_0 + \beta_1 D_1 + \beta_2 D_2 + \ldots\) | lm(y ~ faktor) |
| Mehrfaktorielle ANOVA | zusätzlich Produktterme der Dummies | lm(y ~ f1 * f2) |
| ANCOVA | \(y = \beta_0 + \beta_1 \cdot \text{Gruppe} + \beta_2 x\) | lm(y ~ gruppe + x) |
| Multiple Regression | \(y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \ldots\) | lm(y ~ x1 + x2) |
Der Welch-Test, die Voreinstellung von t.test() in R, passt nicht ganz in dieses Schema: Er lässt ungleiche Varianzen zu und entspricht deshalb einem linearen Modell mit gruppenspezifischer Fehlervarianz.
Diese Einsicht ist weit mehr als eine mathematische Kuriosität. Wer das Allgemeine Lineare Modell verstanden hat, muss nicht mehr ein Dutzend Verfahren mit je eigenen Annahmen auswendig lernen, sondern ein einziges Modell mit einem einzigen Satz von Annahmen. Auch wird dadurch nochmals deutlich, dass die Wahl des Analyseverfahrens keinerlei Auswirkungen auf die Interpretation der Ergebnisse im Sinne kausaler Effekte oder nicht-kausaler Zusammenhänge haben kann. Nur weil Sie statt einer Regression eine ANOVA verwenden bedeutet das nicht, dass Sie plätzlich eine kausale interpretation der Ergebnisse vornehmen können.
4.2 Wie die Parameter geschätzt werden
Das Modell in Gleichung 4.1 beschreibt, wie die Daten zustande gekommen sein könnten. Die wahren Parameter \(\beta_0, \ldots, \beta_k\) und \(\sigma\) kennen wir nicht; wir müssen sie aus den Daten schätzen. Dafür gibt es zwei klassische Prinzipien, die im linearen Modell zum selben Ergebnis führen, aber auf sehr unterschiedlichen Ideen beruhen.
4.2.1 Die Methode der kleinsten Quadrate
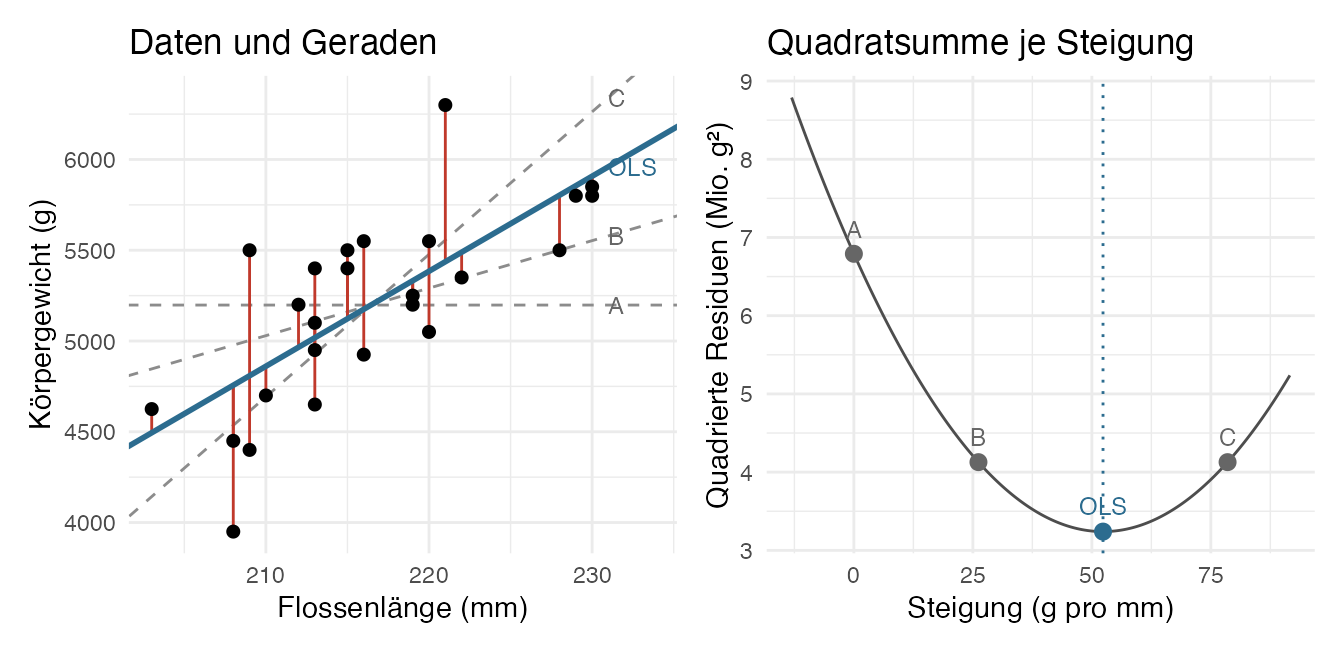
Die Methode der kleinsten Quadrate (ordinary least squares, OLS) wurde vor über 200 Jahren zum ersten Mal von Gauß entwickelt um die Bahnen von Planeten aus imperfekten Beobachtungen besser schätzen zu können. Die Idee ist für den Fall der linearen Regression auch sehr anschaulich. Für jede denkbare Gerade kann man für jeden Datenpunkt ausrechnen, wie weit er vertikal von der Geraden entfernt liegt — das ist sein Residuum \(e_i = y_i - \hat{y}_i\) (Abbildung 4.2). Als beste Gerade gilt die, bei der die Summe der quadrierten Residuen am kleinsten ist:
\[ \text{SS}_\text{Res} = \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 \rightarrow \min \]
Durch das Quadrieren zählen positive und negative Abweichungen gleichermaßen, und große Abweichungen werden stärker gewichtet als kleine. Für das lineare Modell lassen sich die OLS-Schätzer der Modellparameter dadurch sehr schnell ohne ausprobieren aus den Matrizen berechnen: \(\hat{\boldsymbol{\beta}} = (\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\mathbf{y}\).
4.2.2 Maximum-Likelihood-Schätzung
Das zweite Prinzip, die Maximum-Likelihood-Schätzung (ML), wurde von Sir Ronald Fisher (1922) ausgearbeitet und ist für den Rest dieses Buches noch wichtiger als die kleinsten Quadrate. Die Idee dreht die übliche Perspektive der Wahrscheinlichkeitsrechnung um. Normalerweise fragen wir: Wie wahrscheinlich sind bestimmte Daten, wenn die Parameter bekannt sind? Bei der ML-Schätzung sind die Daten gegeben, und wir fragen: Für welche Parameterwerte wären genau diese Daten am plausibelsten?
Likelihood ist nicht dasselbe wie Wahrscheinlichkeit. Die Likelihood ist eine Funktion der Parameter bei festen Daten und summiert sich über alle Parameterwerte nicht zu eins.
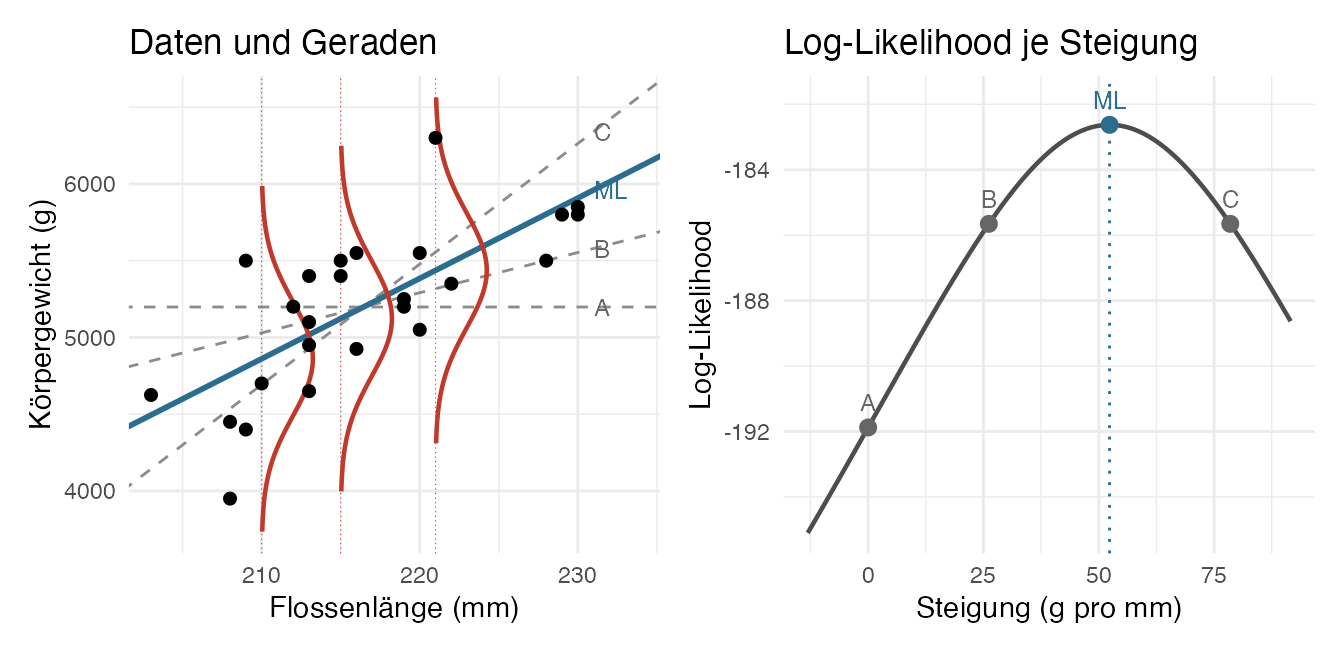
Das ALM in Gleichung 4.1 sagt für jeden Fall eine Normalverteilung der \(y\)-Werte voraus, deren Mittelwert auf der Regressionsgeraden liegt und deren Streuung \(\sigma\) beträgt (Abbildung 4.3, links). Für einen einzelnen Beobachteten Wert können wir ablesen, wie wahrscheinlich dieser ist, indem wir die Dichte dieser Verteilung an der Stelle des Prädiktor-Wertes ist. Liegt der Punkt nahe an der Geraden, ist die Dichte und damit die Wahrscheinlichkeit hoch; liegt er weit weg, ist die Dichte und damit die Wahrscheinlichkeit niedrig. Weil die Beobachtungen unabhängig sind, ist der Likelihood das Produkt der einzelnen Dichten der einzelnen Beobachtungen (_{i=1}^{n}).
\[ L(\beta_0, \ldots, \beta_k, \sigma) = \prod_{i=1}^{n} \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left(-\frac{(y_i - \hat{y}_i)^2}{2\sigma^2}\right) \]
Produkte vieler kleiner Zahlen sind rechnerisch unhandlich, deshalb arbeitet man fast immer mit dem Logarithmus, der Log-Likelihood. Aus dem Produkt der einzelnen Beobachtungen wird eine Summe der quadrierten Differenzen:
\[ \ell = \ln L = -\frac{n}{2}\ln(2\pi\sigma^2) - \frac{1}{2\sigma^2}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2 \tag{4.3}\]
Ein Blick auf die Formel Gleichung 4.3 zeigt, warum im linearen Modell der OLS-Schätzer auch dem likelihood Prinzip entspricht: Der zweite Term entspricht ja gerade der Summe der quadrierten Abweichungen zwischen den beobachteten \(y_i\) und den vorhergesagten \(\hat{y}_i\) Werten. der Die Regressionsgewichte stecken nur im zweiten Term, und der ist bis auf einen negativen Faktor genau die Summe der quadrierten Residuen. Die Log-Likelihood wird also genau dann maximal, wenn \(\text{SS}_\text{Res}\) minimal ist. Die ML-Schätzer der Regressionsgewichte sind mit den OLS-Schätzern identisch (Abbildung 4.3, rechts).
Wenn beide Verfahren dasselbe liefern, warum dann der Aufwand? Weil die kleinsten Quadrate eine Sackgasse sind, sobald wir das lineare Modell verlassen. Für eine logistische Regressionen, Mehrebenenmodelle, oder Faktorenanalysen gibt es keine sinnvolle Summe quadrierter Residuen, die man minimieren könnte. Eine Likelihood lässt sich dagegen für praktisch jedes statistische Modell aufschreiben, und die Logik bleibt immer dieselbe: Man sucht die Parameter, unter denen die beobachteten Daten am plausibelsten sind. Meist gibt es dafür keine geschlossene Lösung mehr, sondern es muss ausprobiert werden. Das macht man nicht wahllos, sondern für dieses ausprobieren gbit es unterschiedliche Verfahren zur zur sogenannten (iterative Optimierung) die mal schneller mal langsamer diese optimalen Werte finden.
4.3 Varianzaufklärung
4.3.1 Der Determinationskoeffizient R²
Auch das Modell mit den optimalen Koeffizienten ist anders als Sie selbst leider oft nicht gut genuuug.
Nachdem man optimale Schätzer für die Parameter des Modells identifiziert hat, stellt sich die Frage wie gut das Modell die Daten beschreibt? Nur weil es das Beste ist, heißt das nich nicht, dass es gut ist. Die gebräuchlichste Antwort ist der Determinationskoeffizient \(R^2\). Er beruht auf einer einfachen Zerlegung: Die Gesamtvariation der abhängigen Variable (\(\text{SS}_\text{Total}\), d.h. die quadrierten Abweichungen vom Mittelwert) teilt sich auf in einen Teil, den das Modell vorhersagt (\(\text{SS}_\text{Modell}\)), und einen Teil, der als Residuum übrig bleibt (\(\text{SS}_\text{Res}\)):
\[ R^2 = \frac{\text{SS}_\text{Modell}}{\text{SS}_\text{Total}} = 1 - \frac{\text{SS}_\text{Res}}{\text{SS}_\text{Total}} \]
\(R^2\) ist also der Anteil der Varianz in \(y\), der durch die Prädiktoren „erklärt“ wird, und liegt zwischen 0 und 1. Die Wurzel \(R\) heißt multiple Korrelation; sie ist die Korrelation zwischen beobachteten und vorhergesagten Werten.
„Erklärt“ ist hier rein statistisch gemeint: Ein Teil der Varianz lässt sich vorhersagen. Über kausale Mechanismen oder Ursachen sagt \(R^2\) nichts.
Wie groß ist ein großes \(R^2\)? Wer von den Pinguinen an hohe Werte gewöhnt ist — Flossenlänge und Körpergewicht korrelieren zu \(r = .87\), die Flossenlänge allein erklärt also 76 % der Varianz des Gewichts —, wird von den Zusammenhängen in der Praxis überrascht (Tabelle 4.3).
| Zusammenhang | \(r\) | \(R^2\) |
|---|---|---|
| Aspirin und geringeres Herzinfarktrisiko | .02 | 0,04 % |
| Rauchen und Lungenkrebs innerhalb von 25 Jahren | .08 | 0,6 % |
| Nutzung digitaler Medien und Wohlbefinden Jugendlicher | ≈ .06 | ≤ 0,4 % |
| Psychotherapie und späteres Wohlbefinden | .32 | 10 % |
| Größe und Gewicht (Erwachsene in den USA) | .44 | 19 % |
| Flossenlänge und Körpergewicht (Pinguine) | .87 | 76 % |
\(R^2\) hat eine unangenehme Eigenschaft: Es kann durch zusätzliche Prädiktoren nur steigen, nie sinken, selbst wenn diese reines Rauschen sind. Jeder zusätzliche Prädiktor passt sich ein kleines bisschen an die Zufälligkeiten der Stichprobe an. Das korrigierte \(R^2_\text{adj}\) bestraft deshalb jeden zusätzlichen Prädiktor und schätzt die Varianzaufklärung in der Population besser.
4.3.2 Inkrementelle Varianzaufklärung
In der angewandten Psychologie interessiert es selten, wie viel Varianz ein Modell insgesamt erklärt. Viel häufiger lautet die Frage: Bringt ein neuer Prädiktor etwas über das hinaus, was wir schon wissen? Lohnt sich ein aufwändiges Assessment-Center, wenn wir bereits einen Intelligenztest einsetzen? Sagt ein neuer Fragebogen zur Resilienz Burnout über die bekannten Big-Five-Faktoren hinaus vorher? Diese Frage nach der inkrementellen Validität (Hunsley & Meyer, 2003) beantwortet man mit einer hierarchischen Regression: Man schätzt nacheinander mehrere geschachtelte Modelle, in die die Prädiktoren blockweise in einer theoretisch begründeten Reihenfolge aufgenommen werden, und betrachtet den Zuwachs
\[ \Delta R^2 = R^2_\text{komplex} - R^2_\text{einfach} \]
Ob dieser Zuwachs statistisch bedeutsam ist, kann man anhand eines F-Tests prüfen, bei dem \(k\) die Anzahl der Prädiktoren im jeweiligen Modell ist:
\[ F = \frac{\Delta R^2 / (k_\text{komplex} - k_\text{einfach})}{(1 - R^2_\text{komplex}) / (n - k_\text{komplex} - 1)} \]
Für einen einzelnen zusätzlichen Prädiktor ist \(\Delta R^2\) genau die quadrierte semipartielle Korrelation \(sr^2\): der Anteil der Gesamtvarianz von \(y\), den nur dieser Prädiktor erklärt.
Ein klassisches Beispiel aus der Wirtschaftspsychologie ist die Meta-Analyse von Schmidt und Hunter (1998) zur Personalauswahl. Allgemeine kognitive Fähigkeiten sagten dort Berufserfolg mit einer Validität von \(r = .51\) vorher. Nahm man einen Integritätstest hinzu, stieg die multiple Korrelation auf \(R = .65\), was einem Zuwachs in der Varianzaufklärung von \(\Delta R^2 = .65^2 - .51^2 \approx .16\) entspricht. Kaum ein anderer Befund hat die Praxis der Personalauswahl so geprägt. Er illustriert allerdings auch, dass solche Zahlen nicht in Stein gemeißelt sind: Eine Neubewertung der zugrunde liegenden Korrekturen für Varianzeinschränkung kam zu deutlich niedrigeren Validitäten und einer veränderten Rangfolge der Verfahren (Sackett et al., 2022).
4.3.3 Wie man ΔR² (nicht) interpretiert
So einfach die Berechnung ist, so leicht lässt sich \(\Delta R^2\) falsch interpretieren. Vier Punkte sollten Sie im Blick behalten.
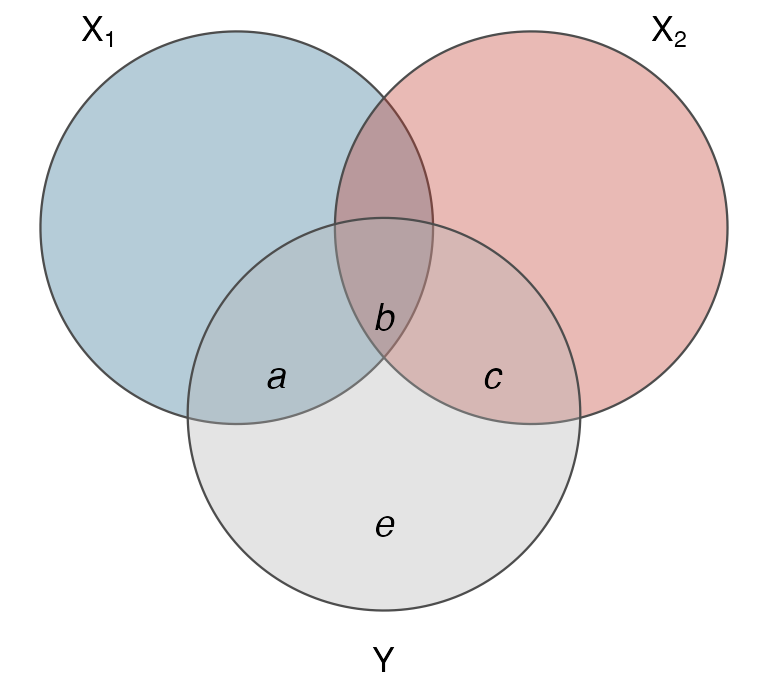
Die Reihenfolge entscheidet. Korrelieren die Prädiktoren untereinander, teilen sie sich einen Teil der Varianz, die sie an \(y\) aufklären. Man kann sich das wie in Abbildung 4.4 vorstellen: Der Bereich b, in dem sich alle drei Kreise überlappen, wird in der hierarchischen Regression immer demjenigen Prädiktor zugeschlagen, der zuerst ins Modell kommt. Nimmt man \(X_1\) zuerst auf, erklärt es \(a + b\), und \(X_2\) bringt nur noch den Zuwachs \(c\). In umgekehrter Reihenfolge ist es genau andersherum. Derselbe Prädiktor kann also je nach Reihenfolge viel oder wenig inkrementelle Varianz aufklären. Die Reihenfolge muss deshalb vorab theoretisch begründet sein — etwa: Was ist das etablierte Verfahren, was das neue, zu prüfende? Die Frage „Welcher Prädiktor ist wichtiger?“ lässt sich mit \(\Delta R^2\) allein nicht beantworten; dafür gibt es eigene Verfahren wie die Dominanzanalyse oder relative Gewichte (Johnson & LeBreton, 2004).
Signifikanz ist nicht gleich Relevanz. Wie immer gilt auch bei Betrachtungen der inkrementellen Varianz, dass Signifikanz alleine noch kein Garant dafür ist, dass der Zuwachs auch praktisch relevant ist. Bei großen Stichproben praktisch jeder noch so kleine Zuwachs signifikant. Berichten Sie deshalb immer \(\Delta R^2\) (am besten mit Konfidenzintervall) und nicht nur den p-Wert des F-Tests.
Messfehler täuschen inkrementelle Validität vor. Eine weitere wichtige Einschränkung betrifft die Rolle der Reliabilität des ersten Prädidktors. Wer zeigen will, dass ein neues Konstrukt \(X_2\) „über“ ein bekanntes Konstrukt \(X_1\) hinaus etwas vorhersagt, kontrolliert eigentlich nicht das Konstrukt, sondern nur dessen imperfekte Messung. Ist diese messfehlerbehaftet, bleibt ein Teil der Varianz von \(X_1\) unkontrolliert, und diesen Rest kann \(X_2\) aufsammeln, sofern es mit \(X_1\) korreliert. Westfall und Yarkoni (2016) haben gezeigt, dass dadurch in realistischen Szenarien massenhaft scheinbare inkrementelle Effekte entstehen. Eine kleine Simulation im Stil der Einleitung macht das Problem greifbar (Abbildung 4.5): Wir erzeugen Daten, in denen \(y\) ausschließlich vom Konstrukt \(T\) abhängt. \(X_1\) ist eine mehr oder weniger reliable Messung von \(T\), und \(X_2\) misst ebenfalls \(T\) und korreliert mit diesem zu .60, hat aber selbst keinerlei Einfluss auf \(y\). In diesem Szenario sollte \(X_2\) also keinerlei inkrementelle Varianzaufklärung gegenüber \(X_1\) besitzen. Wir schauen aber einfach mal was passiert indem wir 2.000 Stichproben generieren und checken, wie oft \(X_2\) in der Regression \(y \sim X_1 + X_2\) signifikant wird.
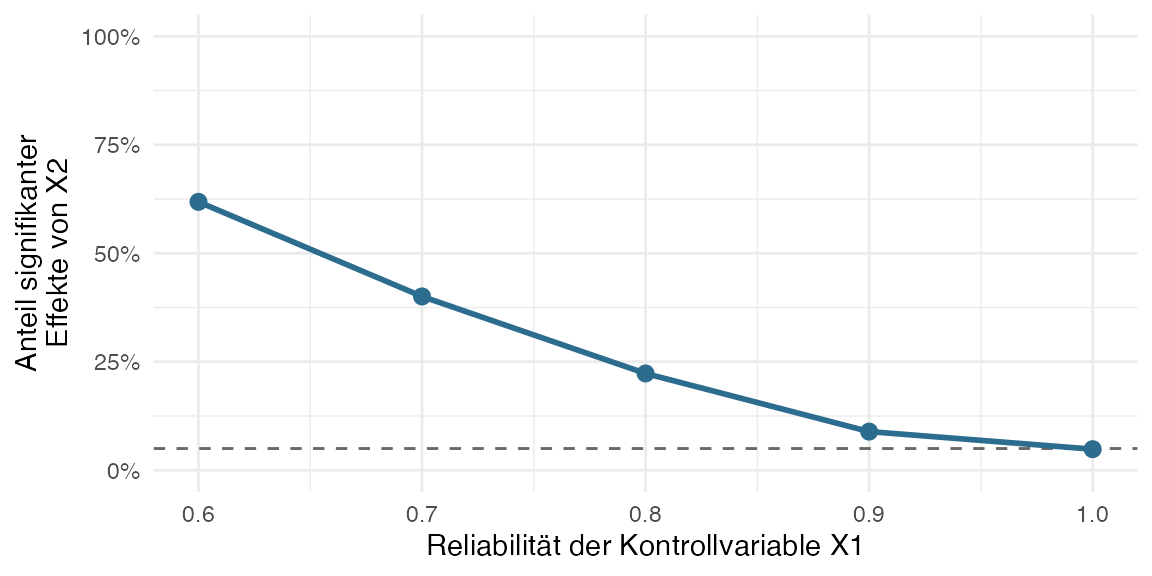
Nur bei perfekter Messung hält der Test sein Fehlerniveau von 5 % ein. Schon bei einer Reliabilität von .90, die für psychologische Skalen als sehr gut gilt, findet man den nicht existierenden Effekt weit häufiger als erwartet, und bei typischen Reliabilitäten von .70 bis .80 findet man in etwa einem viertel der Fälle eine schein- inkrementelle Varianz. Die Lehre daraus: Behauptungen über inkrementelle Validität auf Konstruktebene sind mit einer einfachen hierarchischen Regression nicht zu belegen. Wer sie ernsthaft prüfen will, braucht Modelle, die den Messfehler explizit berücksichtigen aka Strukturgleichungsmodelle.
4.4 Annahmen des linearen Modells
Jedes statistische Modell beruht auf Annahmen, und Anscombes Quartett aus dem Kapitel über Abbildungen hat gezeigt, dass man ihre Verletzung den üblichen Kennwerten nicht ansieht. Die Annahmen des linearen Modells werden oft als lose Liste auswendig gelernt. Gelman, Hill und Vehtari (2020) ordnen sie dagegen nach ihrer Wichtigkeit, und diese Reihenfolge ist aufschlussreich, weil sie ziemlich genau umgekehrt zu der Aufmerksamkeit verläuft, die den einzelnen Annahmen in der Praxis gewidmet wird.
“Far better an approximate answer to the right question, which is often vague, than an exact answer to the wrong question, which can always be made precise” — (Tukey, 1962)
- Validität. Die Daten müssen zur Forschungsfrage passen: Misst das Outcome das, was uns eigentlich interessiert? Sind alle relevanten Prädiktoren im Modell? Kein statistischer Trick der Welt die falsche Frage beantwortet.
- Repräsentativität. Die Stichprobe muss die Population abbilden, über die wir Aussagen machen wollen.
- Linearität und Additivität. Der Erwartungswert von \(y\) ist eine lineare Funktion der Prädiktoren, und ihre Effekte addieren sich. Ist der Zusammenhang gekrümmt (wie im zweiten Datensatz von Anscombe) oder hängt der Effekt eines Prädiktors von einem anderen ab, ist das Modell falsch spezifiziert. Abhilfe schaffen Transformationen, quadratische Terme oder Interaktionen.
- Unabhängigkeit der Fehler. Die Residuen verschiedener Beobachtungen dürfen nicht zusammenhängen. Diese Annahme ist verletzt, wenn Personen mehrfach gemessen werden oder in Gruppen (Teams, Schulklassen, Kliniken) organisiert sind. Die Standardfehler werden dann meist dramatisch unterschätzt. Dafür gibt es Mehrebenenmodelle, denen wir ein eigenes Kapitel widmen.
- Homoskedastizität. Die Fehlervarianz \(\sigma^2\) ist für alle Werte der Prädiktoren gleich. Ist sie es nicht (Heteroskedastizität), bleiben die Gewichte zwar unverzerrt, aber die Standardfehler und damit p-Werte und Konfidenzintervalle stimmen nicht mehr. Ein einfaches Gegenmittel sind heteroskedastizitätskonsistente (robuste) Standardfehler, etwa vom Typ HC3 (Long & Ervin, 2000).
- Normalverteilung der Fehler. Sie ist für die Schätzung der Gewichte gar nicht nötig und für Tests und Konfidenzintervalle bei nicht allzu kleinen Stichproben dank des zentralen Grenzwertsatzes ziemlich unkritisch. Wichtig wird sie vor allem, wenn man einzelne Werte vorhersagen will (Vorhersageintervalle).
WichtigNormalverteilt sein müssen die Residuen, nicht die Variablen
Ein hartnäckiges Missverständnis lautet, dass die abhängige Variable oder gar die Prädiktoren normalverteilt sein müssen (Williams et al., 2013). Das Modell macht über die Verteilung der Prädiktoren überhaupt keine Annahmen, und die abhängige Variable ist schon allein wegen der Unterschiede zwischen den Gruppen oder entlang der Prädiktoren oft nicht normalverteilt. Das Körpergewicht der Pinguine ist z. B. zweigipflig, weil die Gentoo-Pinguine so viel schwerer sind. Ein Kolmogorov-Smirnov-Test auf die Rohwerte von \(y\) prüft also schlicht die falsche Frage.
Das wichtigste Werkzeug zur Prüfung der Annahmen ist, Sie ahnen es, eine Abbildung: das Streudiagramm der Residuen gegen die vorhergesagten Werte. Wenn alles in Ordnung ist, sieht man darin eine strukturlose, gleichmäßig breite Punktwolke um die Nulllinie. Jede Struktur ist ein Hinweis auf eine verletzte Annahme (Abbildung 4.6).
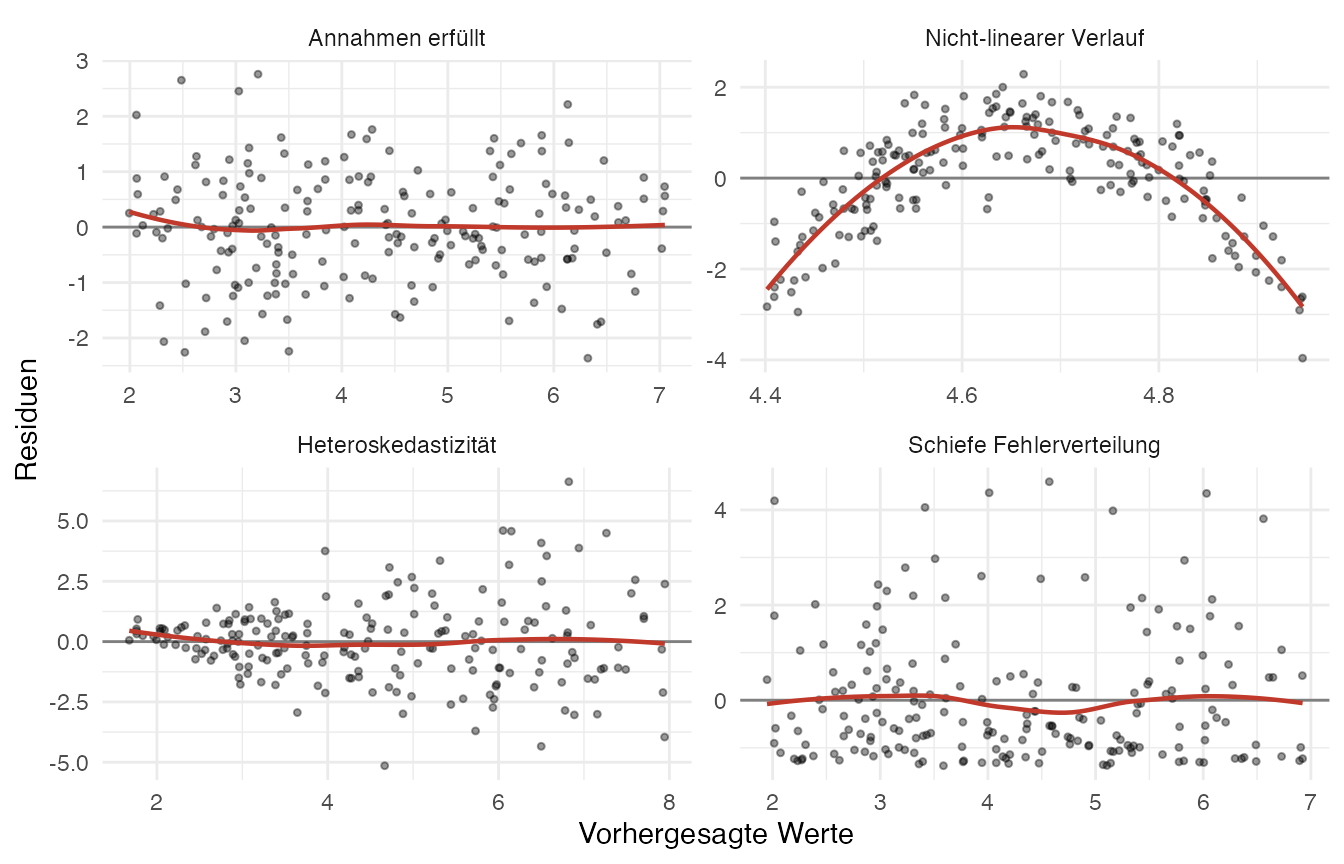
Ein gebogenes Muster deutet auf einen nicht-linearen Zusammenhang hin, eine sich trichterförmig öffnende Punktwolke auf Heteroskedastizität, und eine asymmetrische Verteilung um die Nulllinie mit einzelnen weit oben liegenden Punkten auf eine schiefe Fehlerverteilung. Formale Tests für einzelne Annahmen (etwa der Breusch-Pagan-Test auf Heteroskedastizität) gibt es zwar, sie sind aber mit Vorsicht zu genießen: In kleinen Stichproben übersehen sie relevante Verletzungen, in großen schlagen sie bei völlig harmlosen Abweichungen an. Der Blick auf die Abbildung ist meistens aufschlussreicher.
Neben diesen Annahmen gibt es zwei Eigenschaften der Daten, die man prüfen sollte, obwohl sie streng genommen keine Modellannahmen sind.
- Multikollinearität liegt vor, wenn Prädiktoren sehr hoch untereinander korrelieren. Die Schätzungen bleiben dann unverzerrt, werden aber sehr unpräzise, weil das Modell kaum unterscheiden kann, welchem Prädiktor es die gemeinsame Varianz zuordnen soll. Der Varianzinflationsfaktor (VIF) gibt an, um welchen Faktor die Varianz eines Gewichts dadurch aufgebläht wird; Werte über 5 oder 10 gelten als Warnsignal.
- Einflussreiche Fälle sind einzelne Beobachtungen, die das Ergebnis stark verändern würden, wenn man sie wegließe — wie der Ausreißer im vierten Datensatz von Anscombe. Das gebräuchlichste Maß dafür ist Cooks Distanz. Und wie im Kapitel zum Datenmanagement gilt: Einflussreiche Fälle werden nicht stillschweigend gelöscht, sondern berichtet, und das Ergebnis wird mit und ohne sie gezeigt.
4.5 Regression mit R
Nach so viel Konzept geht es nun an die praktische Umsetzung. Sie werden sehen, dass die Einheitlichkeit des Allgemeinen Linearen Modells sich direkt in R widerspiegelt: Fast alles, was wir in diesem Kapitel besprochen haben, lässt sich mit einer einzigen Funktion, lm(), und einer einheitlichen Formelschreibweise erledigen.
4.5.1 Beispieldatensatz
Wir arbeiten weiter mit den Palmer-Pinguinen. Im Kapitel zum Datenmanagement haben wir aus den Rohdaten einen analysefertigen Datensatz gebaut; der Kürze halber beginnen wir hier mit der bereits aufgeräumten Version penguins und bringen sie mit den bekannten Verben in die Form, die wir brauchen. Weil alle Modelle, die wir vergleichen wollen, auf denselben Fällen beruhen müssen, schließen wir Tiere mit fehlenden Werten vorab aus.
library(tidyverse)
library(palmerpenguins)

pinguine <- penguins |>
  select(art = species, insel = island,
         schnabel_mm = bill_length_mm, schnabeltiefe_mm = bill_depth_mm,
         flosse_mm = flipper_length_mm, masse_g = body_mass_g,
         geschlecht = sex) |>
  drop_na() |>
  mutate(geschlecht = fct_recode(geschlecht,
                                 weiblich = "female", männlich = "male"))

glimpse(pinguine)
Rows: 333
Columns: 7
$ art <fct> Adelie, Adelie, Adelie, Adelie, Adelie, Adelie, Adeli…
$ insel <fct> Torgersen, Torgersen, Torgersen, Torgersen, Torgersen…
$ schnabel_mm <dbl> 39.1, 39.5, 40.3, 36.7, 39.3, 38.9, 39.2, 41.1, 38.6,…
$ schnabeltiefe_mm <dbl> 18.7, 17.4, 18.0, 19.3, 20.6, 17.8, 19.6, 17.6, 21.2,…
$ flosse_mm <int> 181, 186, 195, 193, 190, 181, 195, 182, 191, 198, 185…
$ masse_g <int> 3750, 3800, 3250, 3450, 3650, 3625, 4675, 3200, 3800,…
$ geschlecht <fct> männlich, weiblich, weiblich, weiblich, männlich, wei…lm() schließt Fälle mit fehlenden Werten stillschweigend aus. Das kann immer dann zu Problemen führen, wenn man Modelle mit unterschiedlichen Prädiktoren vergleicht. Da man dann ggf. nicht nur die Modelle sondern vorallem die Stichproben miteinander vergleicht.
4.5.2 Die Funktion lm() und die Formelschreibweise
Lineare Modelle schätzt man in R mit lm() (für linear model). Die Funktion braucht zwei Dinge: eine Formel, die das Modell beschreibt, und den Datensatz. Links von der Tilde ~ steht die abhängige Variable, rechts stehen die Prädiktoren. Den Achsenabschnitt müssen Sie nicht angeben, er wird automatisch geschätzt. Wir beginnen mit der einfachen Regression des Körpergewichts auf die Flossenlänge:
m_flosse <- lm(masse_g ~ flosse_mm, data = pinguine)
m_flosse
Call:
lm(formula = masse_g ~ flosse_mm, data = pinguine)

Coefficients:
(Intercept)    flosse_mm
   -5872.09        50.15
Die knappe Ausgabe zeigt nur die geschätzten Koeffizienten. Pro Millimeter Flossenlänge sind die Tiere im Mittel um etwa 50 g schwerer. Der Achsenabschnitt von -5872 g ist das vorhergesagte Gewicht eines Pinguins mit einer Flossenlänge von 0 mm — ein Wert, der biologisch keinen Sinn ergibt und weit außerhalb der Daten liegt. Das ist bei Achsenabschnitten häufig und kein Grund zur Sorge. Wer einen interpretierbaren Achsenabschnitt möchte, zentriert den Prädiktor vorher (zieht also seinen Mittelwert ab); dann ist der Achsenabschnitt das vorhergesagte Gewicht bei durchschnittlicher Flossenlänge.
Eine ausführlichere Ausgabe mit Standardfehlern, t-Werten, p-Werten und \(R^2\) erhalten Sie mit summary():
summary(m_flosse)
Call:
lm(formula = masse_g ~ flosse_mm, data = pinguine)

Residuals:
     Min       1Q   Median       3Q      Max
-1057.33  -259.79   -12.24   242.97  1293.89

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -5872.09     310.29  -18.93   <2e-16 ***
flosse_mm      50.15       1.54   32.56   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 393.3 on 331 degrees of freedom
Multiple R-squared:  0.7621,    Adjusted R-squared:  0.7614
F-statistic:  1060 on 1 and 331 DF,  p-value: < 2.2e-16
Das Objekt, das lm() zurückgibt, enthält alles, was man braucht. coef(), confint(), fitted(), resid(), predict() und sigma() ziehen die einzelnen Bestandteile heraus.
Die Ausgabe ist etwas überladen, aber systematisch aufgebaut. Oben steht zur Erinnerung das Modell, darunter eine Kurzbeschreibung der Residuen, dann die Koeffiziententabelle und unten die Kennwerte des Gesamtmodells: die Standardabweichung der Residuen (Residual standard error, \(\hat\sigma\)), \(R^2\) und korrigiertes \(R^2\) sowie der F-Test des Gesamtmodells. Konfidenzintervalle für die Koeffizienten, die im Sinne der New Statistics eigentlich wichtiger sind als die p-Werte, liefert confint():
confint(m_flosse) 2.5 % 97.5 %
(Intercept) -6482.47224 -5261.71313
flosse_mm 47.12339 53.18314Die Formelschreibweise ist deutlich mächtiger, als dieses erste Beispiel vermuten lässt. Tabelle 4.4 zeigt die wichtigsten Bausteine.
| Formel | Bedeutung |
|---|---|
y ~ x |
einfache Regression mit Achsenabschnitt |
y ~ x1 + x2 |
multiple Regression, Effekte addieren sich |
y ~ x1 * x2 |
Haupteffekte und Interaktion (Kurzform für x1 + x2 + x1:x2) |
y ~ x1:x2 |
nur der Interaktionsterm |
y ~ 1 |
nur der Achsenabschnitt (Nullmodell) |
y ~ 0 + x oder y ~ x - 1 |
ohne Achsenabschnitt |
y ~ x + I(x^2) |
quadratischer Term; I() schützt die Rechnung vor der Formelsyntax |
y ~ log(x) |
transformierter Prädiktor |
y ~ . |
alle übrigen Variablen des Datensatzes als Prädiktoren |
4.5.3 t-Test, Korrelation und ANOVA mit lm()
Die im konzeptuellen Teil behauptete Einheit der Verfahren lässt sich in R direkt nachprüfen. Zuerst der t-Test: Wir vergleichen das Gewicht männlicher und weiblicher Tiere einmal mit t.test() (mit der Annahme gleicher Varianzen) und einmal mit lm(). Für die kompakte Darstellung der Koeffizienten nutzen wir tidy() aus dem Paket broom, das mit dem tidyverse installiert wird:
t.test(masse_g ~ geschlecht, data = pinguine, var.equal = TRUE)
    Two Sample t-test

data:  masse_g by geschlecht
t = -8.5417, df = 331, p-value = 4.897e-16
alternative hypothesis: true difference in means between group weiblich and group männlich is not equal to 0
95 percent confidence interval:
 -840.8014 -526.0222
sample estimates:
mean in group weiblich mean in group männlich
3862.273 4545.685 lm(masse_g ~ geschlecht, data = pinguine) |>
broom::tidy()# A tibble: 2 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 3862. 56.8 68.0 1.70e-196
2 geschlechtmännlich 683. 80.0 8.54 4.90e- 16Der Achsenabschnitt ist der Mittelwert der weiblichen Tiere, das Gewicht geschlechtmännlich die Mittelwertsdifferenz, und t-Wert und p-Wert sind identisch. Nur das Vorzeichen des t-Werts unterscheidet sich, weil t.test() die erste Gruppe minus die zweite rechnet, lm() dagegen die zweite minus die Referenzgruppe.
Kategoriale Prädiktoren wandelt R automatisch in Dummy-Variablen um. Die erste Faktorstufe ist die Referenzkategorie. Mit fct_relevel(art, "Gentoo") machen Sie eine andere Stufe zur Referenz.
Die Korrelation entspricht der Steigung einer Regression standardisierter Variablen. Mit scale() lassen sich die Variablen direkt in der Formel standardisieren:
cor.test(~ masse_g + flosse_mm, data = pinguine)
    Pearson's product-moment correlation

data:  masse_g and flosse_mm
t = 32.562, df = 331, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.8447622 0.8963550
sample estimates:
      cor
0.8729789 lm(scale(masse_g) ~ scale(flosse_mm), data = pinguine) |>
broom::tidy()# A tibble: 2 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) -5.32e-16 0.0268 -1.99e-14 1.000e+ 0
2 scale(flosse_mm) 8.73e- 1 0.0268 3.26e+ 1 3.13 e-105Und schließlich die einfaktorielle Varianzanalyse. Die klassische ANOVA-Tabelle erhält man aus aov(); wendet man anova() auf das entsprechende lineare Modell an, entsteht exakt dieselbe Tabelle:
aov(masse_g ~ art, data = pinguine) |> summary() Df Sum Sq Mean Sq F value Pr(>F)
art 2 145190219 72595110 341.9 <2e-16 ***
Residuals 330 70069447 212332
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1lm(masse_g ~ art, data = pinguine) |> anova()Analysis of Variance Table
Response: masse_g
Df Sum Sq Mean Sq F value Pr(>F)
art 2 145190219 72595110 341.89 < 2.2e-16 ***
Residuals 330 70069447 212332
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Der Vorteil der lm()-Variante zeigt sich, wenn man sich die Koeffizienten ansieht: Sie liefern nicht nur die Information, dass sich die Arten unterscheiden, sondern auch, wie stark sich Chinstrap- und Gentoo-Pinguine von der Referenzkategorie Adelie unterscheiden.
lm(masse_g ~ art, data = pinguine) |>
  broom::tidy(conf.int = TRUE)
# A tibble: 3 × 7
term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 3706. 38.1 97.2 6.88e-245 3631. 3781.
2 artChinstrap 26.9 67.7 0.398 6.91e- 1 -106. 160.
3 artGentoo 1386. 56.9 24.4 1.01e- 75 1274. 1498.4.5.4 Multiple Regression
Nun nehmen wir mehrere Prädiktoren gleichzeitig ins Modell auf. Wir sagen das Körpergewicht aus Flossenlänge, Geschlecht und Art vorher:
m_voll <- lm(masse_g ~ flosse_mm + geschlecht + art, data = pinguine)
summary(m_voll)
Call:
lm(formula = masse_g ~ flosse_mm + geschlecht + art, data = pinguine)

Residuals:
   Min     1Q Median     3Q    Max
-721.8 -195.7   -5.9  198.6  873.7

Coefficients:
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)        -365.817    532.050  -0.688   0.4922
flosse_mm            20.025      2.846   7.037 1.15e-11 ***
geschlechtmännlich  530.381     37.810  14.027  < 2e-16 ***
artChinstrap        -87.634     46.347  -1.891   0.0595 .
artGentoo           836.260     85.185   9.817  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 295.6 on 328 degrees of freedom
Multiple R-squared:  0.8669,    Adjusted R-squared:  0.8653
F-statistic:   534 on 4 and 328 DF,  p-value: < 2.2e-16
Die Interpretation folgt der Logik der partiellen Gewichte. Pro Millimeter Flossenlänge sind die Tiere bei gleichem Geschlecht und gleicher Art um 20 g schwerer — deutlich weniger als die 50 g aus der einfachen Regression, weil ein Teil des einfachen Zusammenhangs darauf zurückging, dass die schwereren Gentoo-Pinguine auch längere Flossen haben. Männliche Tiere sind bei gleicher Flossenlänge und Art um 530 g schwerer als weibliche. Die Artkoeffizienten beschreiben die Unterschiede zu Adelie-Pinguinen gleichen Geschlechts und gleicher Flossenlänge.
Das Modell unterstellt, dass die Steigung der Flossenlänge für alle Arten und beide Geschlechter gleich ist, dass also die Regressionsgeraden parallel verlaufen. Ob das stimmt, prüft man mit einem Interaktionsterm, etwa flosse_mm * art. Interaktionen und ihre Interpretation (Moderation) vertiefen wir im nächsten Kapitel zu Varianzanalysen.
Um die Stärke der Prädiktoren trotz unterschiedlicher Einheiten zu vergleichen, kann man standardisierte Gewichte berechnen. Am einfachsten geht das, indem man die kontinuierlichen Variablen vorher mit scale() z-standardisiert; as.numeric() sorgt dafür, dass aus dem Ergebnis wieder ein einfacher Vektor wird. Kategoriale Prädiktoren lassen wir dabei unverändert:
pinguine_z <- pinguine |>
  mutate(across(c(masse_g, flosse_mm, schnabel_mm), \(x) as.numeric(scale(x))))

lm(masse_g ~ flosse_mm + schnabel_mm, data = pinguine_z) |>
  broom::tidy()
# A tibble: 3 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) -4.02e-16 0.0268 -1.50e-14 1.000e+ 0
2 flosse_mm 8.51e- 1 0.0354 2.40e+ 1 1.74 e-74
3 schnabel_mm 3.37e- 2 0.0354 9.51e- 1 3.42 e- 14.5.5 Hierarchische Regression und inkrementelle Varianzaufklärung
Für eine hierarchische Regression schätzt man die geschachtelten Modelle nacheinander. Wir nehmen zuerst die Flossenlänge auf, dann das Geschlecht und zuletzt die Art. Die Modelle speichern wir in einer benannten Liste, weil wir sie später gemeinsam in eine Tabelle übergeben wollen:
m1 <- lm(masse_g ~ flosse_mm, data = pinguine)
m2 <- lm(masse_g ~ flosse_mm + geschlecht, data = pinguine)
m3 <- lm(masse_g ~ flosse_mm + geschlecht + art, data = pinguine)

modelle <- list("Modell 1" = m1, "Modell 2" = m2, "Modell 3" = m3)
Die F-Tests für die Zuwächse liefert anova(), wenn man ihr mehrere geschachtelte Modelle übergibt. Jede Zeile vergleicht ein Modell mit dem vorhergehenden:
anova(m1, m2, m3)Analysis of Variance Table
Model 1: masse_g ~ flosse_mm
Model 2: masse_g ~ flosse_mm + geschlecht
Model 3: masse_g ~ flosse_mm + geschlecht + art
Res.Df RSS Df Sum of Sq F Pr(>F)
1 331 51211963
2 330 41795374 1 9416589 107.793 < 2.2e-16 ***
3 328 28653568 2 13141806 75.218 < 2.2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1anova() mit einem Modell liefert Tests für die einzelnen Terme, mit mehreren Modellen den Vergleich der Modelle.
Die Spalte RSS enthält die Residuenquadratsummen, Df die Zahl der zusätzlichen Parameter, und F und Pr(>F) den Test auf den Zuwachs. \(R^2\) und \(\Delta R^2\) zeigt anova() nicht direkt an; wir berechnen sie mit map_dbl(), das eine Funktion auf jedes Element der Liste anwendet. lag() holt den Wert der vorherigen Zeile, sodass die Differenz den Zuwachs ergibt. Zusätzlich berechnen wir Cohens \(f^2\):
r2_tabelle <- tibble(
  modell = names(modelle),
  r2     = map_dbl(modelle, \(m) summary(m)$r.squared)
) |>
  mutate(
    delta_r2 = r2 - lag(r2, default = 0),
    f2       = delta_r2 / (1 - r2)
  )

r2_tabelle
# A tibble: 3 × 4
modell r2 delta_r2 f2
<chr> <dbl> <dbl> <dbl>
1 Modell 1 0.762 0.762 3.20
2 Modell 2 0.806 0.0437 0.225
3 Modell 3 0.867 0.0611 0.459Die Flossenlänge allein erklärt bereits 76 % der Varianz des Körpergewichts. Das Geschlecht bringt weitere 4.4 Prozentpunkte, die Art noch einmal 6.1 Prozentpunkte. (Für das erste Modell ist \(f^2\) in dieser Tabelle nicht als Zuwachs, sondern als Effekt des Gesamtmodells zu lesen.)
Wie stark die inkrementelle Varianzaufklärung von der Reihenfolge abhängt, sehen wir, wenn wir die Blöcke umdrehen und die Art zuerst aufnehmen:
r2 <- \(m) summary(m)$r.squared

m_art        <- lm(masse_g ~ art, data = pinguine)
m_art_flosse <- lm(masse_g ~ art + flosse_mm, data = pinguine)

# Zuwachs durch die Flossenlänge ...
r2(m1) - 0                    # ... wenn sie als Erstes aufgenommen wird
[1] 0.7620922r2(m_art_flosse) - r2(m_art) # ... wenn die Art bereits im Modell ist[1] 0.1125446Als erster Prädiktor klärt die Flossenlänge 76 % der Varianz auf, nach der Art nur noch 11.3 %. Der Großteil ihrer Vorhersagekraft ist also Varianz, die sie mit der Art teilt.
4.5.6 Annahmen prüfen
Für die Prüfung der Annahmen bringt R eine eigene Abbildungsfunktion mit. Wendet man plot() auf ein lm-Objekt an, entstehen vier diagnostische Grafiken: Residuen gegen vorhergesagte Werte, ein Q-Q-Plot der standardisierten Residuen, ein Scale-Location-Plot zur Prüfung der Homoskedastizität und ein Plot der Residuen gegen die Hebelwerte mit Konturlinien für Cooks Distanz.
par(mfrow = c(2, 2))
plot(m3)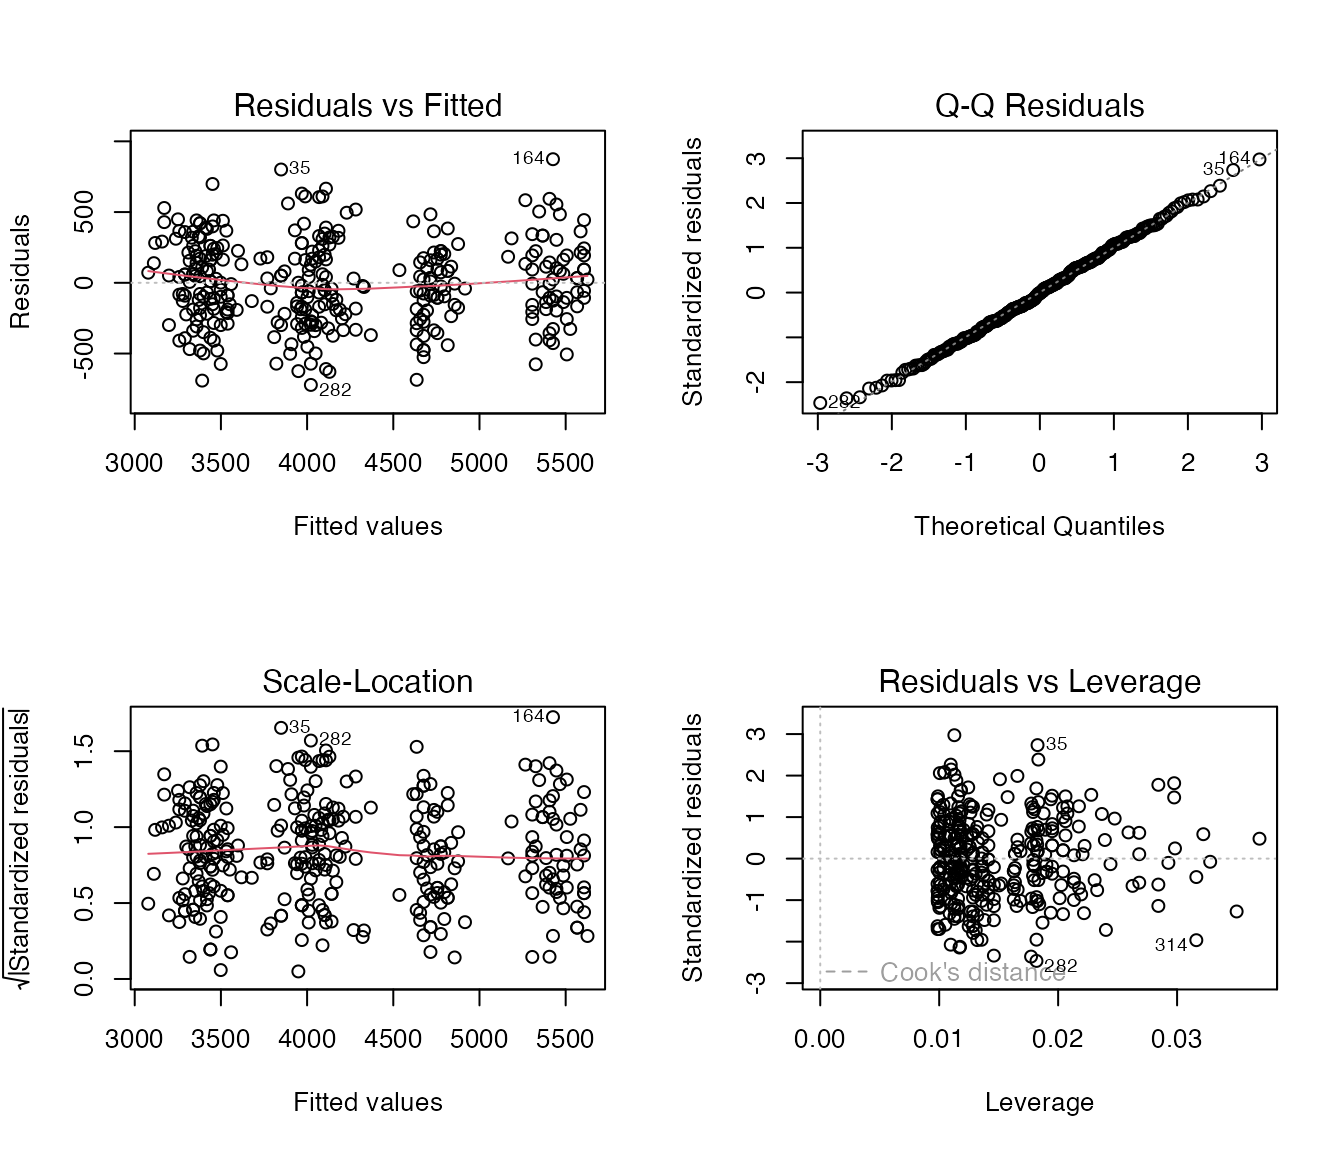
Übersichtlicher und mit Hinweisen, worauf man achten sollte, ist die Funktion check_model() aus dem Paket performance. Sie erzeugt ein ganzes Panel von Diagnosegrafiken, die jeweils im Untertitel beschreiben, wie das Idealbild aussieht:
library(performance)
check_model(m3)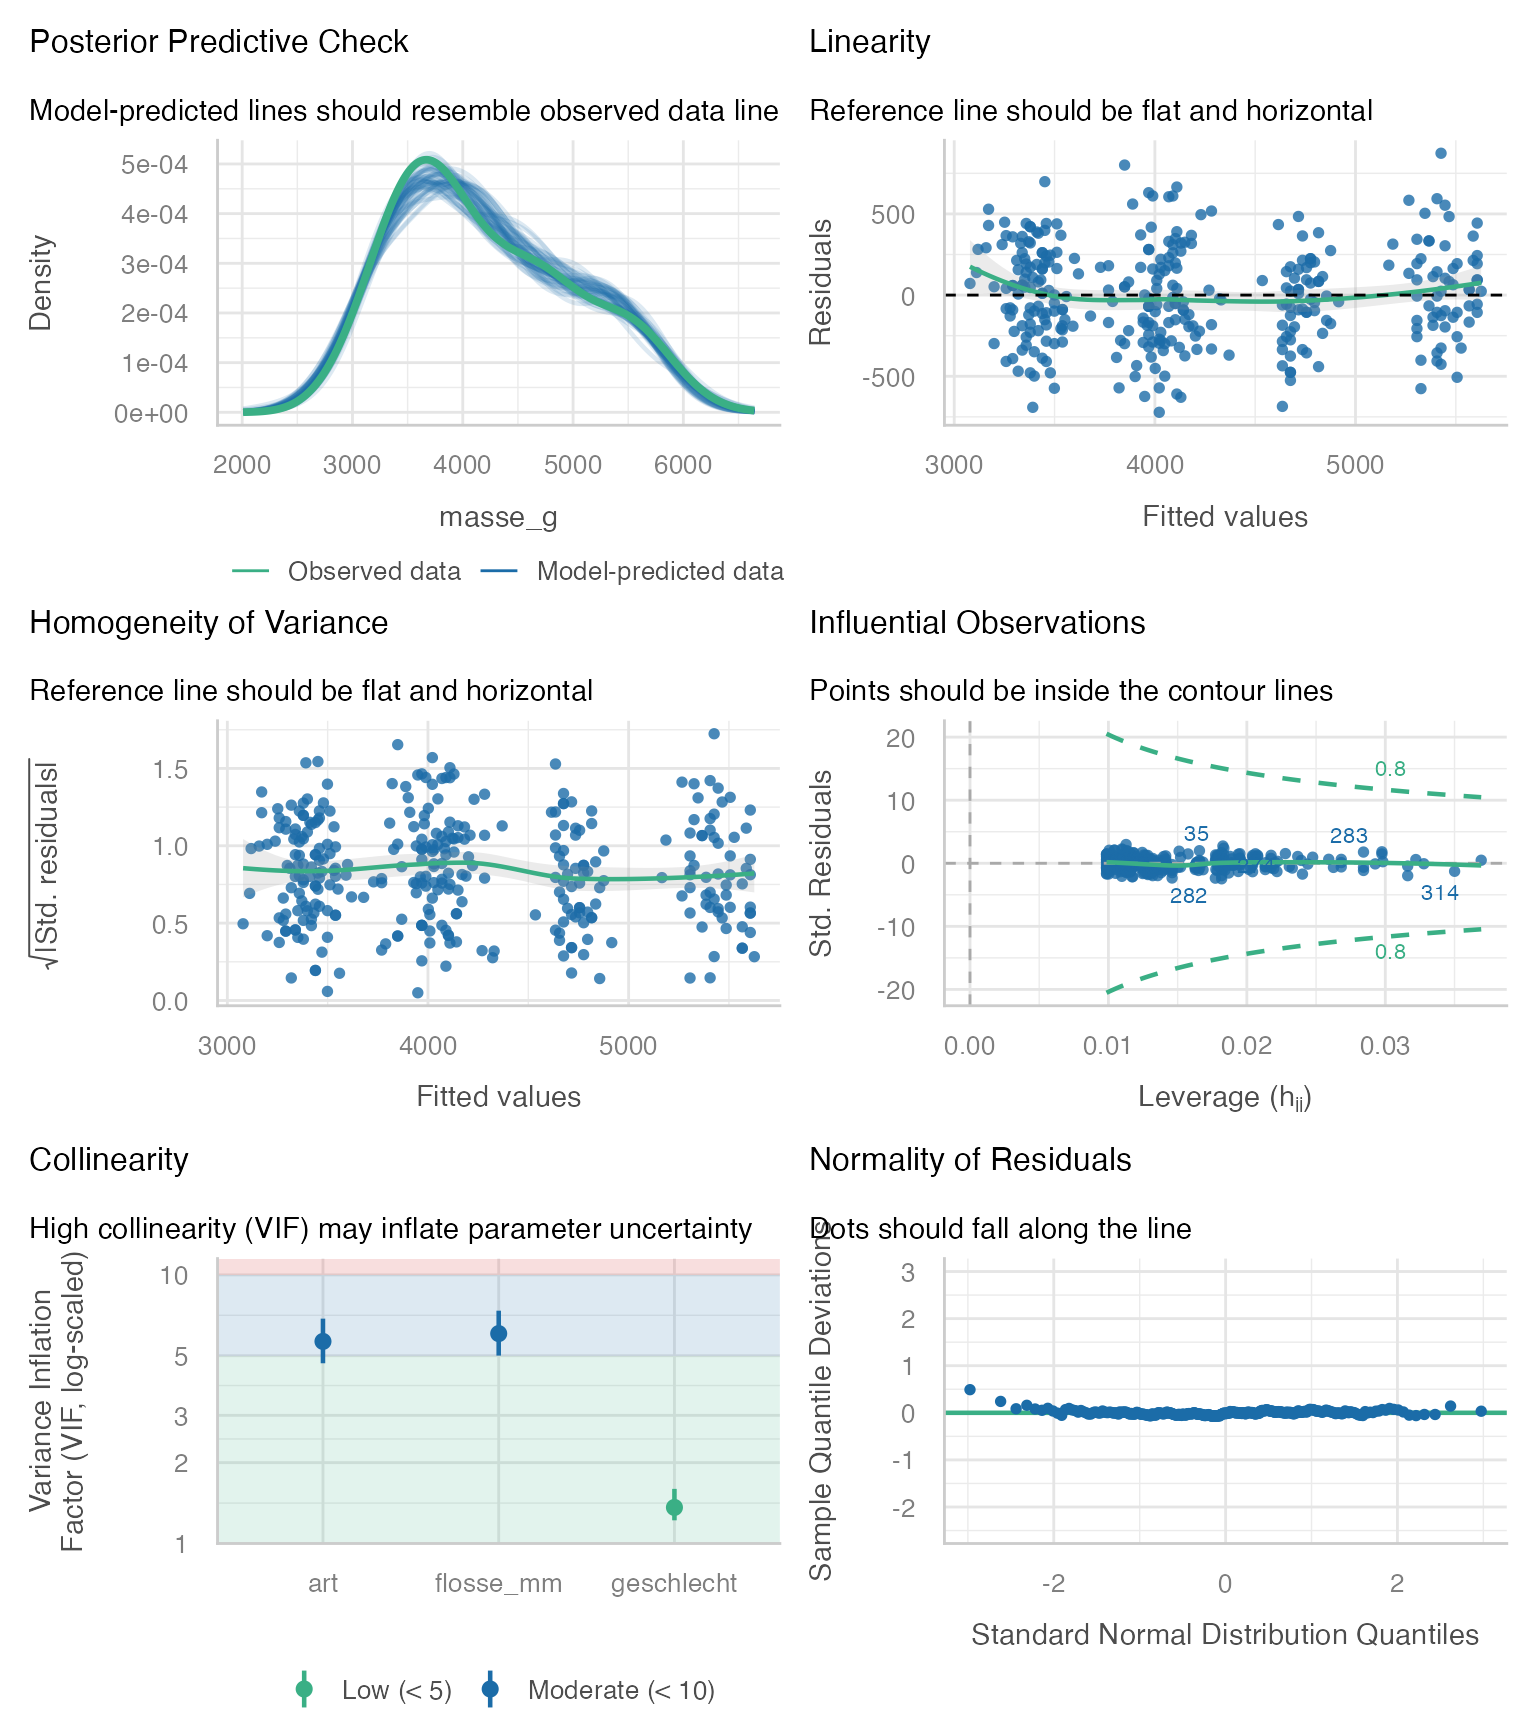
Hinweis
performance und das für die Grafiken benötigte see sind Zusatzpakete: install.packages(c("performance", "see")).
Einzelne Aspekte lassen sich auch gezielt abfragen. Die Varianzinflationsfaktoren liefert check_collinearity() (oder vif() aus dem Paket car). Einflussreiche Fälle findet man über Cooks Distanz; eine verbreitete Faustregel betrachtet Werte über \(4/n\) genauer:
check_collinearity(m3)# Check for Multicollinearity
Low Correlation
Term VIF VIF 95% CI adj. VIF Tolerance Tolerance 95% CI
geschlecht 1.36 [1.22, 1.60] 1.17 0.73 [0.63, 0.82]
Moderate Correlation
Term VIF VIF 95% CI adj. VIF Tolerance Tolerance 95% CI
flosse_mm 6.05 [5.01, 7.36] 2.46 0.17 [0.14, 0.20]
art 5.65 [4.69, 6.87] 1.54 0.18 [0.15, 0.21]cooks <- cooks.distance(m3)
sum(cooks > 4 / nrow(pinguine)) # Anzahl auffälliger Fälle[1] 13pinguine[which.max(cooks), ] # der einflussreichste Fall# A tibble: 1 × 7
art insel schnabel_mm schnabeltiefe_mm flosse_mm masse_g geschlecht
<fct> <fct> <dbl> <dbl> <int> <int> <fct>
1 Adelie Dream 39.8 19.1 184 4650 männlich Die Faustregel ist bewusst streng und markiert in fast jedem Datensatz einige Fälle. Das ist kein Grund, diese auszuschließen, sondern ein Anlass, sie sich anzusehen und ggf. das Modell zur Kontrolle ohne sie zu schätzen.
Stellt sich Heteroskedastizität heraus, kann man die Standardfehler robust schätzen. Die Pakete sandwich und lmtest erledigen das zusammen; die Koeffizienten bleiben gleich, nur Standardfehler, t- und p-Werte ändern sich:
library(sandwich)
library(lmtest)

coeftest(m3, vcov = vcovHC(m3, type = "HC3"))
t test of coefficients:

                    Estimate Std. Error t value  Pr(>|t|)
(Intercept)        -365.8174   514.3911 -0.7112   0.47749
flosse_mm            20.0249     2.7514  7.2782 2.518e-12 ***
geschlechtmännlich  530.3811    37.9101 13.9905 < 2.2e-16 ***
artChinstrap        -87.6345    50.3464 -1.7406   0.08269 .
artGentoo           836.2600    84.9926  9.8392 < 2.2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
4.5.7 Ergebnisse visualisieren
Ganz im Sinne des Kapitels über Abbildungen sollte man sich ein Modell nicht nur als Tabelle ansehen. Für die multiple Regression bietet es sich an, die vorhergesagten Werte zusammen mit den Rohdaten darzustellen. Mit predict() erhalten wir für jeden Fall den vorhergesagten Wert, und mit ggplot2 zeichnen wir ihn als Linie über die Punkte. Weil das Modell keine Interaktionen enthält, entstehen für jede Kombination aus Art und Geschlecht parallele Geraden:
pinguine |>
  mutate(vorhersage = predict(m3)) |>
  ggplot(aes(flosse_mm, masse_g, colour = art)) +
  geom_point(alpha = 0.4) +
  geom_line(aes(y = vorhersage, linetype = geschlecht), linewidth = 0.8) +
  scale_colour_viridis_d(end = 0.85) +
  labs(x = "Flossenlänge (mm)", y = "Körpergewicht (g)",
       colour = "Art", linetype = "Geschlecht")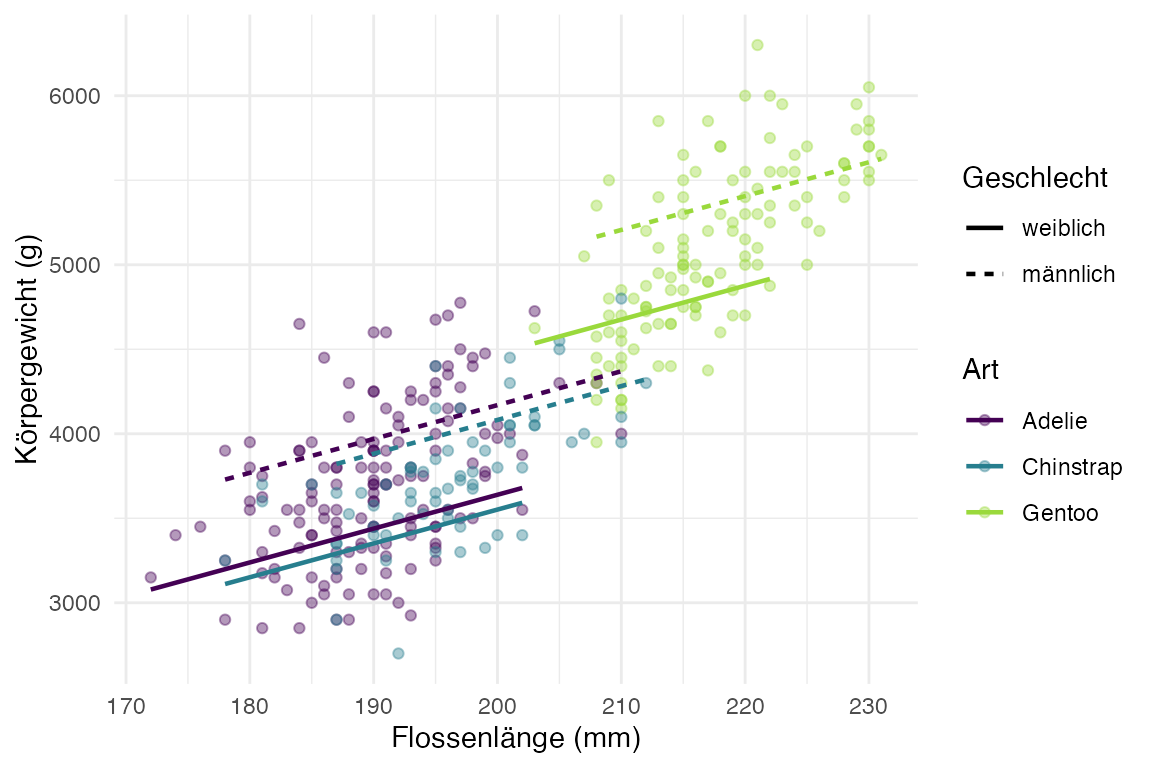
Für einzelne Konstellationen, etwa das erwartete Gewicht eines männlichen Gentoo-Pinguins mit 220 mm Flossenlänge, übergibt man predict() einen neuen Datensatz. Mit interval = "confidence" erhält man das Konfidenzintervall für den mittleren vorhergesagten Wert, mit interval = "prediction" das deutlich breitere Vorhersageintervall für ein einzelnes Tier:
neu <- tibble(flosse_mm = 220, geschlecht = "männlich", art = "Gentoo")

predict(m3, newdata = neu, interval = "confidence")
fit lwr upr
1 5406.305 5344.53 5468.08predict(m3, newdata = neu, interval = "prediction") fit lwr upr
1 5406.305 4821.591 5991.0194.6 Schicke Tabellen mit modelsummary
Die Ausgabe von summary() ist für die eigene Arbeit gut geeignet, für einen Bericht oder eine Publikation aber unbrauchbar. Regressionsergebnisse von Hand in eine Word-Tabelle zu übertragen, ist nicht nur mühsam, sondern genau die Art von Handarbeit, vor der uns das Kapitel zum Datenmanagement gewarnt hat: Jeder Tippfehler bleibt unbemerkt, und jede Änderung am Modell erfordert eine neue Abschrift. Das Paket modelsummary (Arel-Bundock, 2022) erzeugt aus einem oder mehreren Modellen direkt eine formatierte Tabelle, die sich nach HTML, Word, PDF oder LaTeX exportieren lässt.
Hinweis
modelsummary ist ein Zusatzpaket: install.packages("modelsummary").
4.6.1 Die Grundfunktion
Im einfachsten Fall übergeben Sie modelsummary() ein Modell oder eine (benannte) Liste von Modellen. Jedes Modell wird zu einer Spalte, gleichnamige Koeffizienten werden in dieselbe Zeile geschrieben, und am Ende stehen die Kennwerte der Modellgüte:
library(modelsummary)

modelsummary(modelle)| Modell 1 | Modell 2 | Modell 3 | |
|---|---|---|---|
| (Intercept) | -5872.093 | -5410.300 | -365.817 |
| (310.285) | (285.798) | (532.050) | |
| flosse_mm | 50.153 | 46.982 | 20.025 |
| (1.540) | (1.441) | (2.846) | |
| geschlechtmännlich | 347.850 | 530.381 | |
| (40.342) | (37.810) | ||
| artChinstrap | -87.634 | ||
| (46.347) | |||
| artGentoo | 836.260 | ||
| (85.185) | |||
| Num.Obs. | 333 | 333 | 333 |
| R2 | 0.762 | 0.806 | 0.867 |
| R2 Adj. | 0.761 | 0.805 | 0.865 |
| AIC | 4928.1 | 4862.5 | 4740.8 |
| BIC | 4939.6 | 4877.7 | 4763.6 |
| Log.Lik. | -2461.073 | -2427.242 | -2364.387 |
| F | 1060.295 | 684.803 | 534.024 |
| RMSE | 392.16 | 354.28 | 293.34 |
Die Namen der Liste werden zu Spaltenüberschriften. Eine unbenannte Liste erhält die Überschriften (1), (2), (3).
Schon diese Standardtabelle ist ein großer Fortschritt: Die drei Modelle der hierarchischen Regression stehen nebeneinander, man sieht auf einen Blick, wie sich die Koeffizienten der Flossenlänge beim Hinzufügen weiterer Prädiktoren verändern, und die Standardfehler stehen in Klammern darunter. Für eine Publikation fehlen aber noch einige Anpassungen.
4.6.2 Tabellen anpassen
Die wichtigsten Stellschrauben sind die folgenden Argumente:
estimateundstatisticlegen fest, was in den Zellen steht. Beide akzeptieren Vorlagen mit geschweiften Klammern, etwa"{estimate}{stars}"für den Koeffizienten mit Signifikanzsternchen oder"[{conf.low}, {conf.high}]"für das Konfidenzintervall.starsbestimmt die Grenzen für die Sternchen. Die Voreinstellung verwendet auch ein+für p < .10; mitc("*" = .05, "**" = .01, "***" = .001)erhält man die in der Psychologie üblichen Stufen.coef_mapbenennt die Koeffizienten um und legt gleichzeitig ihre Reihenfolge fest. Koeffizienten, die nicht aufgeführt sind, werden weggelassen. (Wer nur umbenennen möchte, nimmtcoef_rename.)gof_mapwählt die Kennwerte der Modellgüte (goodness of fit) aus, benennt sie und legt die Nachkommastellen fest.fmtbestimmt die Zahl der Nachkommastellen,notesfügt Anmerkungen unter der Tabelle hinzu.
Mit diesen Bausteinen entsteht eine Tabelle, die man so in eine Haus- oder Abschlussarbeit übernehmen kann:
koeffizienten <- c(
  "(Intercept)"        = "Achsenabschnitt",
  "flosse_mm"          = "Flossenlänge (mm)",
  "geschlechtmännlich" = "Geschlecht: männlich",
  "artChinstrap"       = "Art: Zügelpinguin",
  "artGentoo"          = "Art: Eselspinguin"
)

guete <- tribble(
  ~raw,            ~clean,       ~fmt,
  "nobs",          "N",          0,
  "r.squared",     "R²",         3,
  "adj.r.squared", "R² (korr.)", 3,
  "aic",           "AIC",        0
)

delta_zeile <- tibble(
  term       = "ΔR²",
  `Modell 1` = r2_tabelle$delta_r2[1],
  `Modell 2` = r2_tabelle$delta_r2[2],
  `Modell 3` = r2_tabelle$delta_r2[3]
) |>
mutate(across(-term, \(x) sprintf("%.3f", x)))modelsummary(
modelle,
estimate = "{estimate}{stars}",
statistic = "[{conf.low}, {conf.high}]",
stars = c("*" = .05, "**" = .01, "***" = .001),
fmt = 1,
notes = "Referenzkategorien: weiblich, Adeliepinguin."
)| Modell 1 | Modell 2 | Modell 3 | |
|---|---|---|---|
| Referenzkategorien: weiblich, Adeliepinguin. | |||
| (Intercept) | -5872.1*** | -5410.3*** | -365.8 |
| [-6482.5, -5261.7] | [-5972.5, -4848.1] | [-1412.5, 680.8] | |
| flosse_mm | 50.2*** | 47.0*** | 20.0*** |
| [47.1, 53.2] | [44.1, 49.8] | [14.4, 25.6] | |
| geschlechtmännlich | 347.9*** | 530.4*** | |
| [268.5, 427.2] | [456.0, 604.8] | ||
| artChinstrap | -87.6 | ||
| [-178.8, 3.5] | |||
| artGentoo | 836.3*** | ||
| [668.7, 1003.8] | |||
| Num.Obs. | 333 | 333 | 333 |
| R2 | 0.762 | 0.806 | 0.867 |
| R2 Adj. | 0.761 | 0.805 | 0.865 |
| AIC | 4928.1 | 4862.5 | 4740.8 |
| BIC | 4939.6 | 4877.7 | 4763.6 |
| Log.Lik. | -2461.073 | -2427.242 | -2364.387 |
| F | 1060.295 | 684.803 | 534.024 |
| RMSE | 392.16 | 354.28 | 293.34 |
Tabelle 4.6 zeigt die Ergebnisse der hierarchischen Regression kompakt und vollständig: Koeffizienten mit Sternchen, Konfidenzintervalle statt Standardfehler, verständliche Beschriftungen, die Varianzaufklärung jedes Modells und den jeweiligen Zuwachs.
4.6.3 Robuste Standardfehler in der Tabelle
modelsummary() kann über das Argument vcov auch direkt robuste Standardfehler berechnen. Übergibt man dasselbe Modell zweimal mit unterschiedlichen Schätzern für die Standardfehler, sieht man sofort, ob sich die Schlussfolgerungen ändern oder nicht.
modelsummary(
  list("Klassisch" = m3, "Robust (HC3)" = m3),
  vcov     = c("classical", "HC3"),
  fmt      = 1
)| Klassisch | Robust (HC3) | |
|---|---|---|
| (Intercept) | -365.8 | -365.8 |
| (532.1) | (514.4) | |
| flosse_mm | 20.0 | 20.0 |
| (2.8) | (2.8) | |
| geschlechtmännlich | 530.4 | 530.4 |
| (37.8) | (37.9) | |
| artChinstrap | -87.6 | -87.6 |
| (46.3) | (50.3) | |
| artGentoo | 836.3 | 836.3 |
| (85.2) | (85.0) | |
| Num.Obs. | 333 | 333 |
| R2 | 0.867 | 0.867 |
| R2 Adj. | 0.865 | 0.865 |
| AIC | 4740.8 | 4740.8 |
| BIC | 4763.6 | 4763.6 |
| Log.Lik. | -2364.387 | -2364.387 |
| F | 534.024 | 566.845 |
| RMSE | 293.34 | 293.34 |
| Std.Errors | Classical | HC3 |
4.6.4 Koeffizienten als Abbildung
Tabellen sind gut zum Nachschlagen, aber Abbildungen sind besser zum Vergleichen. Die Funktion modelplot() aus demselben Paket stellt die Koeffizienten mit ihren Konfidenzintervallen als Koeffizientenplot dar. Weil das Ergebnis ein gewöhnliches ggplot-Objekt ist, lässt es sich mit allen Mitteln aus dem Kapitel über Abbildungen weiter anpassen:
modelplot(modelle, coef_map = rev(koeffizienten[-1])) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey50") +
  scale_colour_viridis_d(end = 0.85) +
  labs(x = "Koeffizient (g) mit 95%-KI", colour = NULL)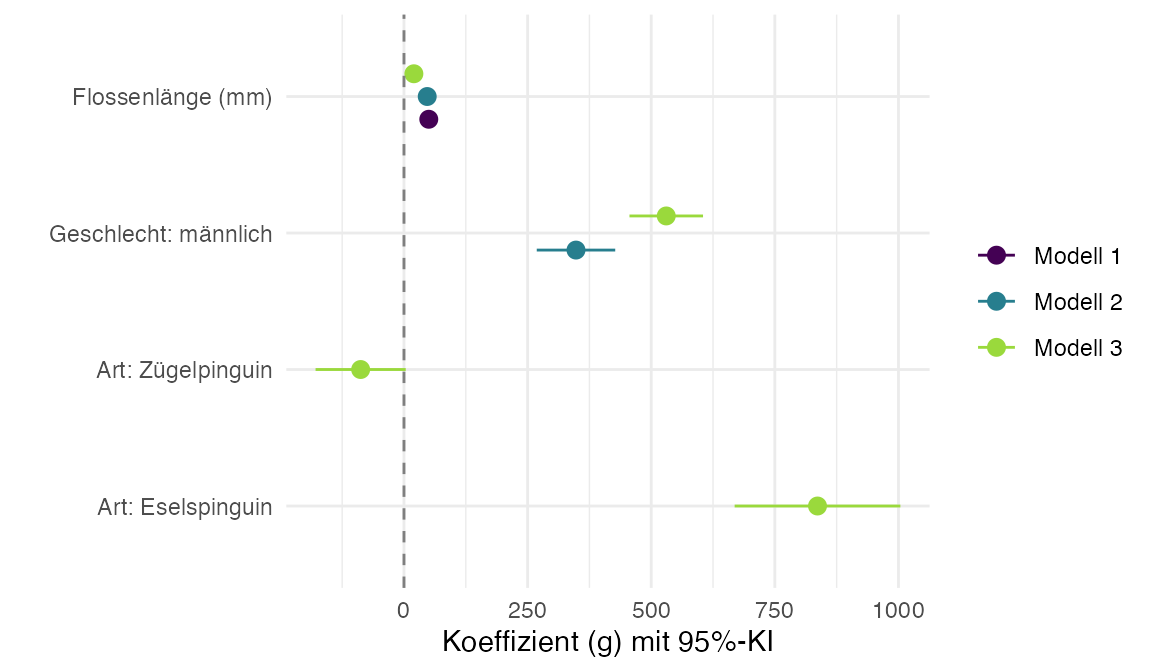
Den Achsenabschnitt lässt man im Koeffizientenplot meist weg (dafür koeffizienten[-1]), weil er auf einer ganz anderen Skala liegt und alle anderen Koeffizienten zusammenstaucht.
4.6.5 Deskriptive Tabellen
Neben Modelltabellen bietet modelsummary eine Familie von Funktionen für deskriptive Tabellen, die alle mit datasummary beginnen. Sie sind eine Alternative zu compareGroups aus dem Kapitel zum Datenmanagement und haben den Vorteil, dass sie dieselben Exportwege nutzen. datasummary_skim() gibt einen schnellen Überblick über alle numerischen Variablen, datasummary_correlation() erstellt eine Korrelationsmatrix, wie sie in fast jeder Publikation vor den Regressionsergebnissen steht, und datasummary_balance() vergleicht Gruppen:
pinguine |>
  select(Masse = masse_g, Flosse = flosse_mm,
         Schnabellänge = schnabel_mm, Schnabeltiefe = schnabeltiefe_mm) |>
datasummary_correlation()| Masse | Flosse | Schnabellänge | Schnabeltiefe | |
|---|---|---|---|---|
| Masse | 1 | . | . | . |
| Flosse | .87 | 1 | . | . |
| Schnabellänge | .59 | .65 | 1 | . |
| Schnabeltiefe | -.47 | -.58 | -.23 | 1 |
pinguine_auswahl <- pinguine |>
  select(geschlecht, masse_g, flosse_mm, schnabel_mm, art)

datasummary_balance(~ geschlecht, data = pinguine_auswahl)| weiblich (N=165) | männlich (N=168) | ||||
|---|---|---|---|---|---|
| Mean | Std. Dev. | Mean | Std. Dev. | ||
| masse_g | 3862.3 | 666.2 | 4545.7 | 787.6 | |
| flosse_mm | 197.4 | 12.5 | 204.5 | 14.5 | |
| schnabel_mm | 42.1 | 4.9 | 45.9 | 5.4 | |
| N | Pct. | N | Pct. | ||
| art | Adelie | 73 | 44.2 | 73 | 43.5 |
| Chinstrap | 34 | 20.6 | 34 | 20.2 | |
| Gentoo | 58 | 35.2 | 61 | 36.3 | |
4.6.6 Tabellen exportieren
Alle Funktionen des Pakets haben ein Argument output. Gibt man dort einen Dateinamen an, bestimmt die Endung das Format. So landet die Tabelle direkt in einem Word-Dokument, das Sie in Ihre Arbeit einfügen können, ohne eine einzige Zahl abzutippen:
modelsummary(modelle, output = "regression.docx")
modelsummary(modelle, output = "regression.html")
modelsummary(modelle, output = "regression.tex")
4.7 Fazit
- Das Allgemeine Lineare Modell beschreibt Daten als gewichtete Summe von Prädiktoren plus normalverteilten Fehler. t-Test, Korrelation, ANOVA und ANCOVA sind Spezialfälle davon, die sich nur in der Designmatrix unterscheiden.
- In der multiplen Regression sind die Gewichte partiell: Sie beschreiben den Zusammenhang unter statistischer Konstanthaltung der übrigen Prädiktoren. Das ist nicht dasselbe wie experimentelle Kontrolle, und welche Variablen ins Modell gehören, ist eine theoretische Frage.
- Im linearen Modell liefern die kleinsten Quadrate und die Maximum-Likelihood-Schätzung dieselben Gewichte. Die ML-Schätzung ist aber das allgemeinere Prinzip, auf dem fast alle Verfahren der folgenden Kapitel beruhen.
- Die inkrementelle Varianzaufklärung \(\Delta R^2\) beantwortet die Frage, was ein Prädiktor über andere hinaus beiträgt. Sie hängt von der Reihenfolge ab, sagt wenig über praktische Relevanz aus und wird durch Messfehler in den Kontrollvariablen systematisch überschätzt.
- Die wichtigsten Annahmen sind Validität, Linearität und Unabhängigkeit, nicht die Normalverteilung. Geprüft werden sie vor allem mit Abbildungen der Residuen.
- In R schätzt man lineare Modelle mit
lm()und der Formelschreibweise, vergleicht geschachtelte Modelle mitanova(), prüft Annahmen mitplot()oderperformance::check_model()und erstellt mitmodelsummary()publikationsreife Tabellen, ohne eine einzige Zahl abzutippen.
4.7.1 Vertiefung
Das mit Abstand beste moderne Lehrbuch zur Regression ist Regression and Other Stories von Gelman, Hill und Vehtari (2020). Es ist konsequent anwendungsorientiert, legt großen Wert auf Abbildungen und Simulationen und ist als PDF frei verfügbar. Der Klassiker für die Verhaltenswissenschaften ist das Buch von Cohen, Cohen, West und Aiken (2003), das insbesondere die hierarchische Regression, kategoriale Prädiktoren und Interaktionen sehr gründlich behandelt. Wer die mathematischen Grundlagen einschließlich der Matrixschreibweise vertiefen möchte, findet bei Fox (2016) eine gut lesbare Darstellung. Die Einsicht, dass die gängigen Tests lineare Modelle sind, hat Jonas Kristoffer Lindeløv (2019) in einer frei verfügbaren Übersicht mit R-Code für jeden einzelnen Test aufbereitet. Und wer mit modelsummary noch mehr machen möchte, findet auf der Website des Pakets (https://modelsummary.com) eine ausgezeichnete Dokumentation mit vielen Beispielen (Arel-Bundock, 2022).
4.7.2 Referenzen
There ain’t no such thing as a free lunch!↩︎