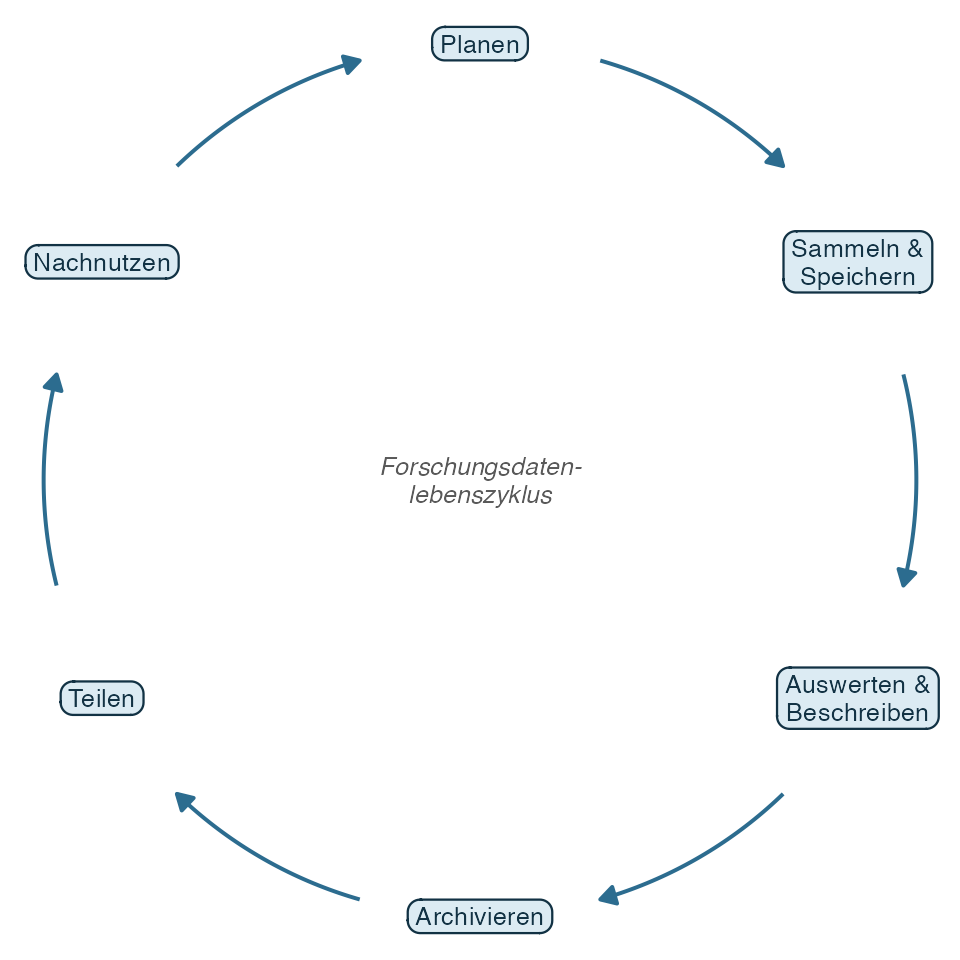
3 Datenmanagement
“If you torture the data long enough, it will confess to anything.” — zugeschrieben R. Coase
In diesem Kapitel lernen Sie, warum ein sorgfältiges und vor allem nachvollziehbares Datenmanagement über die Glaubwürdigkeit einer ganzen Studie entscheiden kann, welche konzeptuellen Prinzipien der Aufbereitung von Daten zugrunde liegen und wie Sie mit dem tidyverse sehr effizient von den Rohdaten zu einem analysefertigen Datensatz kommen. Wie im vorigen Kapitel ist die erste Hälfte bewusst konzeptuell: Sie soll Ihnen ein Gespür dafür geben, warum wir Daten so und nicht anders behandeln. Die zweite Hälfte ist praktisch und zeigt Schritt für Schritt, wie Sie in R aus einer Roh-Tabelle einen sauberen, dokumentierten Datensatz machen, mit dem man gut arbeiten kann.
Wie sehr die Weltwirtschaft an einer Excel-Formel hängen kann, zeigt eine der bekanntesten Episoden der jüngeren Wissenschaftsgeschichte. Die Ökonomen Carmen Reinhart und Kenneth Rogoff (2010) veröffentlichten 2010 ihre Studie Growth in a Time of Debt mit einer alarmierenden These: Übersteige die Staatsverschuldung eines Landes 90 % des Bruttoinlandsprodukts, breche das Wirtschaftswachstum abrupt ein. Sie hatten auch einen schmissigen Namen für diesen Effekt das „growth cliff”. Die Arbeit wurde zu einer der meistzitierten empirischen Grundlagen für die Austeritätspolitik nach der Finanzkrise von 2008.
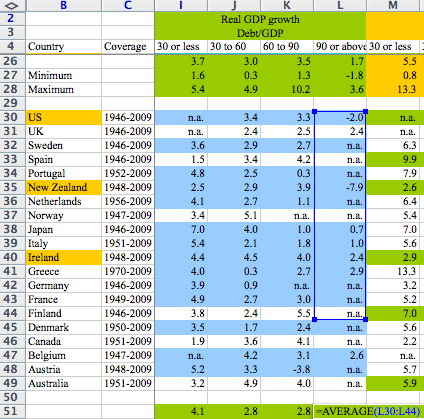
Als der Doktorand Thomas Herndon gemeinsam mit Michael Ash und Robert Pollin (2013) versuchte, die Ergebnisse zu replizieren, bekam er zunächst schlicht andere Zahlen. Erst der Zugang zur Original-Tabelle brachte drei Probleme ans Licht: Eine Excel-Formel hatte fünf Länder aus der Mittelwertsberechnung ausgeschlossen, weil der markierte Zellbereich nicht bis zum Ende reichte. Hinzu kamen eine ungewöhnliche Gewichtung der Länder und der selektive Ausschluss einzelner Jahre. Rechnet man diese drei Punkte heraus, steigt das mittlere Wachstum bei einer Verschuldung über 90 % von berichteten −0,1 % auf +2,2 % und der „cliff” verschwindet.
3.1 Folgen für das Datenmanagement
Die wichtigste Lehre, die man aus diesem Fall ziehen kann, ist dass jeder Fehler machen kann und wir es anderen möglichst leicht machen sollten, diese zu finden. Das bedeutet einerseits, dass man die Daten möglichst einfach und feri zugänglich machen sollte. Zweitens sollte man sein Vorgehen möglichst transparent dokumentieren. Also am besten keinen einzigen Schritte von Hand durchführen, sondern alle Schritte vom Einlesen über das Auswählen, Transformieren, und Umstrukturieren bis zur Erstellung von Abbildungen und Ergebnistabellen durchgängig zu dokumentieren. Im folgenden gehe ich auf beides kurz ein.
3.1.1 Daten und Code sollten nach FAIR geteilt werden
Warum sollte man Daten überhaupt mit anderen teilen? Der Fall Reinhart-Rogoff liefert das erste Argument gleich mit: Reproduzierbarkeit. Nur wenn andere Zugang zu den Daten haben, können sie Ergebnisse prüfen und Fehler finden. Das zweite Argument ist die Nachnutzung: Datenerhebung ist teuer, und viele Datensätze erlauben weit mehr als die eine Auswertung, für die sie erhoben wurden — Zweitanalysen und Meta-Analysen leben davon. Das dritte Argument ist Vertrauen: Offenheit wirkt als Korrektiv gegen ehrliche Fehler und, wie wir gleich sehen werden, auch gegen Betrug. Für die Veröffentlichung stehen fachübergreifende Repositorien wie OSF, Zenodo oder GESIS bereit.
Nach den FAIR Prinzipien sollen Daten __F__indable (auffindbar), __A__ccessible (zugänglich), __I__nteroperable (mit anderen Daten kombinierbar) und __R__eusable (nachnutzbar) sein (Wilkinson et al., 2016).
Um das zu erreichen, fordern mittlerweile viele Große Förderorganisationen wie die Deutsche Forschungsgemeinschaft (DFG) oder das EU-Rahmenprogramm Horizon Europe inzwischen sog. Datenmanagementpläne (DMP), in denen Sie schon vor der Erhebung festlegen, wie die Daten strukturiert, dokumentiert, gespeichert und später zugänglich gemacht werden. Im Prinzip entspricht das zum großen Teil schon dem Forschungsprozess in der Psychologie, nur mit einem stärkeren Fokus auf den Daten und deren Speicherung. Datenmanagementpläne helfen aber dabei den Prozess in Bezug auf die Daten zu strukturieren.
Ein sauberer Datensatz nützt wenig, wenn niemand weiß, was in ihm steht. Zu jeder Erhebung gehört daher eine Dokumentation, die üblicherweise aus mehreren Bausteinen besteht. Das Codebook (oder Datenwörterbuch) hält für jede Variable Namen, Bedeutung, zulässigen Wertebereich und die Kodierung fehlender Werte fest. Die Metadaten beschreiben den Entstehungskontext: wer wann womit erhoben hat. Und schließlich verlangt der Datenschutz, dass personenbezogene Daten vor jeder Weitergabe anonymisiert oder zumindest pseudonymisiert werden — in Europa ist das durch die Datenschutz-Grundverordnung (DSGVO) rechtlich verbindlich.
3.1.2 Transparente Dokumentation der Datenverarbeitungsschritte
Ein anderes Wichiges Prinzip, dass man befolgen sollte ist, dass die Rohdaten selbst unantastbar (read-only) sind, und jede Transformation passiert im Skript und nie per Hand. Der Unterschied ist fundamental. Wer sich in einer Tabellenkalkulation durch die Daten klickt, sortiert, einzelne Zeilen löscht und Werte überschreibt, gelangt vielleicht zu einem Ergebnis, kann aber niemandem und auch nicht sich selbst ein Jahr später genau erklären, wie er dorthin gekommen ist. Wer stattdessen jeden Schritt als Code notiert, erhält ein Protokoll, das die Analyse vollständig und exakt beschreibt:
- Von Hand: Rohdaten → klicken, sortieren, löschen → Ergebnis. Nicht nachvollziehbar.
- Im Skript: Rohdaten → dokumentierter Code → Ergebnis. Reproduzierbar.
3.2 Tidy Data
“Tidy datasets are all alike, but every messy dataset is messy in its own way.” — Hadley Wickham (2014)
Wenn jede Transformation im Skript passieren soll, brauchen die Daten eine Struktur, mit der ein Programm zuverlässig arbeiten kann. Hadley Wickham (2014) hat diese Struktur unter dem Begriff Tidy Data auf drei einfache Regeln gebracht:
- Eine Variable steht in genau einer Spalte.
- Eine Beobachtung steht in genau einer Zeile.
- Eine Beobachtungseinheit bildet genau eine Tabelle.
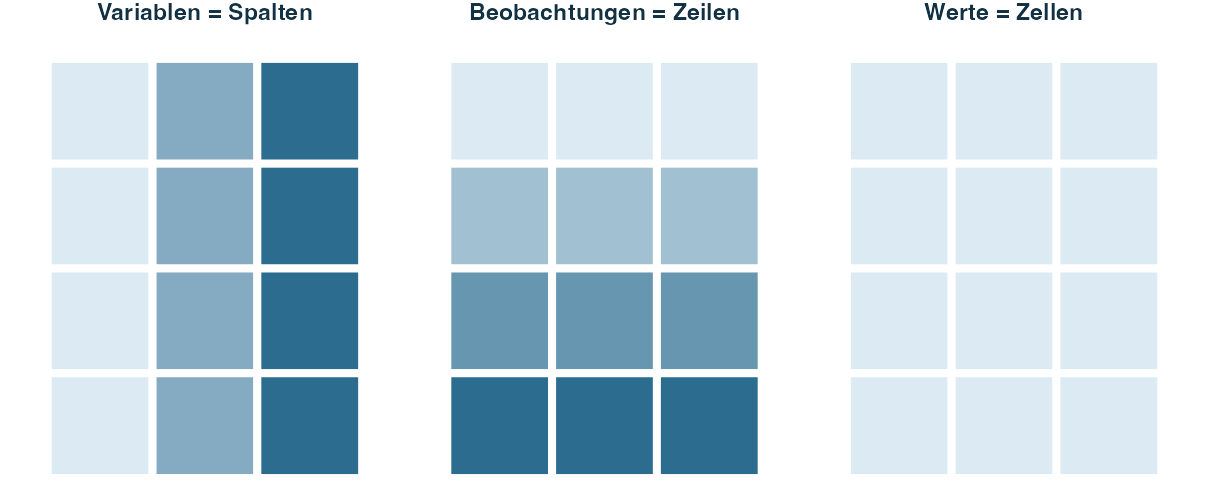
So selbstverständlich das klingt, so oft ist es in realen Datensätzen verletzt — etwa wenn mehrere Messzeitpunkte in nebeneinanderstehenden Spalten liegen oder eine Zelle gleich zwei Informationen enthält. Tidy Data ist die Struktur, in der (fast) alle Analysen und Grafiken in R erwartet werden; das tidyverse verdankt ihr sogar seinen Namen. Einen Datensatz „tidy” zu machen, ist deshalb häufig der erste Schritt jeder Aufbereitung.
Eng damit verbunden ist die Unterscheidung zwischen wide- und long-Format. Dieselben Daten lassen sich einmal breit (jeder Messzeitpunkt eine eigene Spalte) und einmal lang (eine Zeile pro Messung) darstellen. Der Wechsel zwischen beiden Formaten mit pivot_longer() und pivot_wider() gehört zu den häufigsten Aufgaben im Datenmanagement überhaupt — wir kommen im praktischen Teil ausführlich darauf zurück.
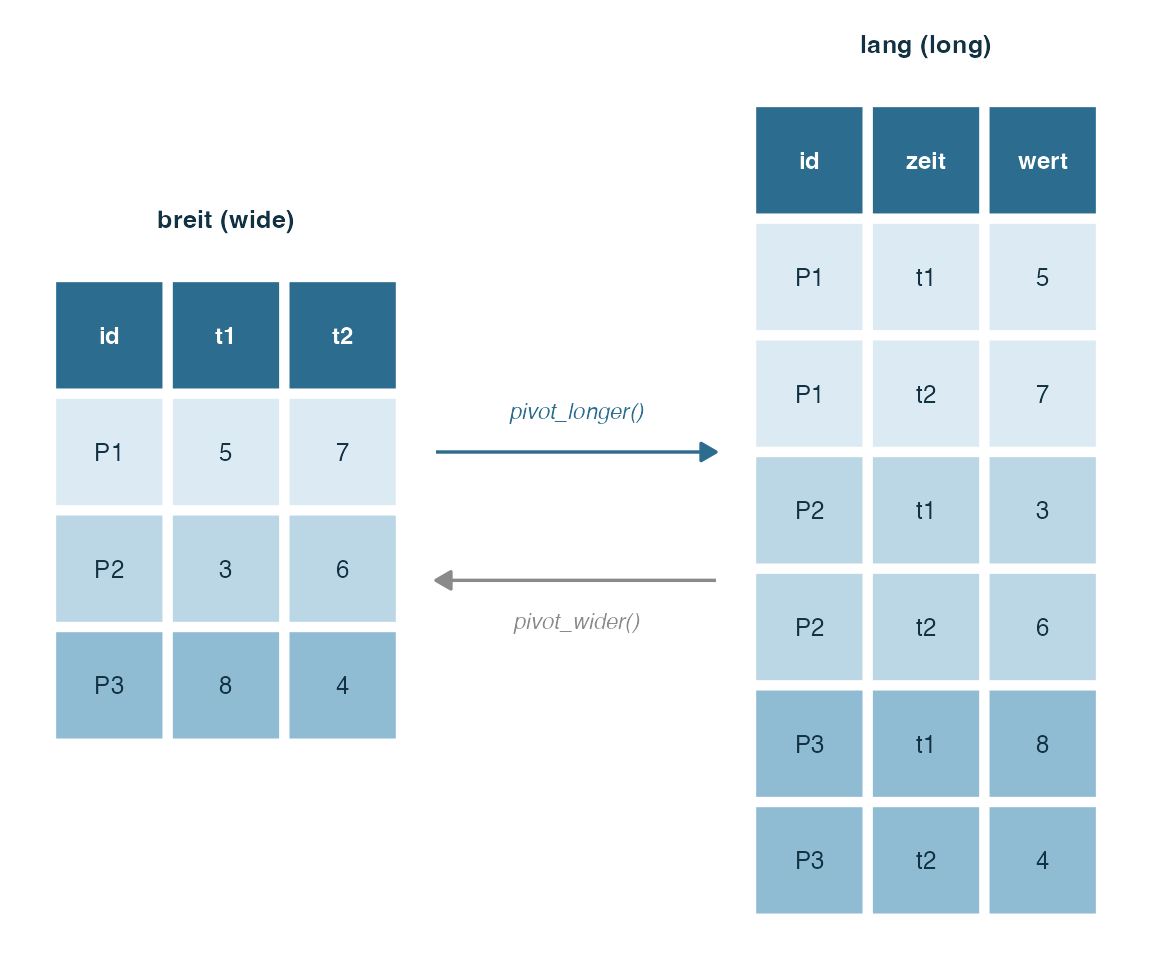
pivot_longer() macht aus den Messzeitpunkt-Spalten Zeilen, pivot_wider() kehrt das um. Die Farbe markiert die Zugehörigkeit zur selben Person.
3.3 Datenqualität und auffällige Daten
Ein großer Teil der praktischen Arbeit besteht darin, die Qualität der erhobenen Daten zu beurteilen und mit auffälligen Beobachtungen umzugehen. Dabei ist es hilfreich, sich klarzumachen, dass „auffällig” nicht gleich „auffällig” ist. Man kann sich ein Spektrum vorstellen, das von zufällig-harmlosen bis zu absichtlich-manipulierten Werten reicht: vom schlichten Messfehler oder Ausreißer über unaufmerksames Antworten bis hin zur bewussten Fabrikation. Das Tückische daran: Die Werkzeuge, mit denen man diese Fälle aufspürt, ähneln sich über das ganze Spektrum hinweg — die Konsequenzen für die Beteiligten könnten aber kaum unterschiedlicher sein.
3.3.1 Unaufmerksames Antworten
Gerade in Online-Befragungen gibt es regelmäßig Teilnehmende, die den Fragebogen nicht ernsthaft bearbeiten, sondern nur durchklicken. Die Forschung zum careless responding (Curran, 2016; Meade & Craig, 2012) hat dafür einen ganzen Werkzeugkasten entwickelt, der weit über die naheliegenden Reaktionszeiten hinausgeht:
- Attention Checks (Instructed Manipulation Checks, IMC): Items, die eine bestimmte Antwort vorschreiben („Bitte kreuzen Sie hier stimme voll zu an”).
- Longstring / Straightlining: lange Serien identischer Antworten, wenn jemand stur dieselbe Kategorie ankreuzt.
- Reaktionszeiten: Antworten, die schlicht zu schnell kommen, um den Text überhaupt gelesen zu haben.
- Mahalanobis-Distanz: multivariate Ausreißer, deren Antwortmuster als Ganzes ungewöhnlich weit vom Rest entfernt liegt.
- Konsistenzindizes: etwa über psychometrische Antonyme, also inhaltlich gegenläufige Items, die konsistent beantwortet werden sollten.
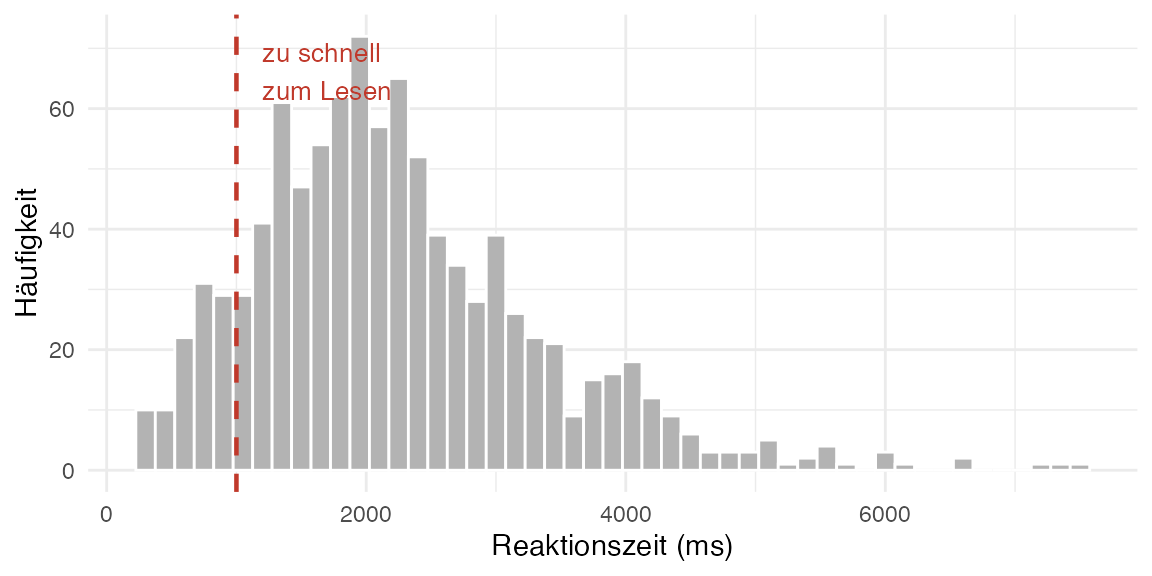
Ein Blick auf die Verteilung der Reaktionszeiten (Abbildung 3.4) macht das Prinzip anschaulich. Der Hauptteil der Antworten bildet eine breite, rechtsschiefe Verteilung mit einem Gipfel bei realistischen Bearbeitungszeiten. Links davon, deutlich abgesetzt, sammelt sich eine kleine Gruppe extrem kurzer Zeiten — zu schnell, um die Frage gelesen zu haben.
3.3.2 Fehlende Werte
Ein Sonderfall auffälliger Daten sind Werte, die gar nicht erst vorhanden sind. Für den Umgang mit fehlenden Werten ist entscheidend, warum sie fehlen. Man unterscheidet üblicherweise drei Mechanismen:
- MCAR (missing completely at random): rein zufällig fehlend, unabhängig von allem anderen.
- MAR (missing at random): fehlend in Abhängigkeit von beobachteten Variablen (z. B. antworten jüngere Personen seltener auf eine bestimmte Frage).
- MNAR (missing not at random): fehlend in Abhängigkeit vom fehlenden Wert selbst (z. B. verschweigen gerade Personen mit sehr hohem Einkommen ihr Einkommen).
Beim Umgang gilt: Das einfache Löschen betroffener Fälle (listwise oder pairwise deletion) ist nur unter MCAR unproblematisch; andernfalls verzerrt es die Ergebnisse. Anspruchsvollere Verfahren wie die multiple Imputation schätzen die fehlenden Werte aus den übrigen. In jedem Fall aber gilt eine Grundregel: Das Muster der fehlenden Werte gehört berichtet.
3.3.3 Die Kehrseite der vielen Schritte
Bis hierhin klang das Aufspüren und Ausschließen auffälliger Daten wie reine Datenhygiene. Es hat jedoch eine gefährliche Kehrseite. Genau dieselben Werkzeuge, mit denen man Daten sauber macht, lassen sich nutzen, um Ergebnisse in die gewünschte Richtung zu verzerren. Ein Ausschlusskriterium, das man erst nach dem Blick auf die Ergebnisse wählt — „ohne diese drei Ausreißer wird der Effekt signifikant” —, ist ein sogenannter researcher degree of freedom (Simmons et al., 2011).
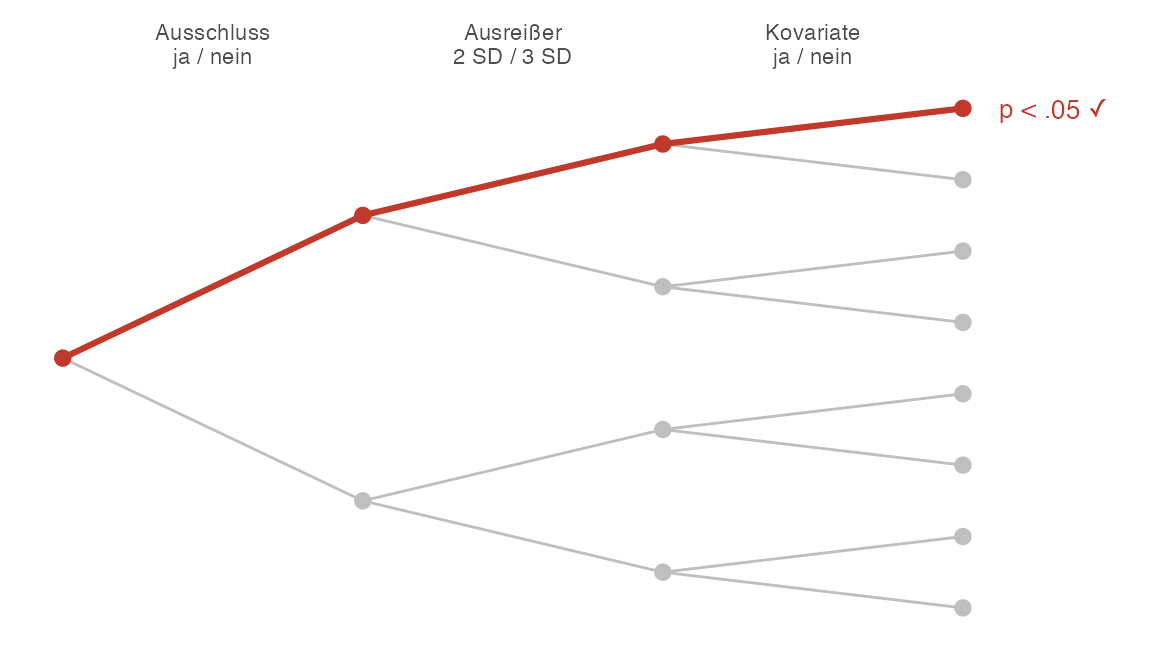
Das Problem verschärft sich, weil es selten nur eine solche Entscheidung gibt. Schließt man Ausreißer bei 2 oder bei 3 Standardabweichungen aus? Nimmt man eine Kovariate mit auf oder nicht? Jede dieser plausiblen Weggabelungen führt zu einer etwas anderen Analyse. Andrew Gelman und Eric Loken (2014) haben dafür das Bild vom „garden of forking paths” geprägt (Abbildung 3.5): Wer aus vielen gleichermaßen vertretbaren Analysepfaden im Nachhinein den auswählt, der ein signifikantes Ergebnis liefert, findet fast garantiert irgendeinen — auch dann, wenn in der Grundgesamtheit gar kein Effekt existiert.
Warnung
Der Ausweg besteht nicht darin, keine Ausreißer mehr auszuschließen, sondern darin, die Entscheidungen vorab festzulegen. Konkret heißt das: Ausschluss- und Aufbereitungsregeln präregistrieren (Nosek et al., 2018), bevor man die Ergebnisse kennt. Wo das nicht möglich ist, sollte man die Robustheit zeigen und das Ergebnis mit und ohne Ausschluss berichten (sensitivity- oder multiverse-Analyse). Kurz: Transparenz schlägt Perfektion.
3.3.4 Extremfall: Datenforensik
Am äußersten Ende des Spektrums steht die absichtliche Fabrikation von Daten. Die beiden Fälle, mit denen wir dieses Kapitel gerahmt haben, markieren die Extreme: Reinhart-Rogoff war ein ehrlicher Fehler, sichtbar geworden durch geteilte Daten. Fabrikation ist eine bewusste Manipulation — die interessanterweise durch genau dieselbe Offenheit aufgedeckt wird.
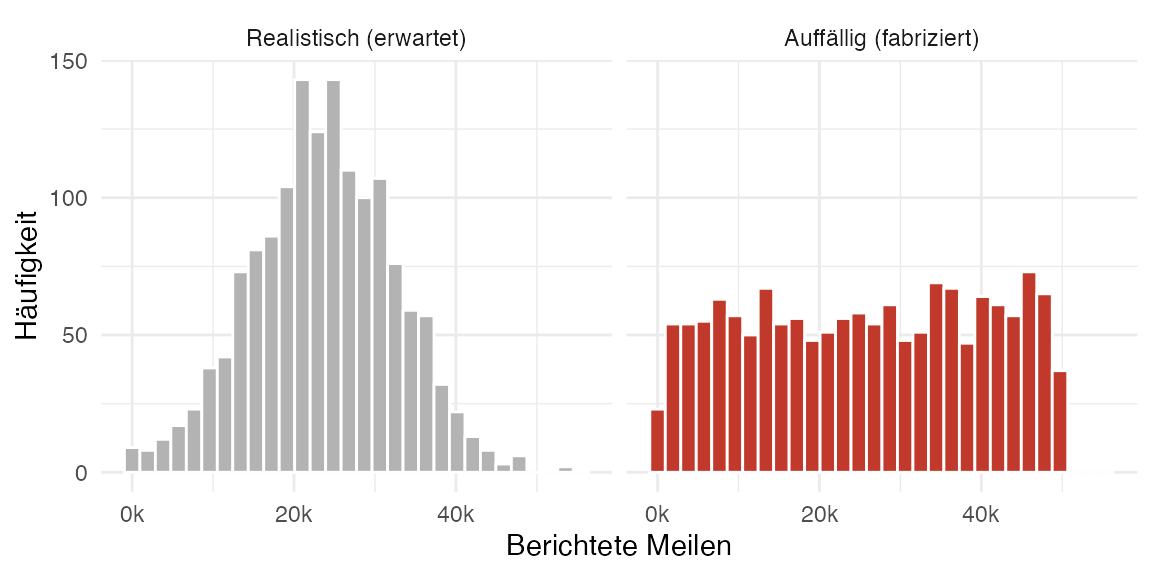
Ein vieldiskutiertes Beispiel ist ironischerweise ein Fall um eine Studie zu Ehrlichkeit aus dem Jahr (2012), die auf Versicherungsdaten beruhte. Forscher, die das Blog Data Colada betreiben, berichteten 2021, dass Sie in einem zugehörigen Datensatz sich ein verräterisches Muster zeigte: Ein Teil der Datensätze war offenbar dupliziert und die Kopien mit kleinen Zufallszahlen (1 bis 1000) minimal verändert worden. Der Originalteil war in der Schriftart Calibri gesetzt, die Kopie in Cambria. Und die in der Abbildung berichteten gefahrenen Meilen waren annähernd gleichverteilt statt, wie man es erwarten würde, glockenförmig — als hätte ein Zufallsgenerator sie erzeugt (Abbildung 3.6).
Aus solchen Fällen ist ein kleines Instrumentarium der Datenforensik entstanden. Der GRIM-Test (Brown & Heathers, 2016) etwa prüft, ob ein berichteter Mittelwert bei ganzzahligen Daten und gegebener Stichprobengröße überhaupt möglich ist. Benford’s Law macht Aussagen über die zu erwartende Verteilung der führenden Ziffern in vielen natürlichen Datensätzen. Und oft sind es die einfachsten Auffälligkeiten — Duplikate, Metadaten, die Form der Verteilung —, die als Erstes stutzig machen. All diese Werkzeuge haben jedoch eine gemeinsame, unabdingbare Voraussetzung: den Zugang zu den Rohdaten. Damit schließt sich der Kreis zum Anfang des Kapitels.
3.4 Datenmanagement mit R
Nachdem geklärt ist, warum jeder Aufbereitungsschritt dokumentiert und reproduzierbar sein sollte, geht es nun darum, wie das praktisch funktioniert. Wir arbeiten dazu durchgängig mit dem tidyverse, einer Sammlung von R-Paketen, die genau für diese Aufgaben gemacht ist. Bevor wir die einzelnen Schritte durchgehen, klären wir drei Dinge, die Sie in jedem Schritt brauchen: den Ablauf, das Grundmuster der Funktionen und die Pipe.
3.4.1 Beispieldatensätze
Wir werden beispielhaft wieder mit dem Datensatz zu den Pinguinen der Palmer-Station in der Antarktis arbteiten, den Sie aus dem vorigen Kapitel kennen. Diesmal beginnen wir aber nicht mit der aufgeräumten Version penguins, sondern mit den Rohdaten penguins_raw, so wie sie im Feld erhoben wurden: mit unhandlichen Spaltennamen, zusätzlichen Variablen, Kommentaren und fehlenden Werten. Aus diesen Rohdaten bauen wir Schritt für Schritt einen analysefertigen Datensatz.
Die Rohdaten penguins_raw enthalten 344 Tiere und 17 Variablen, darunter Körpermaße, Isotopenwerte aus Blutproben, das Datum der Eiablage und Kommentare der Forschenden.
library(tidyverse)
library(palmerpenguins)
3.4.2 Übersicht über den Ablauf
Rohdaten sind read-only. Jede Veränderung entsteht als neues Objekt im Skript.
Der Weg von den Rohdaten zum analysefertigen Datensatz folgt fast immer demselben Muster. Ausgangspunkt sind die Rohdaten, die wir grundsätzlich als read-only behandeln. Von dort geht es über eine Kette klar benennbarer Schritte, die auch die Gliederung dieses Abschnitts bilden:
%%{init: {'flowchart': {'curve': 'basis'}}}%%

flowchart LR
    roh[("Rohdaten<br>(read-only)")]
    subgraph vorbereiten [Vorbereiten]
        direction LR
        einlesen["<b>Einlesen</b><br>read_csv()<br>read_excel()<br>read_sav()"]
        sichten["<b>Sichten</b><br>glimpse()<br>summary()<br>count()"]
    end
    subgraph aufbereiten [Aufbereiten]
        direction LR
        filtern["<b>Filtern</b><br>filter()<br>distinct()"]
        auswaehlen["<b>Auswählen</b><br>select()<br>rename()"]
        verknuepfen["<b>Verknüpfen</b><br>left_join()<br>anti_join()"]
        berechnen["<b>Berechnen</b><br>mutate()<br>case_when()"]
    end
    subgraph auswerten [Auswerten]
        direction LR
        zusammen["<b>Zusammenfassen</b><br>summarise()<br>pivot_longer()<br>arrange()"]
    end
    fertig["Analysefertiger<br>Datensatz"]

    roh --> einlesen --> sichten --> filtern --> auswaehlen --> verknuepfen --> berechnen --> zusammen --> fertig
    berechnen -.->|"prüfen: nrow(), count()"| sichten

    classDef box fill:#DCEBF3,stroke:#2C6C8F,color:#123244;
    class roh,einlesen,sichten,filtern,auswaehlen,verknuepfen,berechnen,zusammen,fertig box
    style vorbereiten fill:#F5FAFD,stroke:#9FB8C6,stroke-dasharray:4 4
    style aufbereiten fill:#F5FAFD,stroke:#9FB8C6,stroke-dasharray:4 4
    style auswerten fill:#F5FAFD,stroke:#9FB8C6,stroke-dasharray:4 4

    linkStyle default stroke:#000000,stroke-width:1.5px,fill:none
    linkStyle 8 stroke:#8a8a8a,stroke-width:1.3px
Die Reihenfolge der Schritte wird bei den meisten Analysen recht viel Sinn ergeben Wer zuerst filtert und auswählt, arbeitet in allen folgenden Schritten mit einem kleineren, übersichtlicheren Datensatz. Wer vor dem Berechnen verknüpft, hat alle Variablen beisammen, die er für neue Variablen braucht. Und das Zusammenfassen steht am Ende, weil dabei Information verloren geht: Aus vielen Zeilen wird eine Kennzahl. Es kann aber sein, dass man diese Schritte in einer anderen Reihenfolge leichter umsetzten kann. Entscheidend ist in jedem Fall, dass jeder dieser Schritte im Skript steht und nichts von Hand geändert wird.
3.4.3 Pipes
|> liest man als „und dann”. Tastenkürzel in RStudio: Strg + Shift + M (Mac: Cmd + Shift + M).
Das Bindeglied dieser Ketten ist die Pipe |>. Sie liest sich schlicht als „und dann” und übergibt das Ergebnis der linken Seite als erstes Argument an die Funktion rechts. Statt Funktionsaufrufe ineinander zu verschachteln, was man von innen nach außen lesen muss, entsteht so eine Folge von Schritten, die man von oben nach unten liest. Dieselbe Auswertung einmal verschachtelt und einmal mit Pipe:
# verschachtelt: von innen nach außen zu lesen
summarise(
  group_by(
    filter(penguins, !is.na(body_mass_g)),
    species),
  m = mean(body_mass_g))

# mit Pipe: von oben nach unten zu lesen
penguins |>
  filter(!is.na(body_mass_g)) |>
  group_by(species) |>
  summarise(m = mean(body_mass_g))
Beide Varianten erzeugen exakt dasselbe Ergebnis, die zweite ist aber ungleich leichter zu lesen und zu erweitern. In RStudio fügt das Tastenkürzel Strg + Shift + M eine Pipe ein. In älteren Skripten und Foren begegnet Ihnen häufig noch die Pipe %>% aus dem Paket magrittr; für unsere Zwecke funktioniert sie genauso.
3.5 Die einzelnen Schritte des Datenmanagements mit R
Grundmuster aller Verben: verb(daten, was_getan_wird). Rein kommt ein Datensatz, raus kommt ein Datensatz.
Der Kern der Aufbereitung im tidyverse sind einige wenige Funktionen, die man sich am besten als Verben merkt. Jedes tut genau eine Sache:
read_csv()und Verwandte: Daten einlesenglimpse(),summary(),count(): Daten sichtenfilter(): Zeilen auswählenselect(): Spalten auswählen*_join(): Tabellen verknüpfenmutate(): Variablen berechnensummarise()undarrange(): zusammenfassen und sortieren
Die Verben zur Bearbeitung folgen alle demselben Muster: verb(daten, was_getan_wird). Das erste Argument ist immer der Datensatz, der Rückgabewert ist wieder ein Datensatz, und der Originaldatensatz bleibt dabei stets unverändert. Wer eine Änderung behalten möchte, muss das Ergebnis mit <- einem Objekt zuweisen, am besten einem neuen. Diese Einheitlichkeit ist das Konstruktionsprinzip des tidyverse und der Grund, warum sich die Verben so mühelos zu Ketten verbinden lassen.
3.5.1 Einlesen
Am Anfang jeder Auswertung steht das Einlesen der Daten in R. Für die gängigen Dateiformate gibt es jeweils eine passende Funktion:
read_csv()(Paketreadr, Teil destidyverse) für kommagetrennte Textdateien; für deutsche CSV-Dateien mit Semikolon als Trennzeichen und Komma als Dezimalzeichen gibt esread_csv2().read_excel()(Paketreadxl) für Excel-Dateien, mit dem Argumentsheetfür das gewünschte Tabellenblatt.read_sav()(Pakethaven) für SPSS-Dateien, wie sie viele Befragungsplattformen exportieren. Dabei bleiben die Wertelabels erhalten.
Das Paket palmerpenguins liefert die Rohdaten auch als CSV-Datei mit. Mit path_to_file() erhalten wir den Pfad zu dieser Datei und können sie so einlesen, wie Sie später Ihre eigenen Daten einlesen werden:
pinguine_roh <- read_csv(path_to_file("penguins_raw.csv"),
                         show_col_types = FALSE)
Relative Pfade beziehen sich auf den Projektordner und funktionieren deshalb auf jedem Rechner. Absolute Pfade wie C:/Users/... funktionieren nur auf Ihrem.
Zwei Gewohnheiten ersparen Ihnen beim Einlesen viel Ärger. Erstens: Arbeiten Sie in einem RStudio-Projekt und geben Sie Pfade relativ zum Projektordner an, also read_csv("daten/roh/befragung.csv") statt read_csv("C:/Users/.../befragung.csv"). Dann läuft das Skript auch auf dem Rechner einer Kollegin. Zweitens: Legen Sie die Rohdaten in einen eigenen Ordner, den Sie nie beschreiben. Alles, was Ihr Skript erzeugt, speichern Sie woanders, etwa mit write_csv(daten, "daten/aufbereitet/pinguine.csv").
Hinweis
Beim Einlesen rät read_csv() anhand der ersten Zeilen, welchen Datentyp jede Spalte hat. Das geht meistens gut, aber nicht immer: Steht in einer Zahlenspalte irgendwo ein Text wie "k.A." oder ".", wird die ganze Spalte als Text eingelesen. Deshalb folgt auf das Einlesen immer das Sichten.
3.5.2 Sichten
Direkt nach dem Einlesen, sollte man sich einen einen Überblick verschaffen. Die wichtigste Funktion dafür ist glimpse(). Sie zeigt die Zahl der Zeilen und Spalten sowie für jede Spalte den Datentyp und die ersten Werte:
glimpse(pinguine_roh)Rows: 344
Columns: 17
$ studyName <chr> "PAL0708", "PAL0708", "PAL0708", "PAL0708", "PAL…
$ `Sample Number` <dbl> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 1…
$ Species <chr> "Adelie Penguin (Pygoscelis adeliae)", "Adelie P…
$ Region <chr> "Anvers", "Anvers", "Anvers", "Anvers", "Anvers"…
$ Island <chr> "Torgersen", "Torgersen", "Torgersen", "Torgerse…
$ Stage <chr> "Adult, 1 Egg Stage", "Adult, 1 Egg Stage", "Adu…
$ `Individual ID` <chr> "N1A1", "N1A2", "N2A1", "N2A2", "N3A1", "N3A2", …
$ `Clutch Completion` <chr> "Yes", "Yes", "Yes", "Yes", "Yes", "Yes", "No", …
$ `Date Egg` <date> 2007-11-11, 2007-11-11, 2007-11-16, 2007-11-16,…
$ `Culmen Length (mm)` <dbl> 39.1, 39.5, 40.3, NA, 36.7, 39.3, 38.9, 39.2, 34…
$ `Culmen Depth (mm)` <dbl> 18.7, 17.4, 18.0, NA, 19.3, 20.6, 17.8, 19.6, 18…
$ `Flipper Length (mm)` <dbl> 181, 186, 195, NA, 193, 190, 181, 195, 193, 190,…
$ `Body Mass (g)` <dbl> 3750, 3800, 3250, NA, 3450, 3650, 3625, 4675, 34…
$ Sex <chr> "MALE", "FEMALE", "FEMALE", NA, "FEMALE", "MALE"…
$ `Delta 15 N (o/oo)` <dbl> NA, 8.95, 8.37, NA, 8.77, 8.66, 9.19, 9.46, NA, …
$ `Delta 13 C (o/oo)` <dbl> NA, -24.7, -25.3, NA, -25.3, -25.3, -25.2, -24.9…
$ Comments <chr> "Not enough blood for isotopes.", NA, NA, "Adult…Schon dieser Blick verrät einiges. Der Datensatz hat mehr Spalten als die aufgeräumte Version, darunter Isotopenwerte aus Blutproben und eine Spalte mit Kommentaren. Die Spaltennamen enthalten Leerzeichen und Klammern, etwa Body Mass (g). Solche Namen muss man in R in Backticks setzen (`Body Mass (g)`), was schnell mühsam wird; wir ändern das im Schritt Auswählen. Und statt „bill” für den Schnabel steht hier „Culmen”, der Fachbegriff für den Schnabelfirst.
dbl steht für Kommazahlen, chr für Text, date für Datumsangaben. Steht bei einer Zahlenvariable chr, stimmt beim Einlesen etwas nicht.
Mit summary() erhält man für jede Spalte die wichtigsten Kennwerte. Nebenbei macht die Zeile NA's sichtbar, in welchen Variablen wie viele Werte fehlen:
pinguine_roh |>
  select(`Body Mass (g)`, `Flipper Length (mm)`, `Delta 15 N (o/oo)`) |>
  summary()
Body Mass (g) Flipper Length (mm) Delta 15 N (o/oo)
Min. :2700 Min. :172 Min. : 7.63
1st Qu.:3550 1st Qu.:190 1st Qu.: 8.30
Median :4050 Median :197 Median : 8.65
Mean :4202 Mean :201 Mean : 8.73
3rd Qu.:4750 3rd Qu.:213 3rd Qu.: 9.17
Max. :6300 Max. :231 Max. :10.03
NAs :2 NAs :2 NAs :14 Für kategoriale Variablen ist count() das Mittel der Wahl. Die Funktion zählt, wie oft jede Ausprägung vorkommt, und deckt dabei unerwartete Kodierungen, Tippfehler und fehlende Werte auf:
count(pinguine_roh, Species)# A tibble: 3 × 2
Species n
<chr> <int>
1 Adelie Penguin (Pygoscelis adeliae) 152
2 Chinstrap penguin (Pygoscelis antarctica) 68
3 Gentoo penguin (Pygoscelis papua) 124count(pinguine_roh, Sex)# A tibble: 3 × 2
Sex n
<chr> <int>
1 FEMALE 165
2 MALE 168
3 <NA> 11Besonders aufschlussreich sind oft Freitextspalten wie die Kommentare. Hier haben die Forschenden notiert, wenn bei einem Tier etwas Besonderes vorfiel, zum Beispiel zu wenig Blut für die Isotopenanalyse. Solche Hinweise sind ein Stück Dokumentation, das bei der Entscheidung über Ausschlüsse hilft:
count(pinguine_roh, Comments, sort = TRUE)# A tibble: 11 × 2
Comments n
<chr> <int>
1 <NA> 290
2 Nest never observed with full clutch. 34
3 Not enough blood for isotopes. 7
4 Sexing primers did not amplify. 4
5 No blood sample obtained for sexing. 2
6 No blood sample obtained. 2
7 Adult not sampled. 1
8 Adult not sampled. Nest never observed with full clutch. 1
9 Nest never observed with full clutch. Not enough blood for isotopes. 1
10 No delta15N data received from lab. 1
11 Sexing primers did not amplify. Not enough blood for isotopes. 1Zum freien Stöbern öffnet View(pinguine_roh) (großgeschrieben!) den Datensatz als sortier- und filterbare Tabelle in RStudio.
Hinweis
View() ist ausschließlich zum Anschauen gedacht. Was Sie in dieser Tabellenansicht sortieren oder filtern, verändert die Daten nicht und wird auch nicht dokumentiert. Jede echte Änderung gehört ins Skript.
3.5.3 Filtern
filter() behält genau die Zeilen, für die eine Bedingung TRUE ergibt. Als Bausteine dienen die Vergleichsoperatoren (==, !=, <, >, <=, >=) und die logischen Verknüpfungen & (und), | (oder) sowie ! (nicht). Mehrere durch Komma getrennte Bedingungen werden automatisch mit und verknüpft. Mit %in% prüft man, ob ein Wert in einer Liste zulässiger Werte vorkommt:
pinguine_roh |>
  filter(Island %in% c("Biscoe", "Dream"), `Body Mass (g)` > 4000) |>
  nrow()
[1] 161Mit | lassen sich Bedingungen mit oder verknüpfen. Gesucht sind alle Tiere, die auf der Insel Torgersen leben oder eine Flosse von mehr als 220 mm haben:
pinguine_roh |>
  filter(Island == "Torgersen" | `Flipper Length (mm)` > 220) |>
  count(Island)
# A tibble: 2 × 2
Island n
<chr> <int>
1 Biscoe 35
2 Torgersen 52Zwei Stolperfallen sind so häufig, dass man sie kennen sollte. Erstens heißt der Vergleich ==, nicht =; das einfache Gleichheitszeichen führt zu einer Fehlermeldung. Zweitens, und tückischer: Ein fehlender Wert (NA) ist bei keinem Vergleich TRUE. Zeilen mit fehlenden Werten fallen bei einem Filter also stillschweigend heraus. Bei einigen Pinguinen konnte das Geschlecht nicht bestimmt werden. Filtert man nach weiblichen und nach männlichen Tieren, ergeben beide zusammen nicht die Gesamtzahl:
nrow(pinguine_roh)[1] 344pinguine_roh |> filter(Sex == "FEMALE") |> nrow()[1] 165pinguine_roh |> filter(Sex == "MALE") |> nrow()[1] 168pinguine_roh |> filter(is.na(Sex)) |> nrow()[1] 11Wer fehlende Werte gezielt ansprechen will, nutzt deshalb is.na() bzw. !is.na().
NA == irgendwas ist nie TRUE. Deshalb verschwinden Zeilen mit fehlenden Werten bei jedem Filter stillschweigend.
Ausgeschlossene Fälle gehören in den Methodenteil: Wie viele, und nach welchem vorab festgelegten Kriterium?
Weil filter() das zentrale Werkzeug für den Ausschluss von Fällen ist, gelten hier die Prinzipien aus dem konzeptuellen Teil ganz unmittelbar: Das Kriterium sollte vorab feststehen, das Ergebnis kommt in ein neues Objekt, und die Zahl der ausgeschlossenen Fälle gehört berichtet. In unserem Beispiel schließen wir Tiere aus, bei denen keine Körpermaße vorliegen:
pinguine <- pinguine_roh |>
  filter(!is.na(`Body Mass (g)`))

nrow(pinguine_roh) - nrow(pinguine)   # Anzahl ausgeschlossener Fälle
[1] 2Ein Sonderfall des Filterns ist das Entfernen von Duplikaten. distinct() behält von mehreren identischen Zeilen nur eine. Gerade wenn Daten aus mehreren Exporten zusammengesetzt wurden, lohnt vorher ein Blick darauf, ob es Duplikate gibt, denn wie der Fall der Versicherungsdaten gezeigt hat, können sie auch ein Warnsignal sein.
3.5.4 Auswählen
Was filter() für Zeilen ist, ist select() für Spalten. Man kann Spalten namentlich nennen, einzelne mit einem Minus ausschließen oder ganze Bereiche mit einem Doppelpunkt angeben. Besonders praktisch ist, dass select() Spalten gleichzeitig umbenennen kann: Links vom = steht der neue, rechts der alte Name. So lösen wir im selben Schritt das Problem der unhandlichen Namen:
pinguine <- pinguine |>
  select(
    studie      = studyName,
    nr          = `Sample Number`,
    art_lang    = Species,
    insel       = Island,
    schnabel_mm = `Culmen Length (mm)`,
    flosse_mm   = `Flipper Length (mm)`,
    masse_g     = `Body Mass (g)`,
    geschlecht  = Sex,
    d15n        = `Delta 15 N (o/oo)`
  )

glimpse(pinguine)
Rows: 342
Columns: 9
$ studie <chr> "PAL0708", "PAL0708", "PAL0708", "PAL0708", "PAL0708", "PA…
$ nr <dbl> 1, 2, 3, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18…
$ art_lang <chr> "Adelie Penguin (Pygoscelis adeliae)", "Adelie Penguin (Py…
$ insel <chr> "Torgersen", "Torgersen", "Torgersen", "Torgersen", "Torge…
$ schnabel_mm <dbl> 39.1, 39.5, 40.3, 36.7, 39.3, 38.9, 39.2, 34.1, 42.0, 37.8…
$ flosse_mm <dbl> 181, 186, 195, 193, 190, 181, 195, 193, 190, 186, 180, 182…
$ masse_g <dbl> 3750, 3800, 3250, 3450, 3650, 3625, 4675, 3475, 4250, 3300…
$ geschlecht <chr> "MALE", "FEMALE", "FEMALE", "FEMALE", "MALE", "FEMALE", "M…
$ d15n <dbl> NA, 8.95, 8.37, 8.77, 8.66, 9.19, 9.46, NA, 9.13, 8.63, NA…Links vom = steht immer der neue Name, rechts der alte. Das gilt für select(), rename() und mutate().
Gute Variablennamen sind kurz, sprechend, klein geschrieben und enthalten keine Leerzeichen oder Sonderzeichen; die Einheit im Namen (_mm, _g) erspart spätere Rückfragen. Will man nur umbenennen und alle Spalten behalten, nimmt man rename() mit derselben Schreibweise.
Bei Datensätzen mit vielen ähnlich benannten Spalten, etwa Fragebögen mit durchnummerierten Items, sparen die Hilfsfunktionen viel Tipparbeit: starts_with(), ends_with(), contains() und where() wählen Spalten nach einem Muster oder einem Datentyp aus. In den Pinguin-Rohdaten beginnen etwa beide Isotopenwerte mit Delta, und alle Längenmaße enthalten die Einheit (mm):
pinguine_roh |>
  select(starts_with("Delta")) |>
  names()
[1] "Delta 15 N (o/oo)" "Delta 13 C (o/oo)"pinguine_roh |>
select(contains("(mm)")) |>
names()[1] "Culmen Length (mm)" "Culmen Depth (mm)" "Flipper Length (mm)"pinguine_roh |>
select(where(is.numeric)) |>
names()[1] "Sample Number" "Culmen Length (mm)" "Culmen Depth (mm)"
[4] "Flipper Length (mm)" "Body Mass (g)" "Delta 15 N (o/oo)"
[7] "Delta 13 C (o/oo)" Mit dem Minus lassen sich Spalten entfernen, die man nicht braucht. Die Spalten Region und Stage haben in den Rohdaten zum Beispiel für alle Tiere denselben Wert und tragen deshalb keine Information:
pinguine_roh |>
  select(-c(Region, Stage)) |>
  ncol()
[1] 153.5.5 Verknüpfen
In der Praxis liegen die Daten fast nie in einer einzigen Tabelle. Fragebogendaten, Reaktionszeiten, demografische Angaben und Laborwerte kommen aus verschiedenen Quellen und müssen zusammengeführt werden. Verknüpft wird über einen Schlüssel (key), also eine Spalte, die in beiden Tabellen vorkommt und dieselbe Beobachtungseinheit bezeichnet, typischerweise eine Personen-ID.
Als Beispiel nehmen wir an, eine Kollegin hat uns eine kleine Tabelle mit den deutschen Namen der drei Pinguinarten geschickt, die wir für Abbildungen verwenden wollen. In ihrer Tabelle heißen die Arten schlicht "Adelie", "Chinstrap" und "Gentoo":
arten <- tribble(
  ~art,        ~art_de,
  "Adelie",    "Adeliepinguin",
  "Chinstrap", "Zügelpinguin",
  "Gentoo",    "Eselspinguin"
)
Ein Schlüssel (key) identifiziert jede Beobachtungseinheit eindeutig, etwa eine Personen-ID oder ein Artname.
Bevor man verknüpft, lohnt sich eine Probe mit anti_join(). Die Funktion gibt die Zeilen der linken Tabelle zurück, die rechts keinen Partner finden. Im Idealfall ist das Ergebnis leer:
pinguine |>
  anti_join(arten, by = c("art_lang" = "art")) |>
  nrow()
[1] 342Kein einziges Tier findet einen Partner. Der Grund ist die häufigste Stolperfalle beim Verknüpfen: Die Schlüssel passen nicht zusammen. In den Rohdaten steht "Adelie Penguin (Pygoscelis adeliae)", in der Tabelle der Kollegin nur "Adelie". Wir bilden deshalb einen passenden Schlüssel, indem wir mit word() das erste Wort des langen Namens herausziehen. Dabei greifen wir auf mutate() vor, das wir im nächsten Abschnitt genauer besprechen:
pinguine <- pinguine |>
  mutate(art = word(art_lang, 1))

pinguine |>
  anti_join(arten, by = "art") |>
  nrow()
[1] 0Jetzt passen alle Schlüssel, und wir können verknüpfen. Der Standardfall ist der left_join(). Er behält alle Zeilen der linken Tabelle und ergänzt die passenden Spalten von rechts; fehlt ein Schlüssel rechts, entsteht an dieser Stelle ein NA. Der große Vorteil: Die Fallzahl der linken Tabelle bleibt erhalten, solange der Schlüssel in der rechten Tabelle eindeutig ist.
n_vorher <- nrow(pinguine)

pinguine <- pinguine |>
  left_join(arten, by = "art", relationship = "many-to-one")

n_vorher; nrow(pinguine)
[1] 342[1] 342count(pinguine, art, art_de)# A tibble: 3 × 3
art art_de n
<chr> <chr> <int>
1 Adelie Adeliepinguin 151
2 Chinstrap Zügelpinguin 68
3 Gentoo Eselspinguin 123Das Argument relationship = "many-to-one" ist eine kleine Versicherung: Es teilt R mit, dass zu vielen Pinguinen jeweils genau eine Zeile in der Artentabelle gehören soll. Stünde eine Art dort versehentlich zweimal, würden sich die Zeilen beim Verknüpfen unbemerkt vervielfachen; mit dem Argument bricht R stattdessen mit einer Fehlermeldung ab.
Der left_join() ist nur das häufigste Mitglied einer ganzen Join-Familie, die sich darin unterscheidet, welche Zeilen sie behält:
left_join(): alle Zeilen der linken Tabelleinner_join(): nur Zeilen mit Übereinstimmung in beiden Tabellenfull_join(): alle Zeilen aus beiden Tabellenanti_join(): nur die Zeilen der linken Tabelle ohne Partner rechts
Faustregel: vor jedem Join anti_join(), nach jedem Join nrow().
Zusammengefasst lauern beim Verknüpfen drei typische Probleme: Schlüssel, die sich in Schreibweise oder Format unterscheiden ("P07" vs. "P007"), Schlüssel, die rechts nicht eindeutig sind, und Schlüsselspalten, die in beiden Tabellen unterschiedlich heißen, was man wie oben mit by = c("links" = "rechts") auflöst. Die Faustregel lautet deshalb: vor jedem Join mit anti_join() prüfen und nach jedem Join nrow() vergleichen.
3.5.6 Berechnen
mutate() legt neue Variablen an oder überschreibt bestehende. Der Name der neuen Variable steht links vom =, rechts steht eine Berechnung, die sich auf beliebige andere Spalten beziehen kann. Mehrere Berechnungen lassen sich in einem Aufruf erledigen, und spätere Berechnungen können auf frühere zugreifen:
pinguine |>
  mutate(
    masse_kg = masse_g / 1000,
    flosse_pro_kg = flosse_mm / masse_kg
  ) |>
  select(art, masse_g, masse_kg, flosse_pro_kg) |>
  head(3)
# A tibble: 3 × 4
art masse_g masse_kg flosse_pro_kg
<chr> <dbl> <dbl> <dbl>
1 Adelie 3750 3.75 48.3
2 Adelie 3800 3.8 48.9
3 Adelie 3250 3.25 60 case_when() prüft die Bedingungen von oben nach unten. Die erste zutreffende Bedingung gewinnt.
Eine besonders häufige Aufgabe ist das Umkodieren. Für Variablen mit zwei Ausprägungen genügt if_else(), für mehrere Ausprägungen ist case_when() das Mittel der Wahl. Die Bedingungen werden von oben nach unten geprüft, die erste zutreffende gewinnt, und .default fängt alles Übrige ab. So übersetzen wir die Geschlechtsangabe; alle anderen Einträge, auch fehlende oder unerwartete, werden zu NA:
pinguine <- pinguine |>
  mutate(
    geschlecht = case_when(
      geschlecht == "FEMALE" ~ "weiblich",
      geschlecht == "MALE"   ~ "männlich",
      .default = NA
    )
  )

count(pinguine, geschlecht)
# A tibble: 3 × 2
geschlecht n
<chr> <int>
1 männlich 168
2 weiblich 165
3 <NA> 9Mit case_when() lassen sich auch kontinuierliche Variablen in Kategorien einteilen. Wir teilen die Pinguine nach ihrem Körpergewicht in drei Gewichtsklassen ein. Weil die Bedingungen von oben nach unten geprüft werden, genügt für jede Klasse die obere Grenze. Eine Zeile, auf die keine Bedingung zutrifft, etwa weil der Wert fehlt, erhält ohne .default automatisch NA:
pinguine <- pinguine |>
  mutate(
    gewichtsklasse = case_when(
      masse_g < 3500 ~ "leicht",
      masse_g < 4500 ~ "mittel",
      masse_g >= 4500 ~ "schwer"
    )
  )

count(pinguine, gewichtsklasse)
# A tibble: 3 × 2
gewichtsklasse n
<chr> <int>
1 leicht 71
2 mittel 153
3 schwer 118Weil Texte in Tabellen und Grafiken alphabetisch sortiert werden, sollte man bei kategorialen Variablen die inhaltlich sinnvolle Reihenfolge festlegen, indem man sie mit factor() und definierten levels in einen Faktor umwandelt:
pinguine <- pinguine |>
  mutate(gewichtsklasse = factor(gewichtsklasse,
    levels = c("leicht", "mittel", "schwer")))

levels(pinguine$gewichtsklasse)
[1] "leicht" "mittel" "schwer"Ein z-Wert von 1 bedeutet: eine Standardabweichung über dem Mittelwert der eigenen Gruppe.
Manchmal soll eine Berechnung innerhalb von Gruppen erfolgen. Ein typisches Beispiel ist die z-Standardisierung, bei der man jeden Wert am Mittelwert und an der Standardabweichung seiner eigenen Gruppe relativiert. Mit dem Argument .by berechnet mutate() Mittelwert und Standardabweichung getrennt für jede Art, und das Ergebnis sagt dann, ob ein Pinguin für seine Art schwer oder leicht ist:
pinguine <- pinguine |>
  mutate(z_masse = (masse_g - mean(masse_g)) / sd(masse_g), .by = art)

pinguine |>
  select(art, masse_g, z_masse) |>
  head(3)
# A tibble: 3 × 3
art masse_g z_masse
<chr> <dbl> <dbl>
1 Adelie 3750 0.108
2 Adelie 3800 0.217
3 Adelie 3250 -0.983
TippSkalenwerte bei Fragebögen
In der Psychologie besteht das Berechnen häufig darin, aus mehreren Items einen Skalenwert zu bilden. Dafür kombiniert man rowMeans() mit across(), das dieselben Auswahlhilfen versteht wie select(). Negativ gepolte Items dreht man vorher um, bei einer Skala von 1 bis 5 etwa mit 6 - item:
befragung |>
  mutate(
    item_03 = 6 - item_03,     # negativ gepoltes Item umpolen
    skala   = rowMeans(across(starts_with("item")), na.rm = TRUE)
  )
3.5.7 Zusammenfassen
Beim Zusammenfassen geht Information verloren: Aus vielen Zeilen wird eine. Deshalb steht dieser Schritt am Ende.
Um von Einzelbeobachtungen zu Kennwerten zu gelangen, fasst man die Daten zusammen. summarise() berechnet aus vielen Zeilen eine Ergebniszeile; mit dem Argument .by geschieht das pro Gruppe. Die Funktion n() zählt dabei die Fälle je Gruppe:
pinguine |>
  summarise(
    n        = n(),
    m_masse  = mean(masse_g),
    sd_masse = sd(masse_g),
    .by = art_de
  )
# A tibble: 3 × 4
art_de n m_masse sd_masse
<chr> <int> <dbl> <dbl>
1 Adeliepinguin 151 3701. 459.
2 Eselspinguin 123 5076. 504.
3 Zügelpinguin 68 3733. 384.Dieselbe Auswertung finden Sie in vielen Skripten in der älteren Schreibweise mit einem vorangestellten group_by(art_de); das Ergebnis ist identisch. Zwei Details lohnen sich zu merken. Erstens liefert mean() als Ergebnis NA, sobald auch nur ein Wert fehlt; mit na.rm = TRUE werden fehlende Werte ignoriert. Bei den Pinguinen haben wir diese Fälle bereits ausgeschlossen, bei den Isotopenwerten fehlen aber noch einige. Zweitens lohnt es sich, bei jeder Zusammenfassung die Fallzahl mitzuberichten, denn Mittelwerte aus drei Beobachtungen sind wenig belastbar. Beides lässt sich an den Isotopenwerten zeigen. Wir fassen nach Art und Insel zusammen und sortieren mit arrange() aufsteigend nach der Fallzahl. Ohne na.rm = TRUE ist der Mittelwert in allen Gruppen mit fehlenden Werten NA, und die Gruppen sind sehr unterschiedlich groß:
pinguine |>
  summarise(
    n         = n(),
    m_d15n    = mean(d15n),
    m_d15n_rm = mean(d15n, na.rm = TRUE),
    .by = c(art_de, insel)
  ) |>
  arrange(n)
# A tibble: 5 × 5
art_de insel n m_d15n m_d15n_rm
<chr> <chr> <int> <dbl> <dbl>
1 Adeliepinguin Biscoe 44 8.82 8.82
2 Adeliepinguin Torgersen 51 NA 8.79
3 Adeliepinguin Dream 56 NA 8.95
4 Zügelpinguin Dream 68 NA 9.36
5 Eselspinguin Biscoe 123 NA 8.25Mit desc() sortiert arrange() absteigend, etwa arrange(desc(n)).
Immer die Fallzahl mitberichten. Ein Mittelwert aus drei Beobachtungen ist wenig belastbar.
Wer nur zählen möchte, kommt mit count() aus, das wir schon beim Sichten verwendet haben; es lässt sich auch nach mehreren Variablen gleichzeitig aufschlüsseln:
count(pinguine, art_de, geschlecht)# A tibble: 8 × 3
art_de geschlecht n
<chr> <chr> <int>
1 Adeliepinguin männlich 73
2 Adeliepinguin weiblich 73
3 Adeliepinguin <NA> 5
4 Eselspinguin männlich 61
5 Eselspinguin weiblich 58
6 Eselspinguin <NA> 4
7 Zügelpinguin männlich 34
8 Zügelpinguin weiblich 34pivot_longer(): aus Spalten werden Zeilen. pivot_wider(): aus Zeilen werden Spalten.
Damit kommen wir zu der im konzeptuellen Teil angekündigten Umformung zwischen wide und long. Möchte man mehrere Variablen auf einmal zusammenfassen, bringt man sie zuerst mit pivot_longer() in die lange Form: Aus den drei Maßspalten wird eine Spalte mass mit dem Namen des Maßes und eine Spalte wert mit dem Messwert. Danach genügt ein einziges summarise() für alle Maße:
pinguine_lang <- pinguine |>
  pivot_longer(
    cols = c(schnabel_mm, flosse_mm, masse_g),
    names_to = "mass",
    values_to = "wert"
  )

pinguine_lang |>
  summarise(m = mean(wert), .by = c(art_de, mass))
# A tibble: 9 × 3
art_de mass m
<chr> <chr> <dbl>
1 Adeliepinguin schnabel_mm 38.8
2 Adeliepinguin flosse_mm 190.
3 Adeliepinguin masse_g 3701.
4 Eselspinguin schnabel_mm 47.5
5 Eselspinguin flosse_mm 217.
6 Eselspinguin masse_g 5076.
7 Zügelpinguin schnabel_mm 48.8
8 Zügelpinguin flosse_mm 196.
9 Zügelpinguin masse_g 3733. Das Ergebnis ist tidy, aber als Tabelle für einen Bericht unpraktisch. pivot_wider() macht aus den Werten einer Spalte wieder eigene Spalten und ist damit die Umkehrung von pivot_longer(). So entsteht eine kompakte Tabelle mit einer Zeile pro Art und einer Spalte pro Maß:
pinguine_lang |>
  summarise(m = round(mean(wert), 1), .by = c(art_de, mass)) |>
  pivot_wider(names_from = mass, values_from = m)
# A tibble: 3 × 4
art_de schnabel_mm flosse_mm masse_g
<chr> <dbl> <dbl> <dbl>
1 Adeliepinguin 38.8 190 3701.
2 Eselspinguin 47.5 217. 5076
3 Zügelpinguin 48.8 196. 3733.3.5.8 Übersichtstabellen mit compareGroups
Die „Tabelle 1” beschreibt in fast jeder empirischen Arbeit die Stichprobe, meist getrennt nach Gruppen.
Für die in fast jeder Publikation übliche „Tabelle 1”, also alle wichtigen Variablen nach Gruppen aufgeschlüsselt mit passenden Kennwerten und Signifikanztests, muss man die Schritte aus dem vorigen Abschnitt nicht von Hand zusammenbauen. Das Paket compareGroups erledigt das in zwei Schritten: compareGroups() berechnet, createTable() formatiert. Die Auswahl der Variablen erfolgt über die Formel-Schreibweise Gruppe ~ Variablen:
library(compareGroups)

compareGroups(art_de ~ masse_g + flosse_mm + geschlecht + d15n,
              data = pinguine) |>
  createTable(show.n = TRUE)
--------Summary descriptives table by 'art_de'---------

__________________________________________________________________
             Adeliepinguin Eselspinguin Zügelpinguin p.overall  N
                 N=151        N=123         N=68
¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯
masse_g       3701 (459)    5076 (504)   3733 (384)   <0.001   342
flosse_mm     190 (6.54)    217 (6.48)   196 (7.13)   <0.001   342
geschlecht:                                            0.976   333
    männlich  73 (50.0%)    61 (51.3%)   34 (50.0%)
    weiblich  73 (50.0%)    58 (48.7%)   34 (50.0%)
d15n          8.86 (0.43)  8.25 (0.26)  9.36 (0.37)   <0.001   330
¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯¯
Über weitere Optionen lässt sich die Tabelle anpassen, etwa method = c(d15n = 2) für Median und Interquartilsabstand statt Mittelwert und Standardabweichung. Für den Export gibt es export2word(), export2latex() und export2md().
Hinweis
compareGroups ist ein Zusatzpaket, das Sie ggf. einmalig mit install.packages("compareGroups") installieren müssen.
3.5.9 Der ganze Workflow in einer Kette
Ein Skript, das von der Rohdatei bis zum Ergebnis durchläuft, ist die beste Dokumentation Ihrer Datenaufbereitung.
Zum Abschluss lassen sich alle Schritte zu einer einzigen, von oben nach unten lesbaren Kette verbinden. Genau darin liegt die Stärke des Ansatzes: ein Skript, in dem jeder Schritt sichtbar und reproduzierbar ist, von der Rohdatei bis zum analysefertigen Datensatz.
pinguine_analyse <- read_csv(path_to_file("penguins_raw.csv"),
                             show_col_types = FALSE) |>      # einlesen
  filter(!is.na(`Body Mass (g)`)) |>                          # filtern
  select(art_lang    = Species,                               # auswählen
         insel       = Island,
         flosse_mm   = `Flipper Length (mm)`,
         masse_g     = `Body Mass (g)`,
         geschlecht  = Sex) |>
  mutate(art = word(art_lang, 1)) |>
  left_join(arten, by = "art",                                # verknüpfen
            relationship = "many-to-one") |>
  mutate(                                                     # berechnen
    geschlecht = case_when(geschlecht == "FEMALE" ~ "weiblich",
                           geschlecht == "MALE"   ~ "männlich",
                           .default = NA),
    z_masse = (masse_g - mean(masse_g)) / sd(masse_g),
    .by = art
  )

pinguine_analyse |>                                           # zusammenfassen
  summarise(n = n(), m_masse = mean(masse_g), .by = c(art_de, geschlecht)) |>
  arrange(art_de, geschlecht)
# A tibble: 8 × 4
art_de geschlecht n m_masse
<chr> <chr> <int> <dbl>
1 Adeliepinguin männlich 73 4043.
2 Adeliepinguin weiblich 73 3369.
3 Adeliepinguin <NA> 5 3540
4 Eselspinguin männlich 61 5485.
5 Eselspinguin weiblich 58 4680.
6 Eselspinguin <NA> 4 4588.
7 Zügelpinguin männlich 34 3939.
8 Zügelpinguin weiblich 34 3527.Diese Kette ist die praktische Umsetzung von allem, was der konzeptuelle Teil gefordert hat: Die Rohdatei bleibt unberührt, das Ergebnis entsteht als neues Objekt, und jeder einzelne Schritt, vom Ausschluss über die Verknüpfung bis zur Umkodierung, steht dokumentiert im Skript und kann im Bericht nachvollziehbar beschrieben werden.
3.6 Fazit
- Datenmanagement ist keine lästige Fleißaufgabe am Rande, sondern entscheidet über die Reproduzierbarkeit und damit über die Glaubwürdigkeit einer Studie. Der Fall Reinhart-Rogoff zeigt, wie ein einziger undokumentierter Handgriff eine ganze Debatte verzerren kann.
- Die tragenden Prinzipien sind schnell benannt: Rohdaten bleiben unantastbar, jede Transformation passiert im Skript, und die Zielstruktur ist tidy — eine Variable pro Spalte, eine Beobachtung pro Zeile.
- Auffällige Daten sollte man identifizieren und ggf. ausschließen — aber die Kriterien gehören vorab festgelegt, sonst wird aus Datenhygiene unversehens p-hacking.
- Die Aufbereitung folgt einer festen Abfolge: einlesen → sichten → filtern → auswählen → verknüpfen → berechnen → zusammenfassen. Im
tidyversegibt es für jeden Schritt ein eigenes Verb (read_csv,glimpse,filter,select,*_join,mutate,summarise), und über die Pipe|>verketten sie sich zu einem lesbaren, von oben nach unten nachvollziehbaren Workflow. - Prüfen Sie nach jedem Schritt, was Sie erwarten:
nrow(),count()undsummary()decken die meisten stillen Fehler sofort auf.
3.6.1 Vertiefung
Wenn Sie tiefer in die praktische Datenaufbereitung einsteigen möchten, führt kein Weg an R for Data Science von Wickham, Çetinkaya-Rundel und Grolemund vorbei — insbesondere die frei verfügbaren Kapitel zu Data transformation und Data tidying decken genau die hier vorgestellten Verben vertiefend ab. Die konzeptuelle Grundlage des tidy-Ansatzes legt Wickhams ursprüngliche Arbeit zu Tidy Data dar (Wickham, 2014). Wer sich für die forensische Seite begeistert, findet auf dem Blog Data Colada (datacolada.org) die Originalanalysen zu den oben erwähnten Fällen; eine gut lesbare Einführung in die Fallstricke flexibler Datenauswertung bietet der Klassiker von Simmons, Nelson und Simonsohn (2011). Und wer seine Daten am Ende teilen möchte, orientiert sich an den FAIR-Prinzipien (Wilkinson et al., 2016) und an den Datenmanagement-Vorgaben der eigenen Förderorganisation.
Es gibt auch einen sehr interessante Podcast-Folge Freakonomics No.163: The Data Sleuth Taking on Shoddy Science, in dem der Fall aufgearbeitet wird.